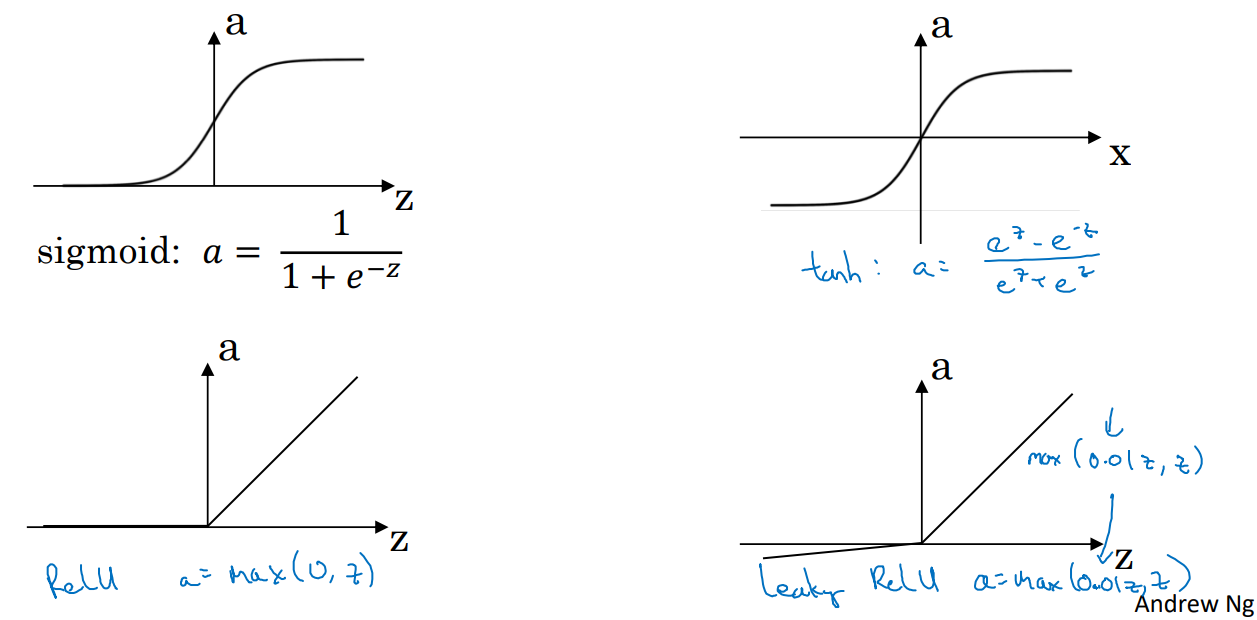
SkillOpt-Sleep 실제 평가 - 점수는 올랐지만 스킬은 좋아지지 않았다
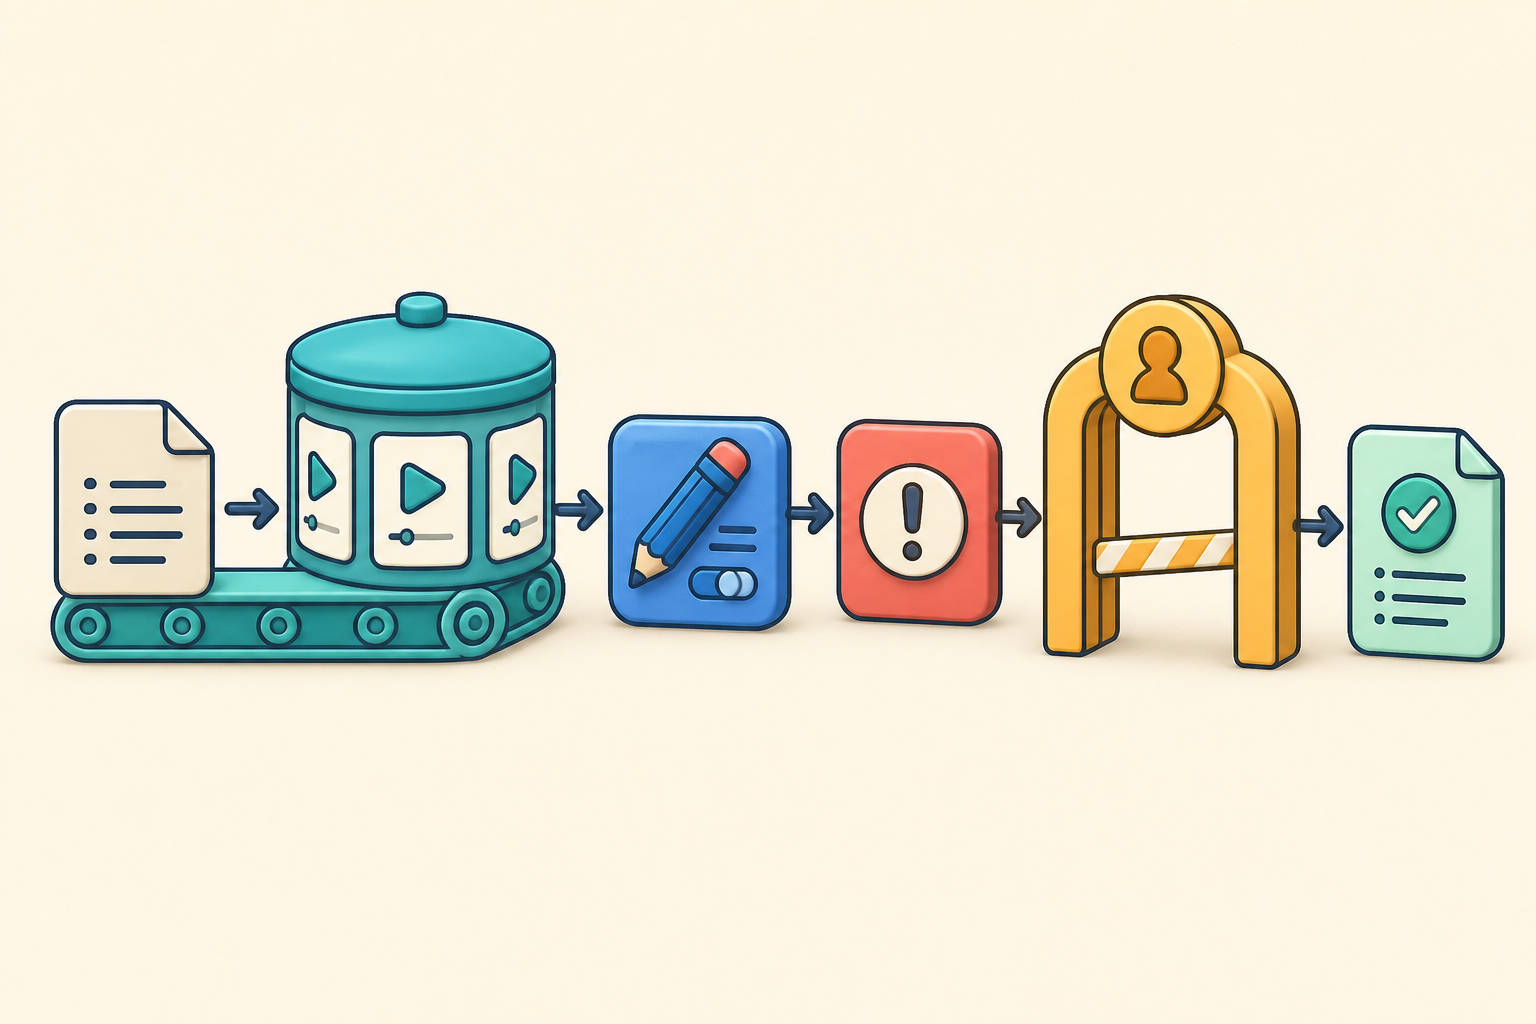
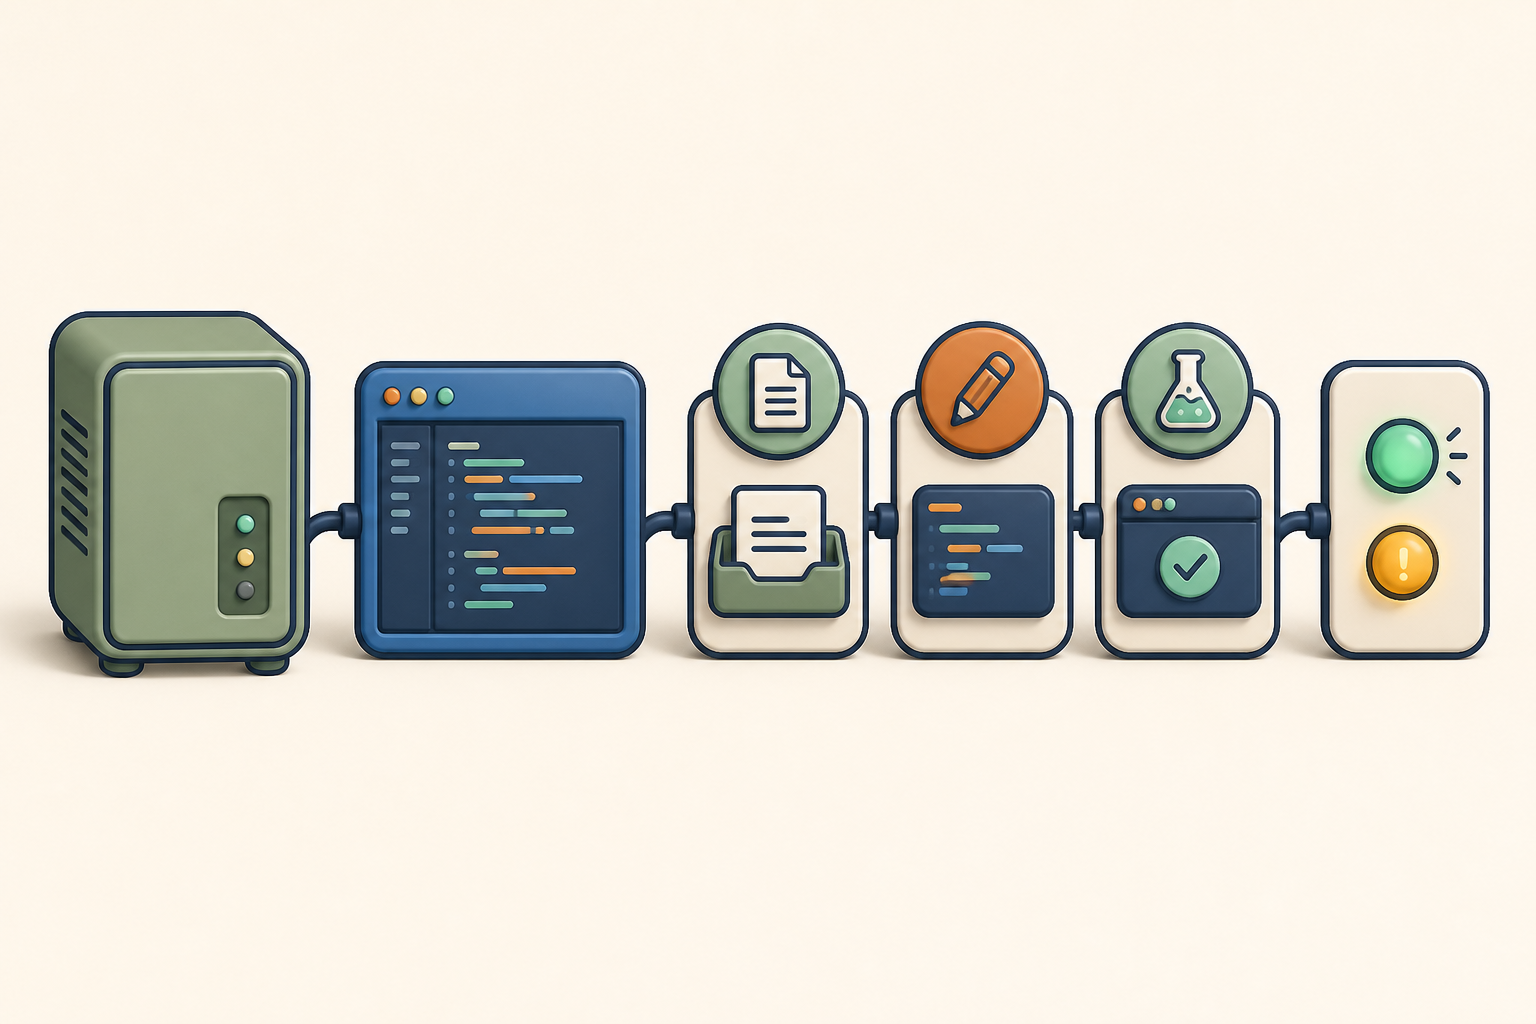
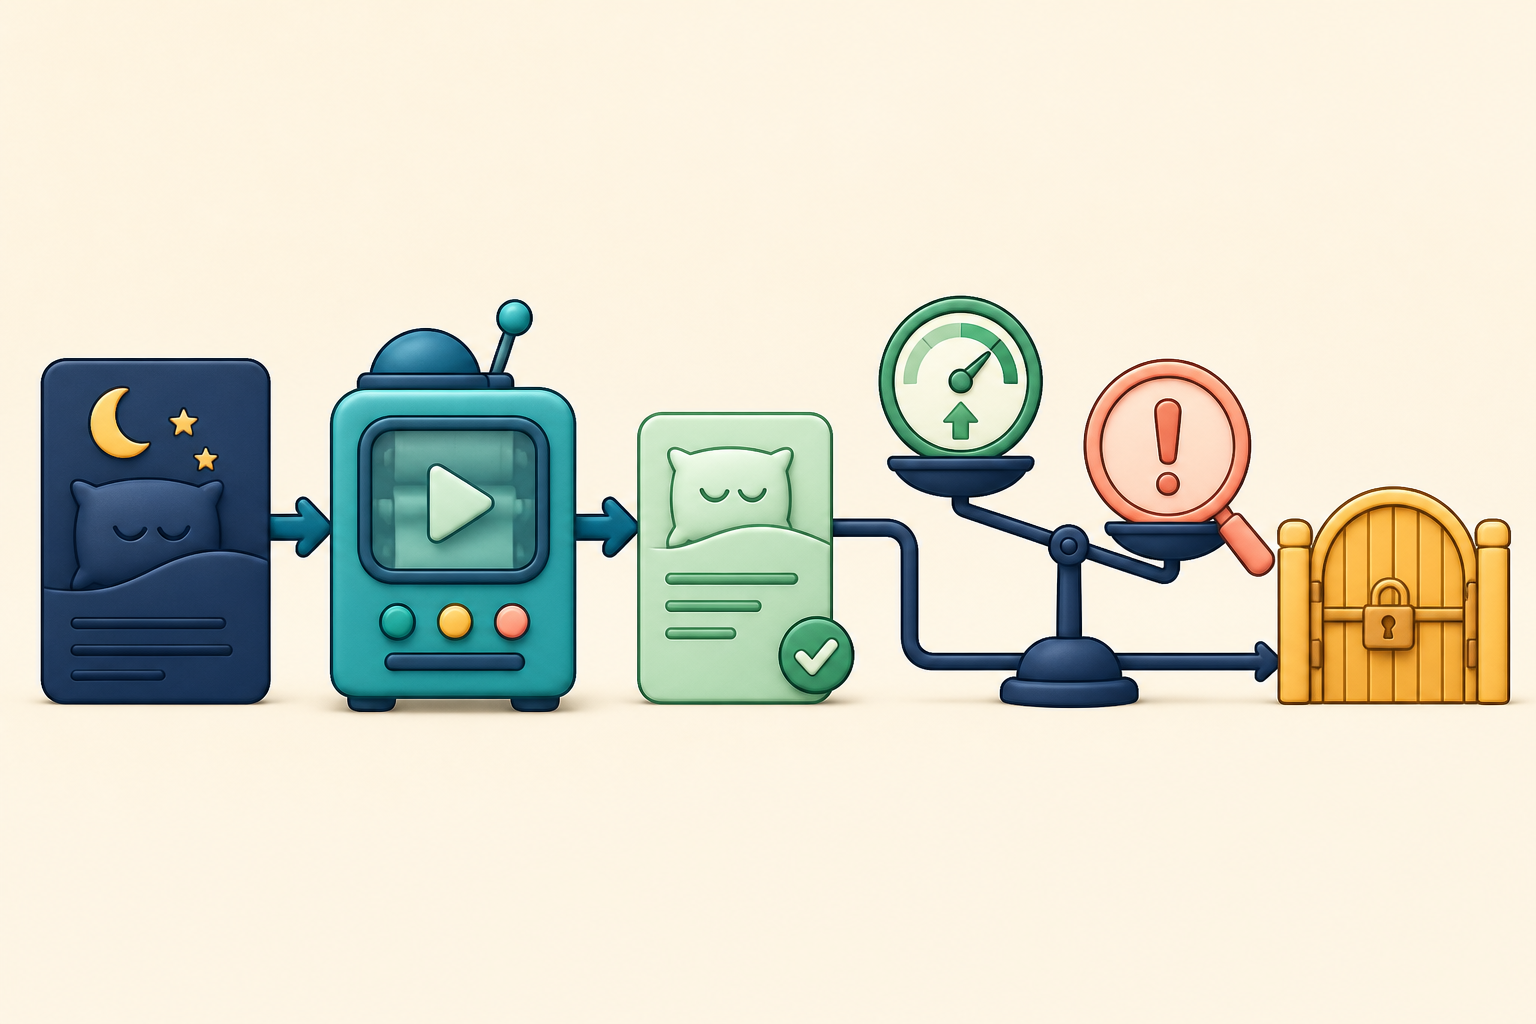
SkillOpt-Sleep을 실제 코딩 에이전트의 작업형 skill에 연결해 전체 사이클을 돌려봤다. 세션 수집부터 후보 규칙 생성, held-out gate, staging과 수동 적용까지 pipeline은 정상 작동했다.
SkillOpt-Sleep을 실제 코딩 에이전트의 작업형 skill에 연결해 전체 사이클을 돌려봤다. 세션 수집부터 후보 규칙 생성, held-out gate, staging과 수동 적용까지 pipeline은 정상 작동했다.
SkillOpt를 설치하면 두 가지 경로를 선택할 수 있다. 연구용 trainer는 benchmark를 준비해 skill 문서 전체를 훈련하고, SkillOpt-Sleep은 코딩 에이전트의 과거 세션에서 작은 개선 규칙을 제안한다.
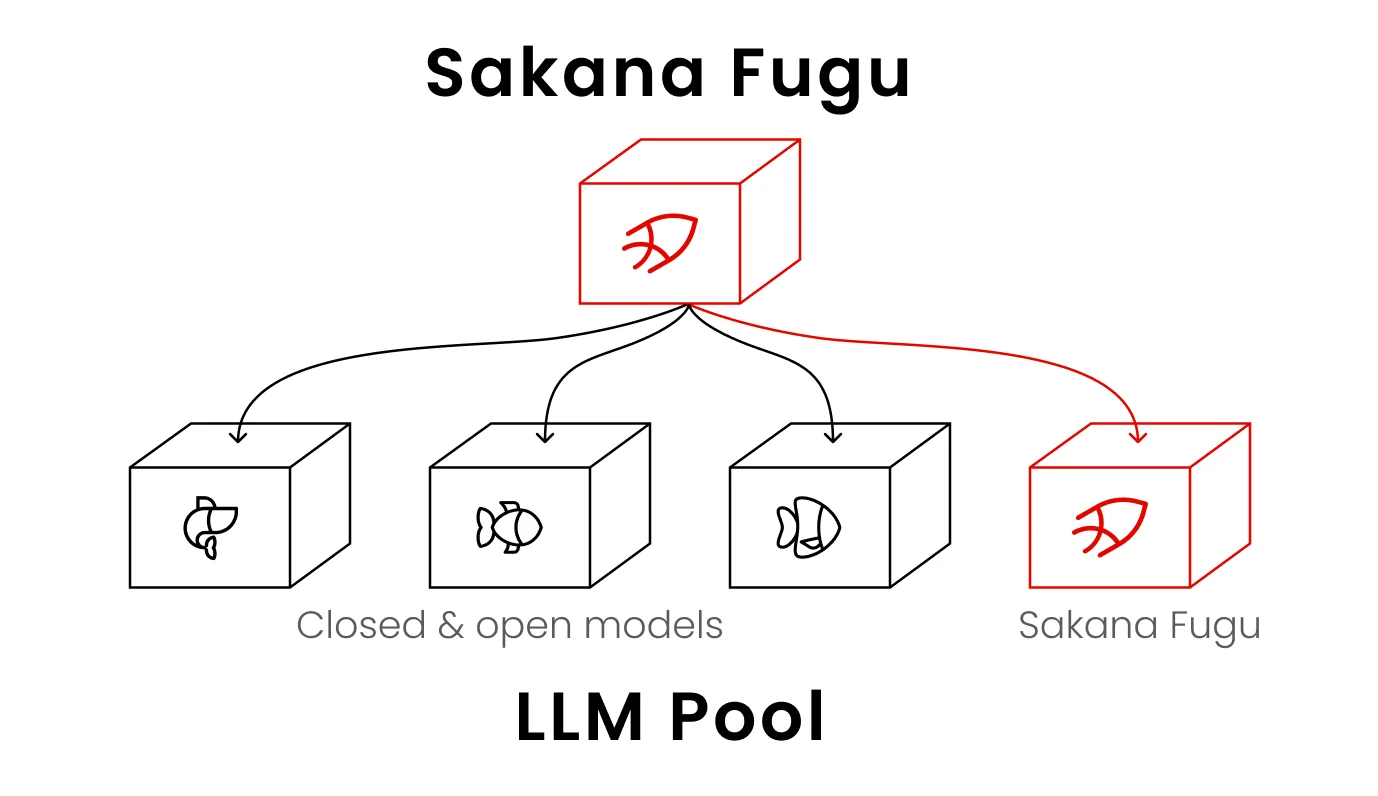
Sakana Fugu는 일본산 단일 프론티어 LLM이 아니다. 하나의 모델처럼 호출하지만 내부에서는 여러 모델에 역할을 나누고 결과를 검증·합성하는 learned orchestration system이다.
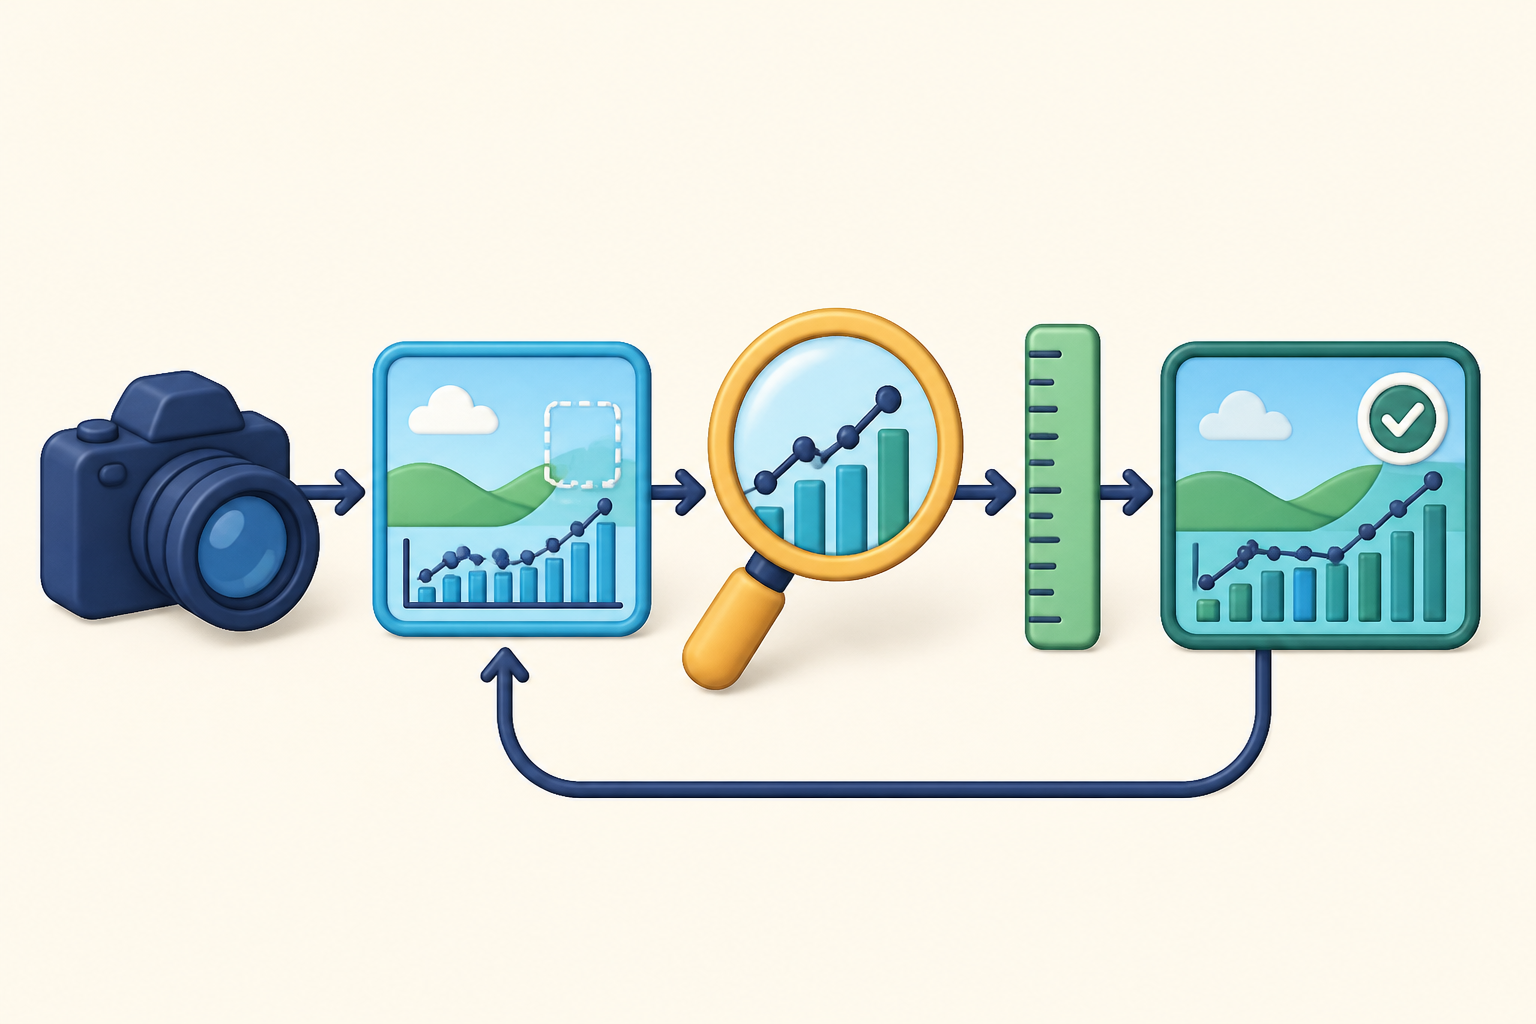
멀티모달 모델은 이미지를 보고 답할 수 있지만, 작은 글자나 복잡한 그래프를 한 번에 정확히 읽지는 못한다. 한눈에 보이지 않는 부분을 확률적으로 메우면 그럴듯한 오답이 생긴다.
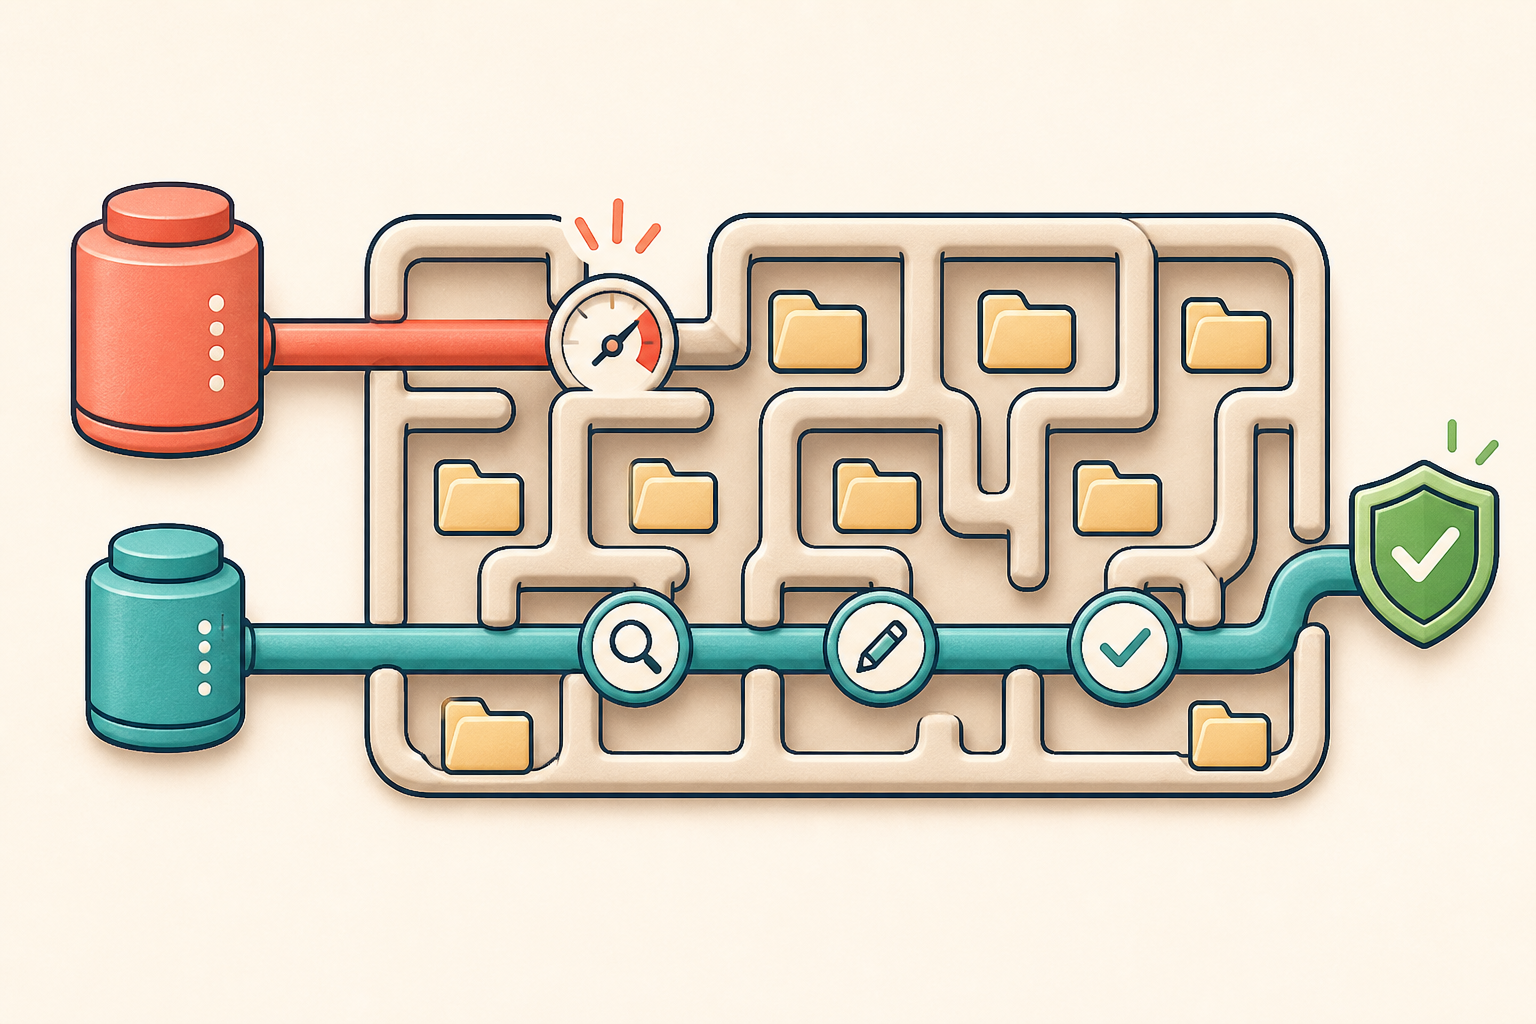
로컬 모델이 코드를 잘 생성하는지와 coding agent로 저장소를 안전하게 다루는지는 다른 문제다. OpenCode에 LM Studio provider를 고정하고 모델만 바꿔, 파일 탐색과 근거 해석이 필요한 같은 과제를 반복했다.
Ollama는 로컬 모델을 Codex App의 provider로 연결하는 명령을 제공한다. 앱 화면은 그대로 사용하면서 실제 응답은 로컬 모델이 만든다.
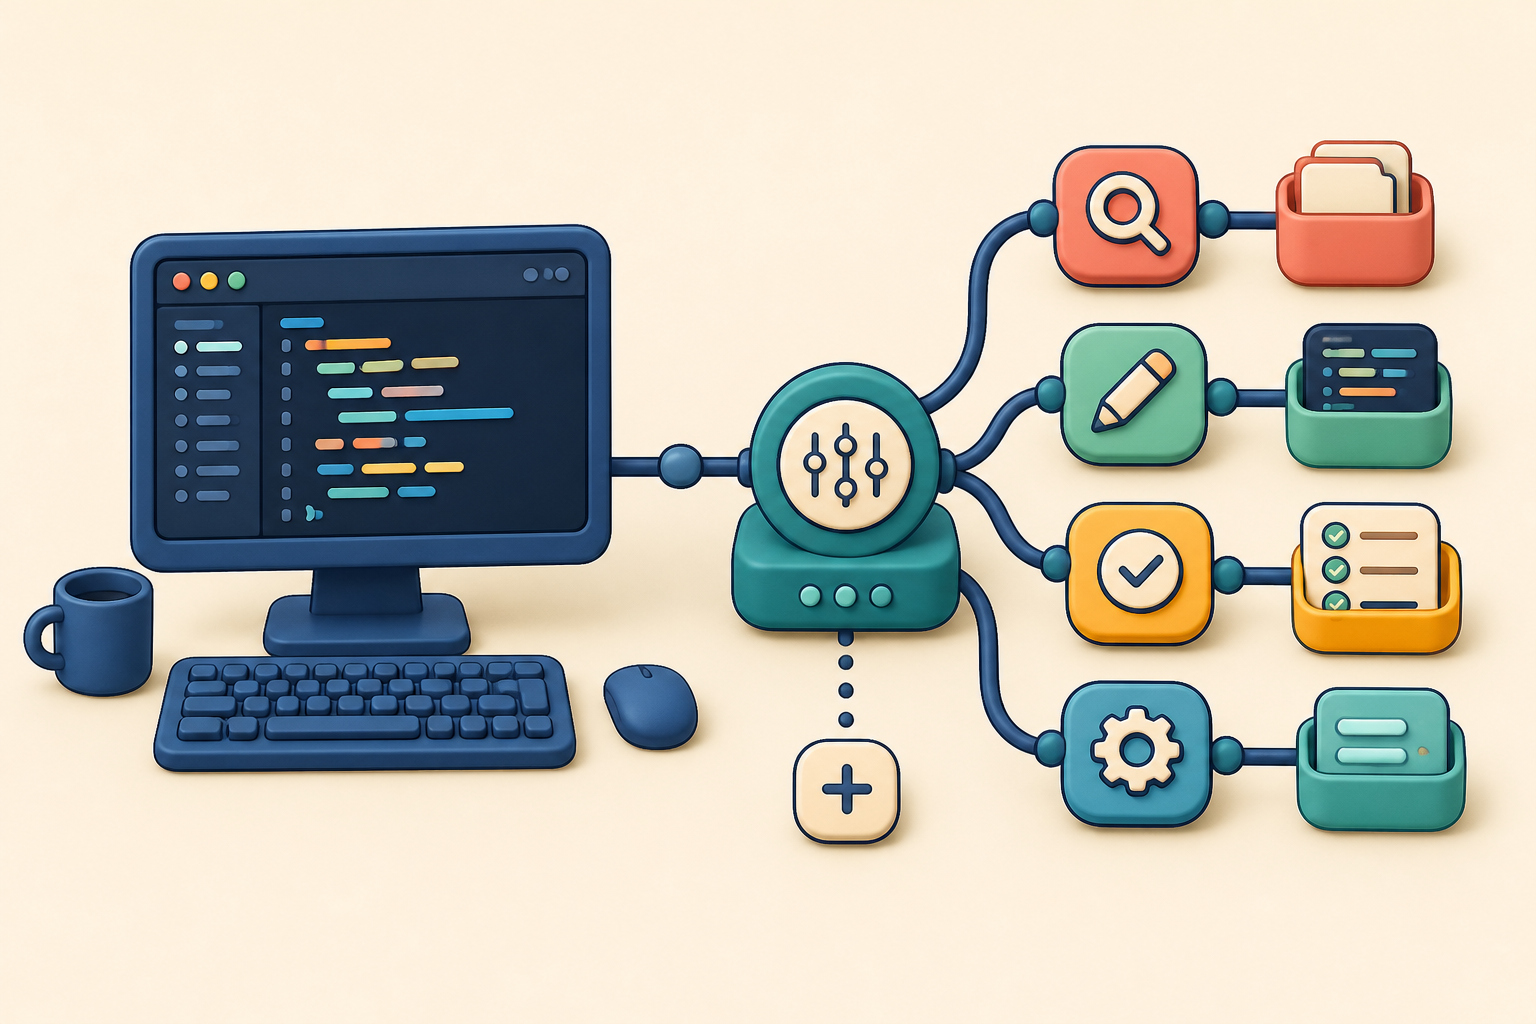
OpenCode와 Oh My OpenAgent(OMO)를 함께 소개하는 글을 보면 둘의 경계가 흐리게 느껴진다. OpenCode는 모델이 파일과 터미널 도구를 사용하는 코딩 에이전트 런타임이고, OMO는 그 위에 역할 분담과 작업 루프를 얹는 플러그인형 오케스트레이션 레이어다.
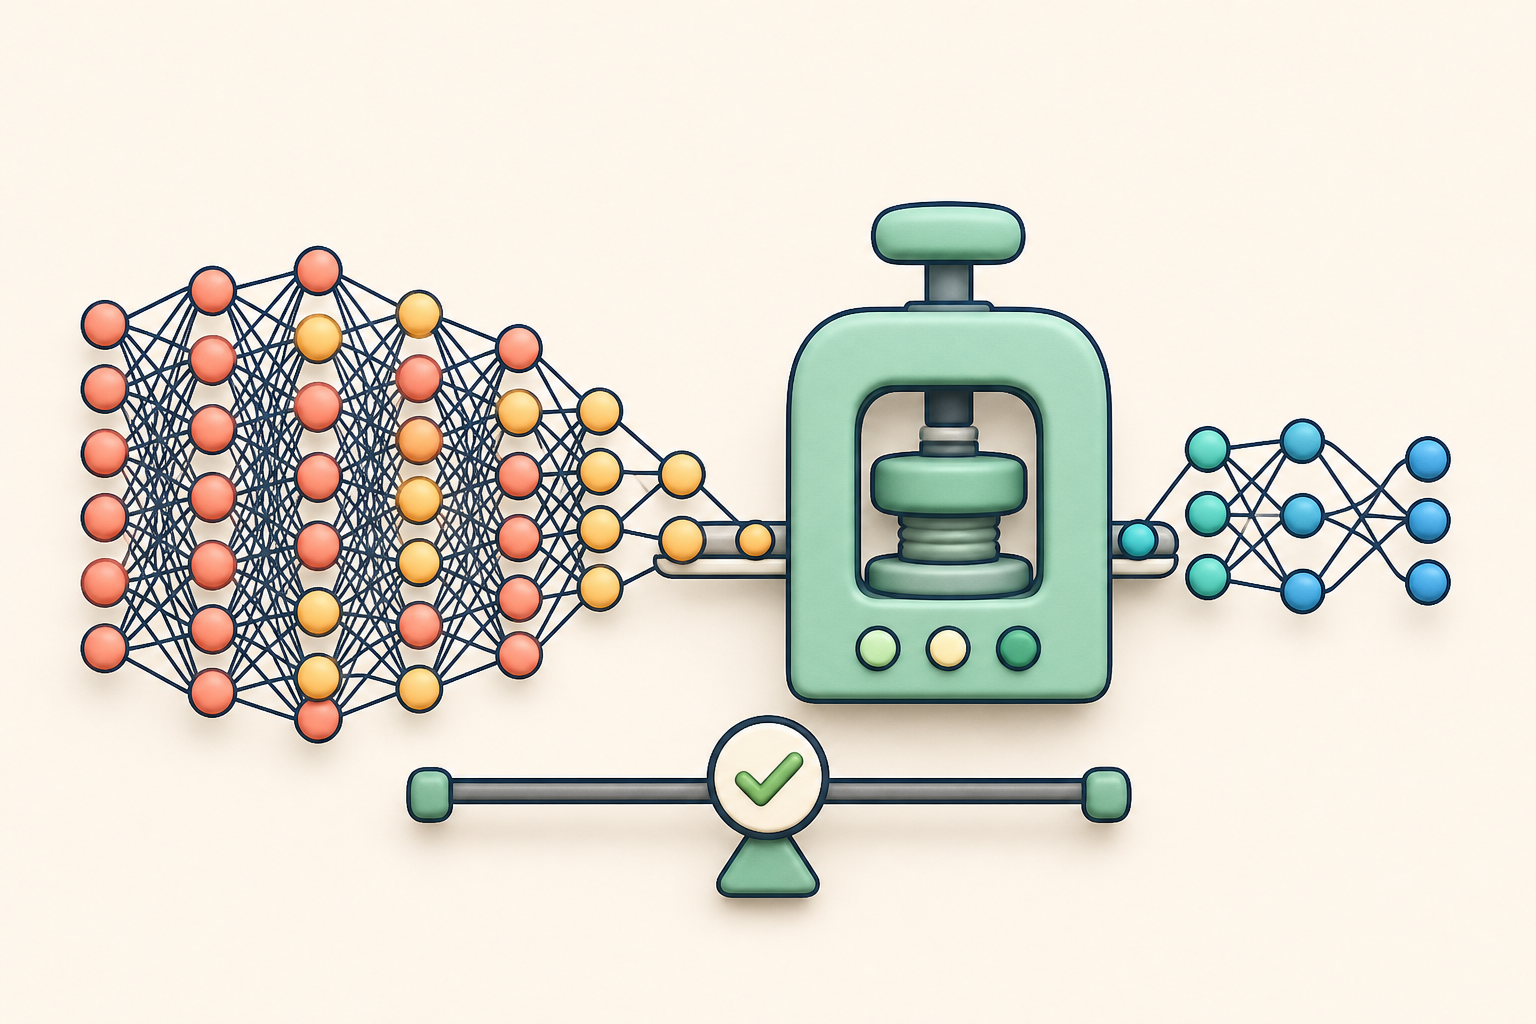
로컬 LLM은 같은 모델도 BF16, Q8, Q4에 따라 필요한 메모리와 품질이 크게 달라진다. 4비트로 줄이면 실행 가능한 모델의 체급이 올라가지만, 압축 과정에서 다음 토큰 확률분포가 흔들릴 수 있다.
llama.cpp는 GGUF 모델을 직접 실행하는 로컬 추론 런타임이다. Ollama처럼 모델 관리를 감싸기보다 모델 파일, quantization, context, sampling, 서버 포트를 명령으로 직접 제어한다.
LM Studio는 로컬 LLM을 검색하고 내려받아 실행하는 데스크톱 앱이다. 모델 파일과 quantization을 GUI에서 고를 수 있고, 내려받은 모델을 OpenAI 호환 API 서버로 띄울 수도 있다.
Ollama, LM Studio, llama.cpp는 모두 로컬 모델을 실행하고 OpenAI 호환 API로 노출할 수 있다. 같은 GGUF 계열 모델을 띄울 수 있어도 사용 목적과 제어 범위는 꽤 다르다.
Ollama는 로컬 LLM을 내려받고 실행하며, 다른 앱이 사용할 수 있는 API 서버까지 함께 제공한다. 모델 파일과 실행 옵션을 직접 다루는 llama.cpp보다 시작이 쉽고, GUI 중심인 LM Studio보다 터미널 자동화에 잘 맞는다.
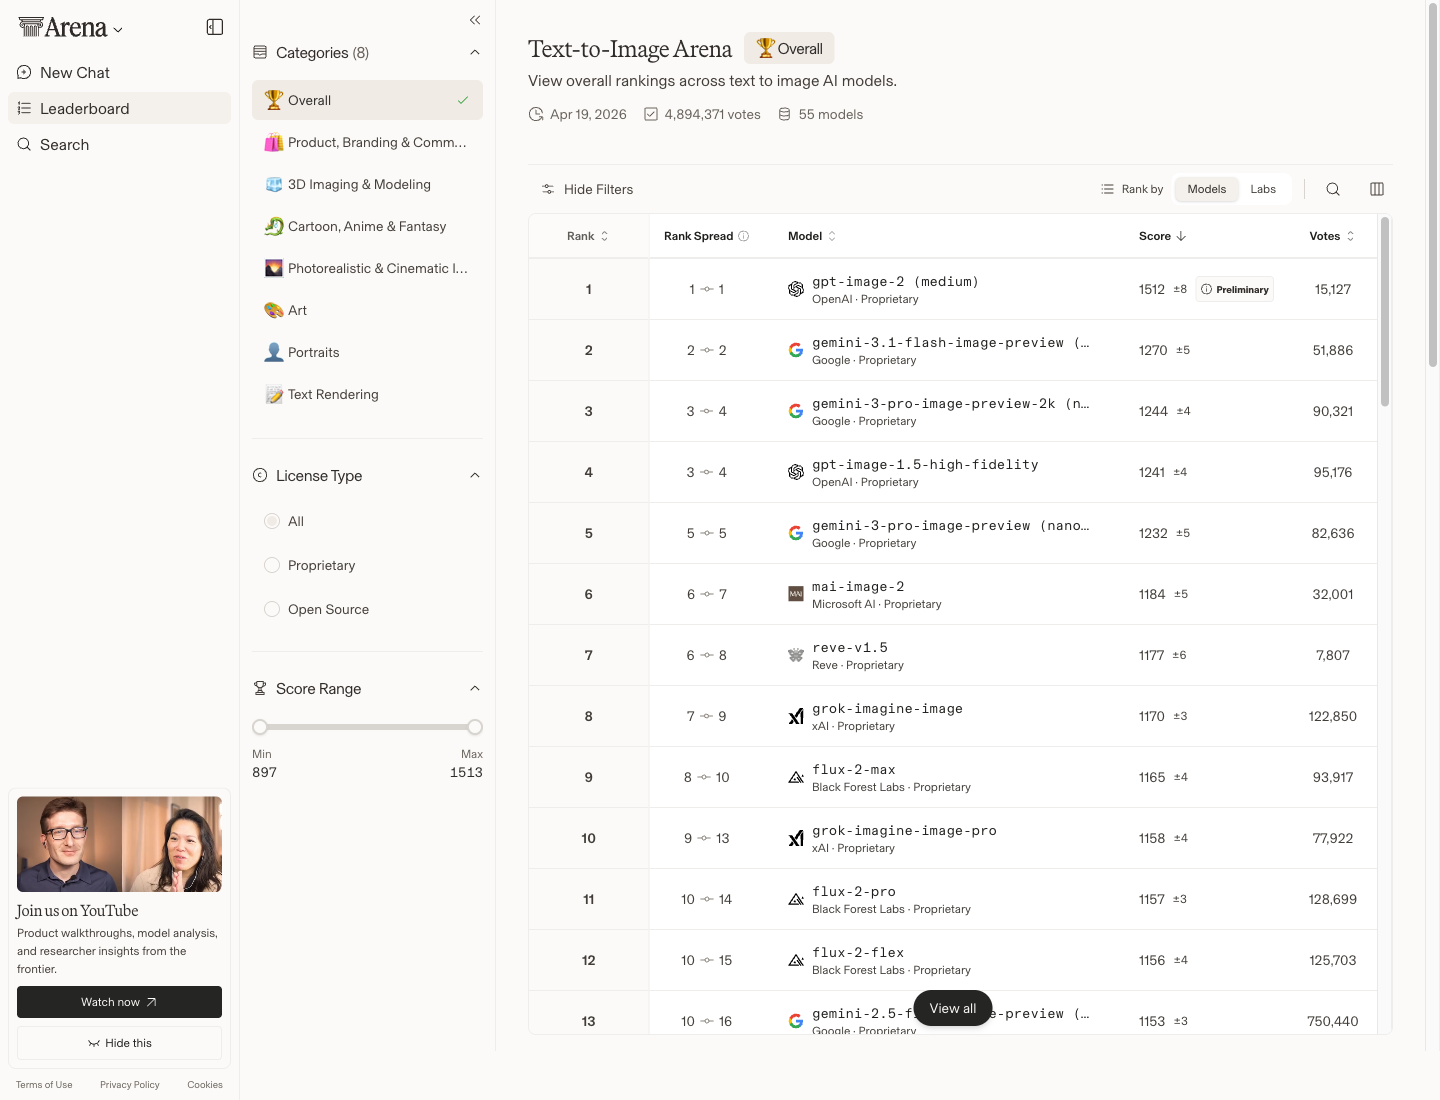
OpenAI가 ChatGPT Images 2.0(모델 ID gpt-image-2)을 공개했다. 이미지 생성의 약점이던 텍스트·다국어·일관성을 크게 끌어올리고, 대화형 편집과 프롬프트 재작성까지 하나의 흐름으로 묶은 OpenAI의 새 이미지 생성 모델이다.
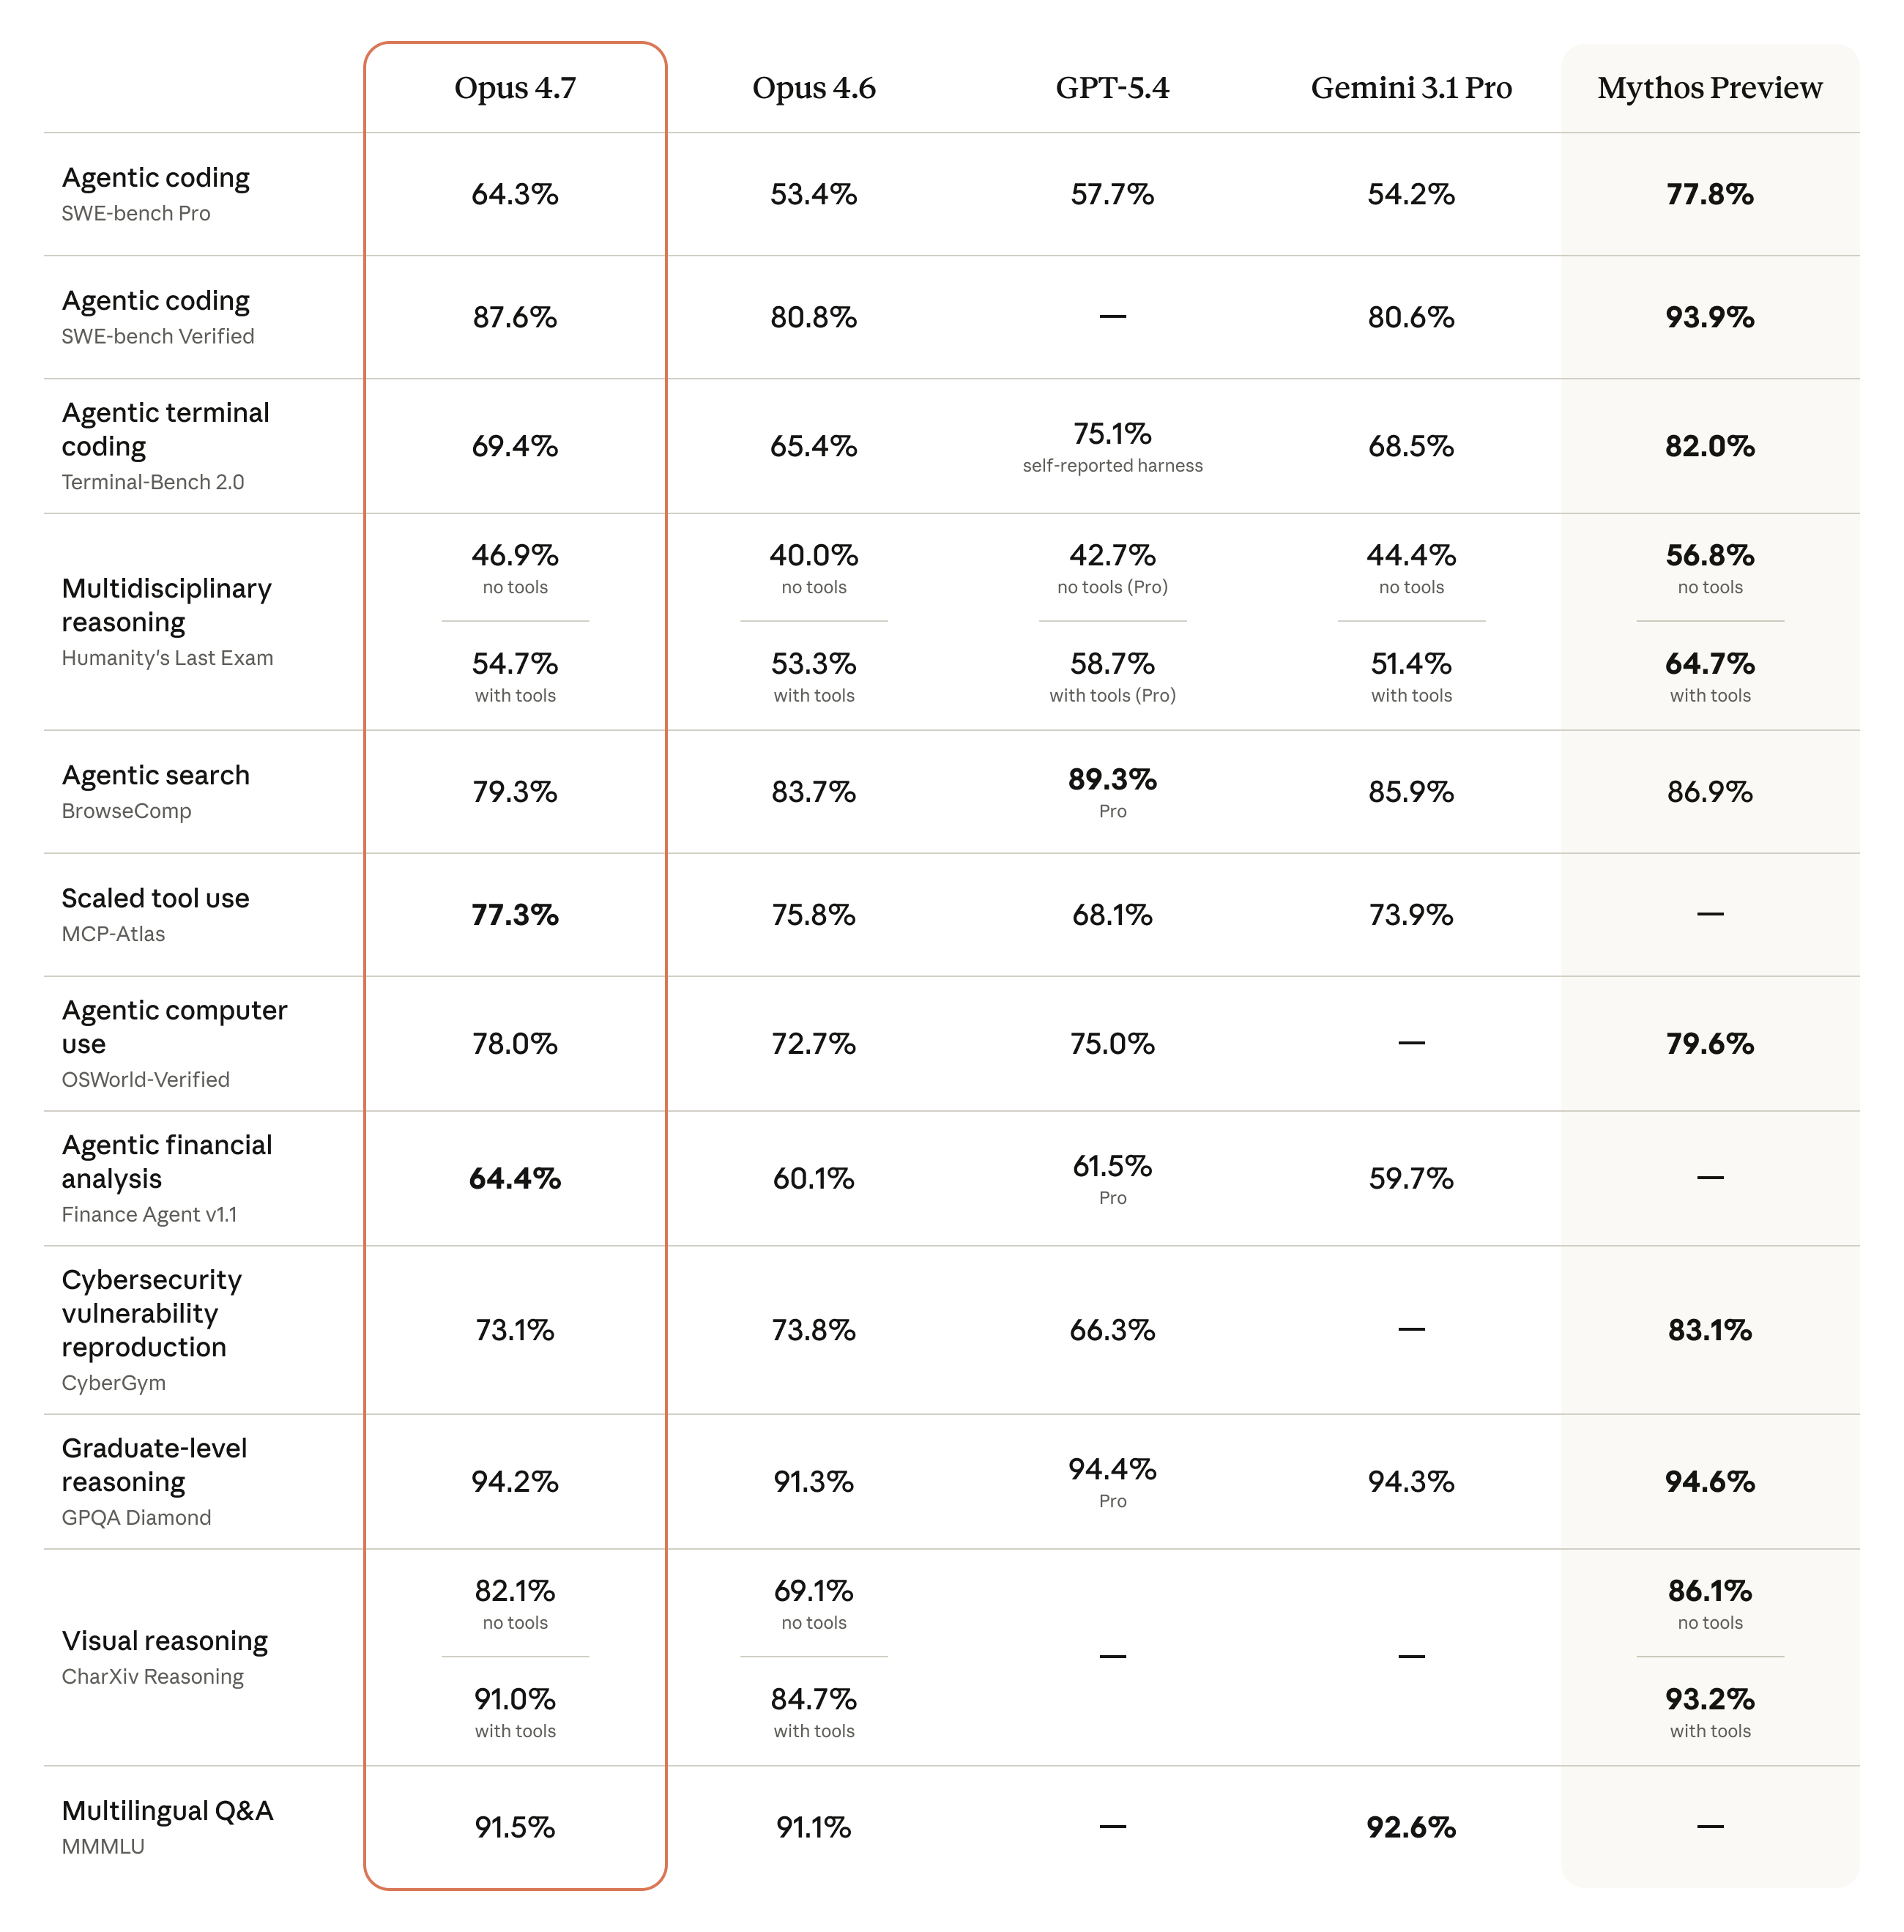
Anthropic이 Claude Opus 4.7을 공개했다. 답변 품질을 조금 올린 챗봇 업데이트가 아니라, 코딩 에이전트, 장기 업무 위임, 고해상도 비전, 엄격한 지시 이행을 축으로 개선된 Anthropic의 최상위 공개 모델이다.
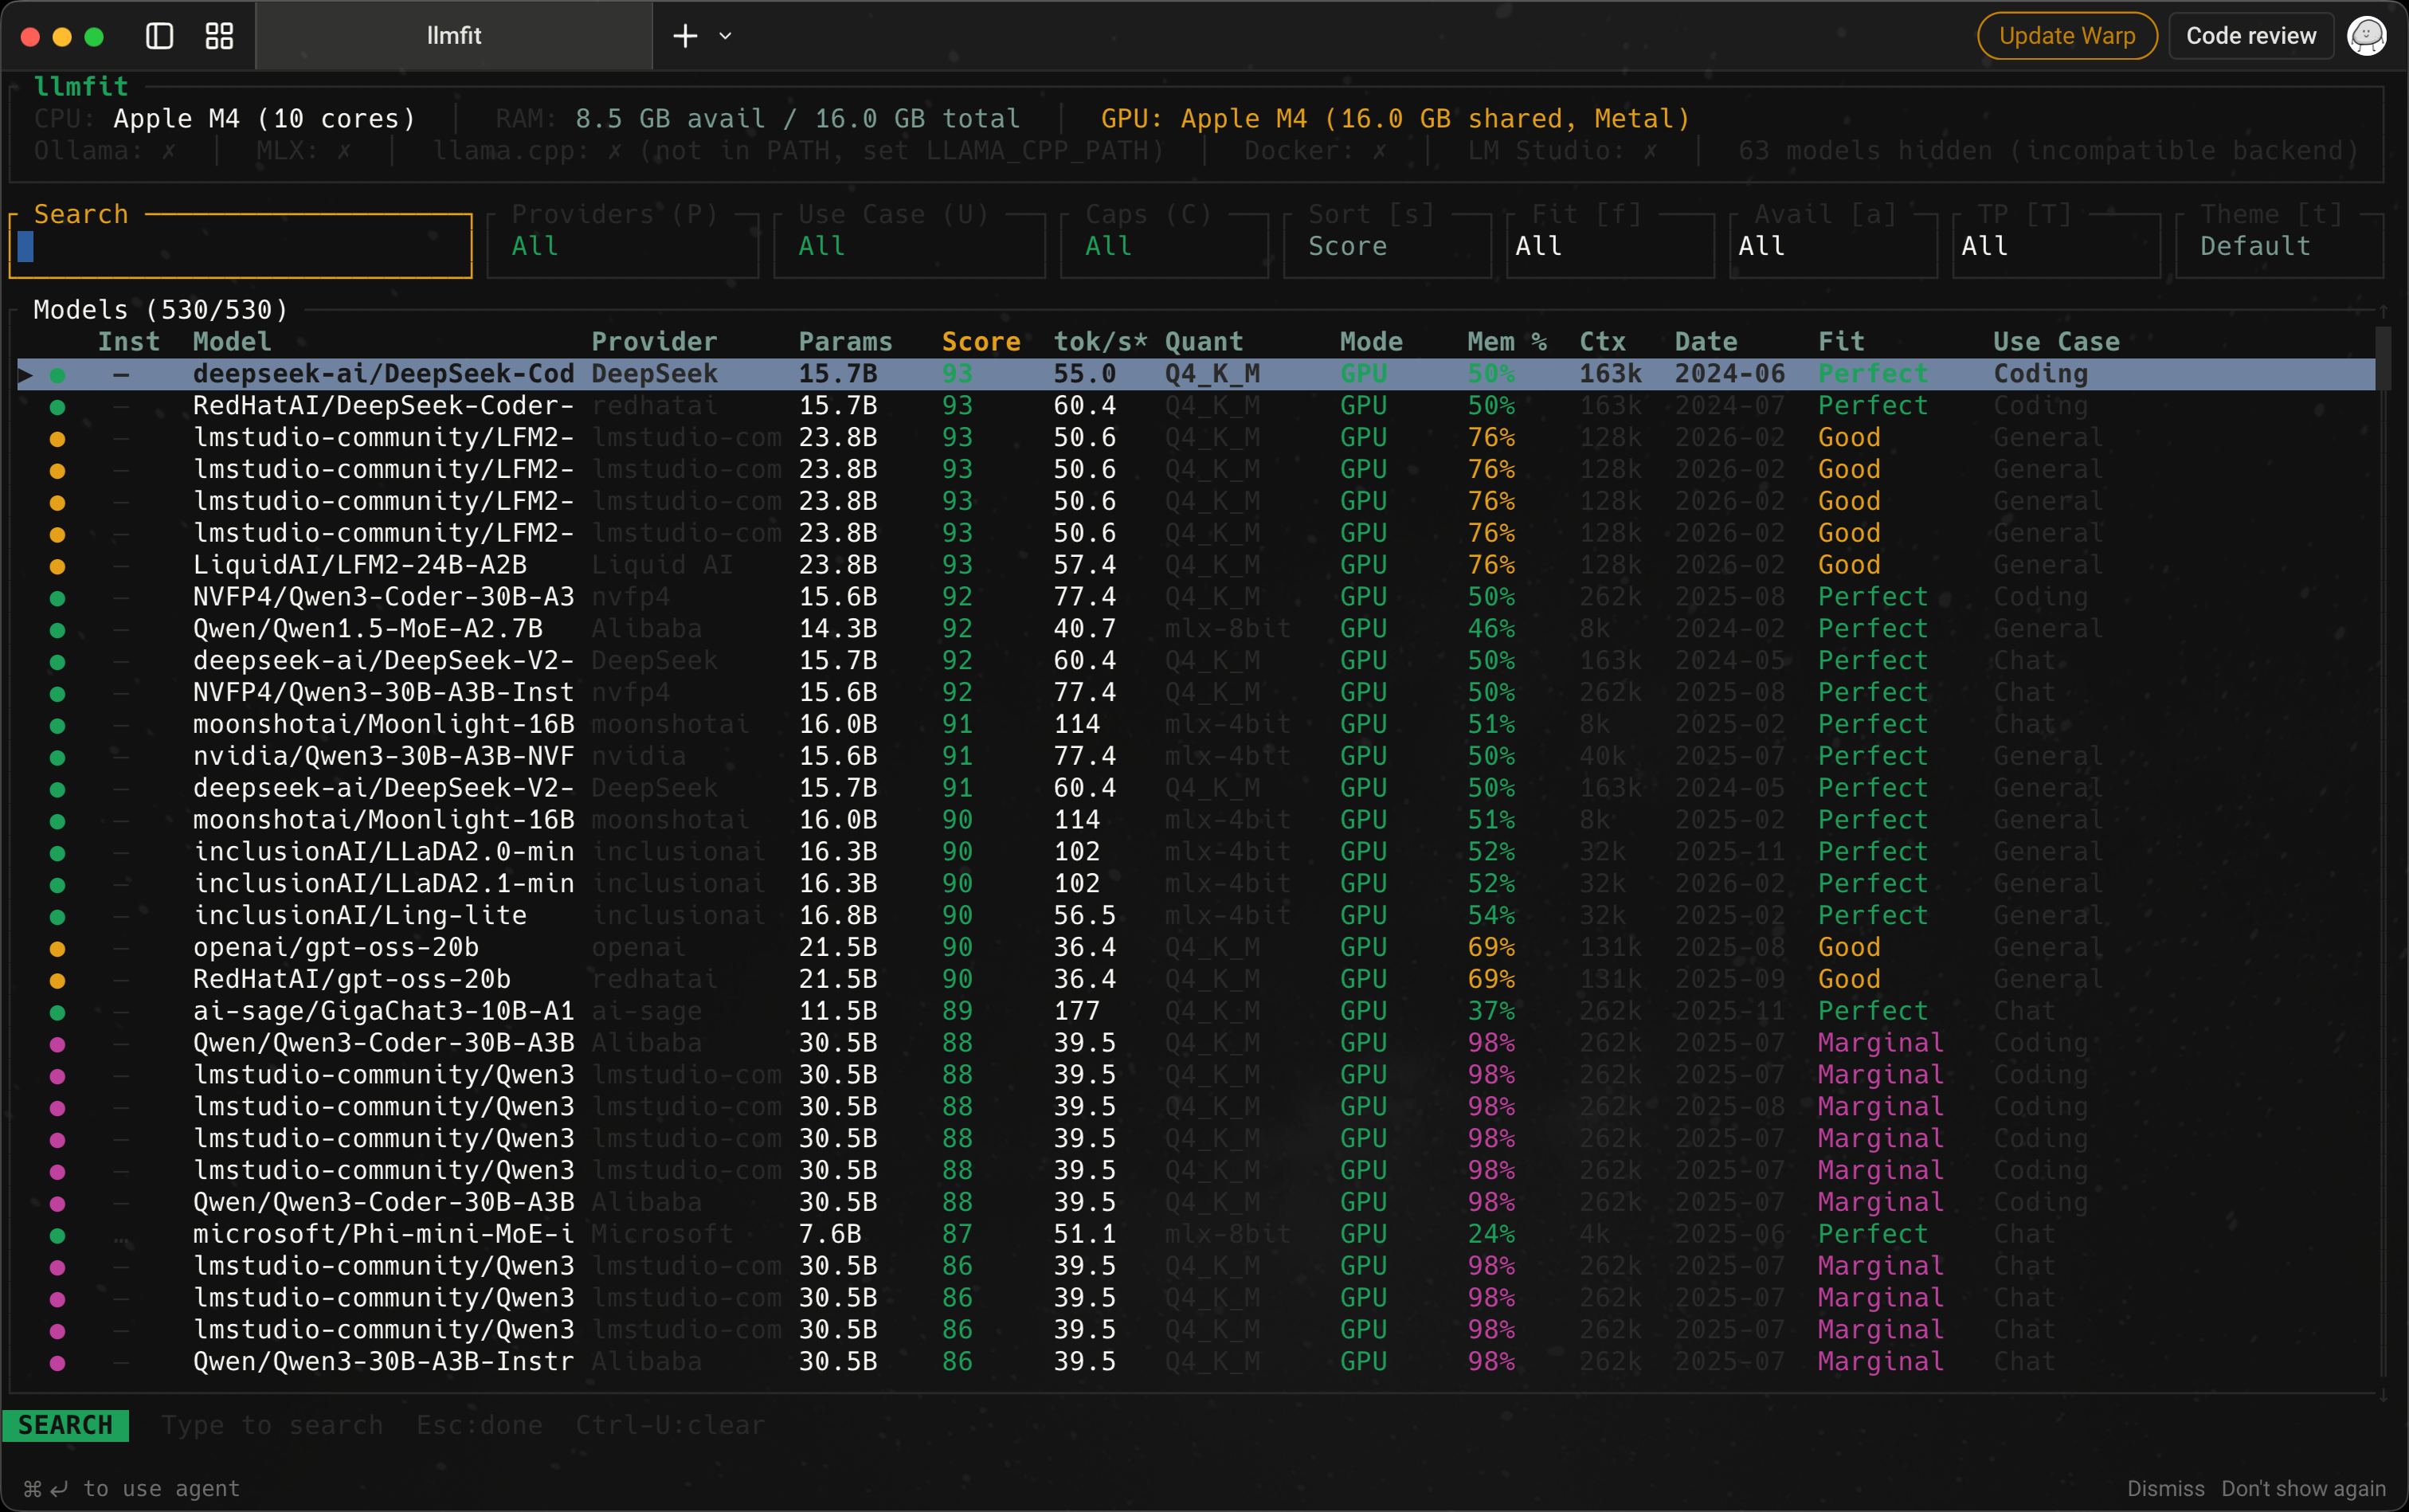
로컬 LLM을 써보려 하면 가장 먼저 부딪히는 문제는 “어떤 모델이 제일 좋나?”보다 “내 맥에서 어떤 모델이 현실적으로 돌아가나?”다. llmfit는 이 질문에 먼저 답해주는 도구다. 모델을 직접 실행하는 프로그램은 아니지만, 내 하드웨어에 맞는 후보를 먼저 좁혀준다는 점에서 로...
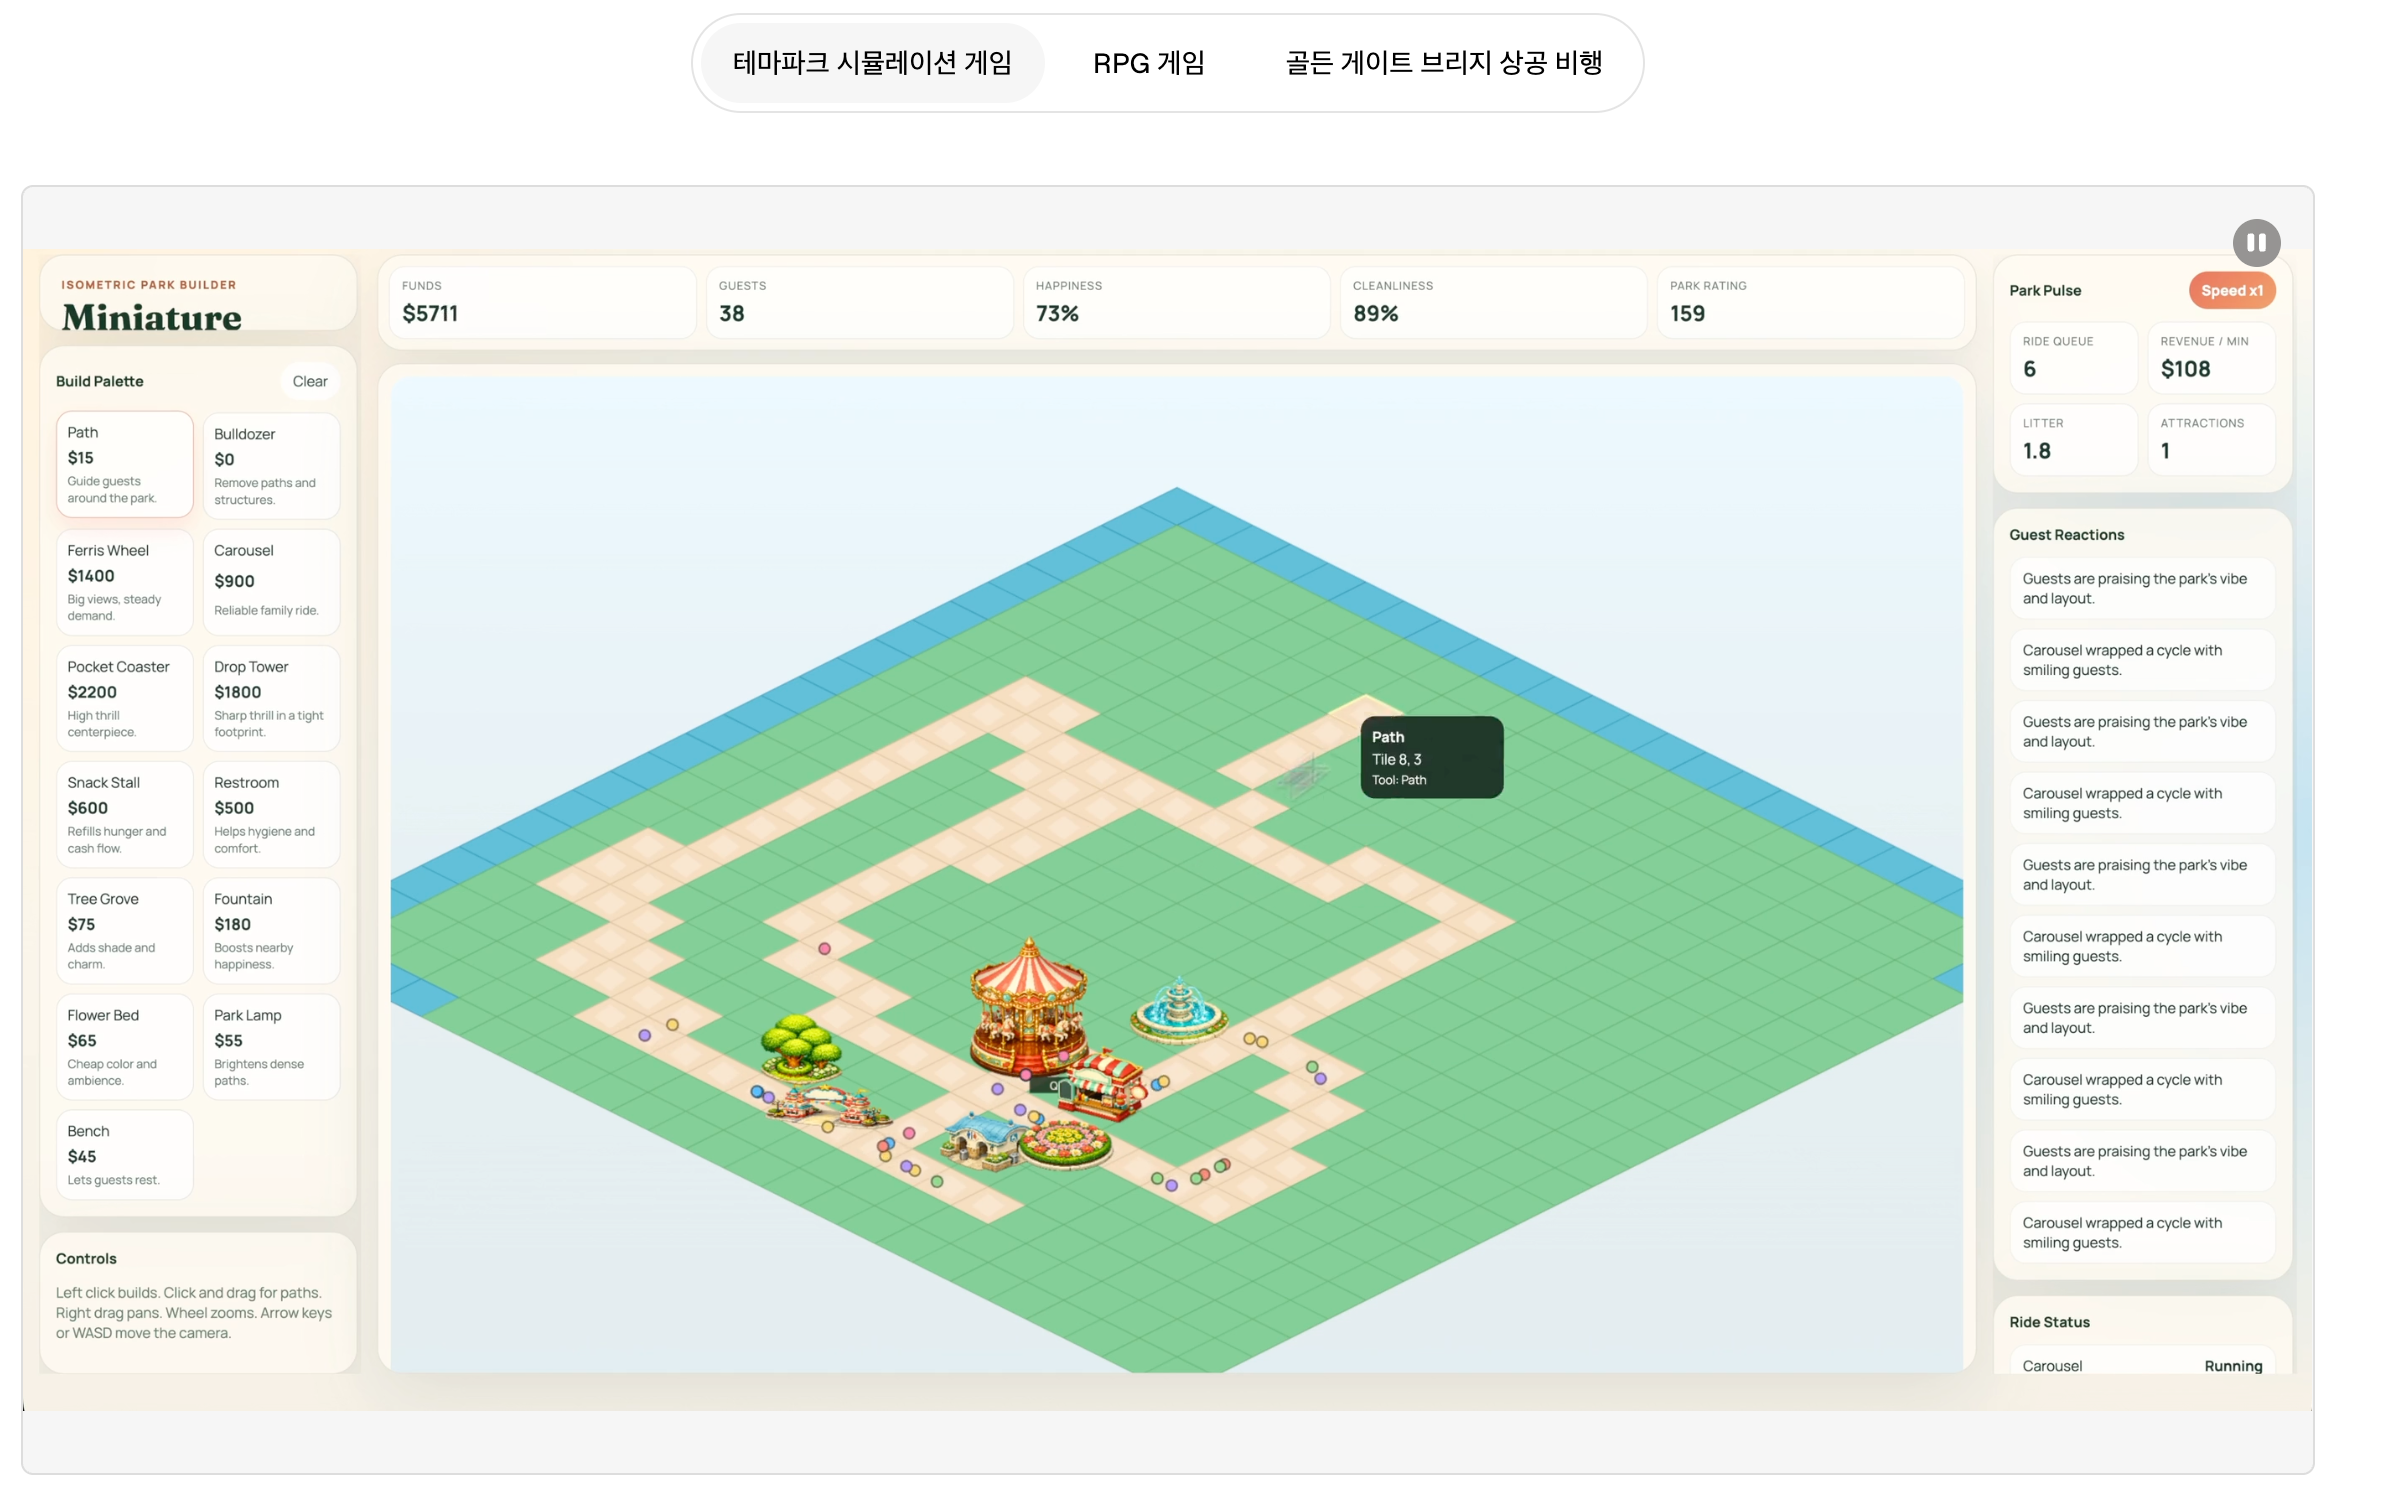
AI가 손쉽게 브라우저를 조작할 수 있도록 만들어주는 Playwright를 사용해보자. GPT 5.4에서 playwright-interactive 스킬 기반으로 웹 앱/게임을 만들었다고 하는데, 이 Playwright가 뭘까?
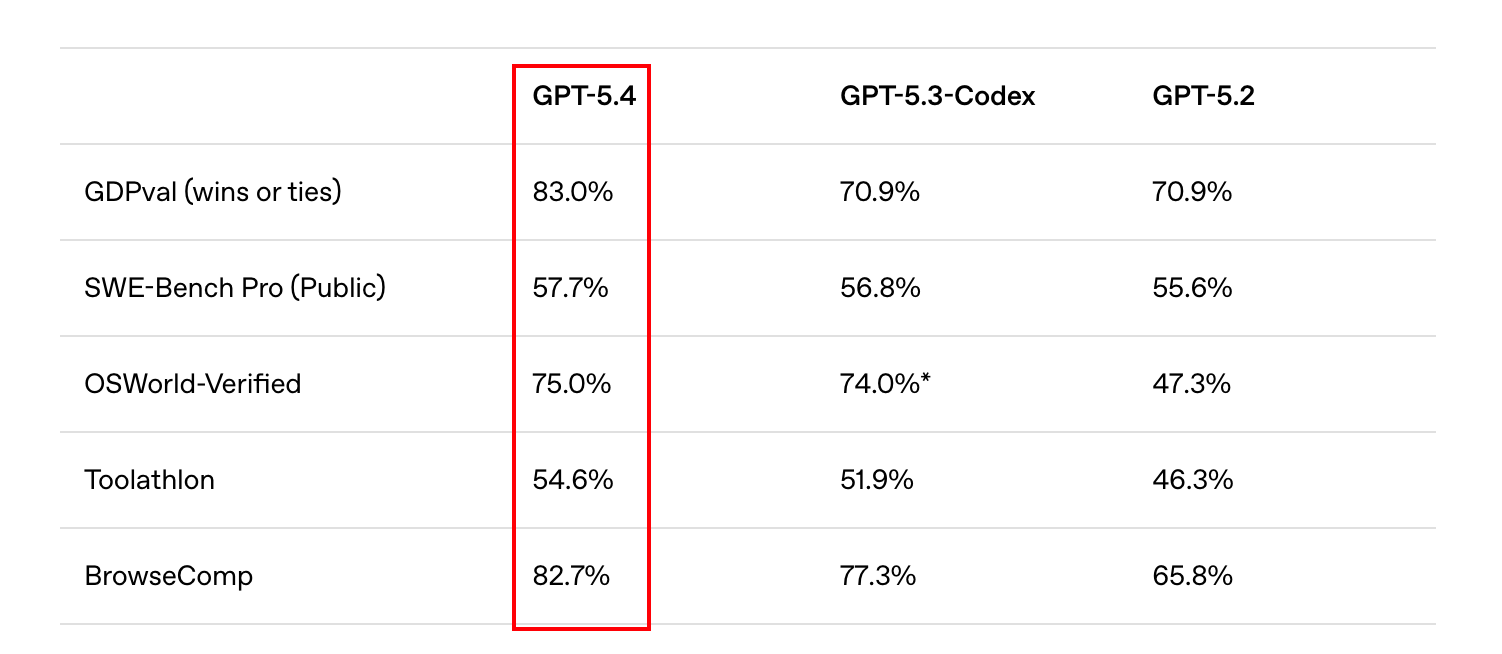
OpenAI가 GPT 5.4를 출시했다. Tool Calling, Computer Use 등 Agent 성능이 크게 향상되었으며, 주요 벤치마크에서 타 모델들을 확연히 이기며 명실상부한 SOTA에 등극했다.
2월에 Google은 Gemini의 창작 기능을 음악과 이미지 양쪽으로 대폭 확장했다. Lyria 3로 음악 생성을, Nano Banana 2로 이미지 생성을 한 단계 끌어올렸고, 관련 내용을 이 글로 통합 정리했다.
2월 23일, Anthropic이 공식 블로그를 통해 중국 AI 연구소 3곳의 대규모 증류 공격 정황을 공개했다.
2월 한 달간 AI 업계에서는 주요 기업들이 동시다발적으로 새 모델을 쏟아냈다. Opus 4.6의 SOTA 달성으로 시작해 Gemini 3.1 Pro의 SOTA 탈환으로 마무리된 한 달을 출시 순서대로 정리해본다.
프로그래밍 언어론 강의에서 중요한 용어들 쪽지 시험을 친다고 해서 정리를 해봤어요. 위키백과랑 ChatGPT를 사용해서 각 용어들에 대한 정의와 개념을 찾아봤어요!
1학기가 끝나고 성적이 나왔습니다. 드디어 저도 4.5라는 학점을 받아보게 되었네요. 감개무량🥹이에요..!!
한동안 포스팅을 못했는데요. 그동안 카테캠 1단계(강의 수강)도 끝나고 2단계(클론 코딩 - 카카오 쇼핑)에 돌입했어요! 벌써 2단계도 1주일이나 지났네요.
사실 어제 실시간 세션 시간이 공학연구실습 과목과 겹쳐서 참가를 못했거든요... 그런데 저녁에 공연실을 마치고 집을 돌아와서 10시에 깃헙을 봤는데 팀원들끼리 실습을 한 repo가 있는거에요!!🫢
중간고사 기간이 끝났어요. 4학년이라 학점을 적게 들으니까 부담이 적었네요. 12학점을 수강 중인데 하나는 패스/논패스 과목이라 시험이 단 3개!! 3과목 다 잘 친거 같아서 좋네요🙌
요즘 개발자들에게 블로그가 유행이라고 합니다. 요즘 웹이 무척 재밌어서 저도 블로그를 만들어 보았네요. 제 블로그에 대한 꿈은 작년 12월 교수님의 블로그 운영에 대한 이야기에서부터 시작됐는데요. 하지만 무려 3개월이 지난! 이제서야 만들게 되었습니다. 그도 그럴게 방학동안 너무 ...
MCP(Model Context Protocol)는 AI 애플리케이션과 외부 기능이 도구·리소스·프롬프트를 주고받는 규약이다. 메시지는 JSON-RPC 2.0으로 표현하고, 로컬에서는 stdio, 원격에서는 Streamable HTTP로 옮긴다.
JSON-RPC 2.0은 원격 함수를 호출하는 메시지를 JSON 객체로 표현하는 규약이다. 요청과 응답의 모양은 정하지만, 그 JSON을 HTTP로 보낼지 표준입출력으로 보낼지는 정하지 않는다.
Docker 명령은 하나씩 보면 단순하지만 run, start, exec, attach처럼 비슷한 명령이 많아 다시 찾게 된다. 자주 쓰는 명령을 이미지, 컨테이너, 네트워크, 저장소, Compose 순서로 묶었다.
Claude Code를 tmux 안에서 오래 실행하면 두 군데에서 자주 막힌다. 응답이 갱신될 때 화면이 아래로 튀고, macOS 클립보드의 이미지는 평소처럼 Cmd+V를 눌러도 첨부되지 않는다.
GitHub 저장소를 HTTPS로 clone한 뒤 git push에서 비밀번호를 요구받는다면 계정 비밀번호를 넣어도 인증되지 않는다. GitHub은 2021년 8월부터 Git 작업의 비밀번호 인증을 받지 않는다.
macOS용 Codex 데스크톱 앱을 쓰다 보면 창 가로폭이 어느 지점 아래로 더 줄어들지 않는 경우가 있다. 사이드바를 닫아도 여전히 넓게 고정돼 있다면, 단순한 레이아웃 문제가 아니라 내부 상태값이 꼬인 경우일 수 있다. 내가 겪은 경우에는 창이 정확히 1200px 근처 아래로...
Claude Code에만 있던 Sub Agent(서브 에이전트) 기능이 OpenAI Codex에도 공식 추가되었다.
Zotero 7 PDF 리더에서 인용이나 주석 위에 마우스를 올리면 작게 뜨는 미리보기 팝업 때문에 늘 고생했다. 글자가 너무 작아서 참고문헌을 확인하려면 결국 팝업을 클릭해서 본문으로 이동하거나, 눈을 찌푸려가며 겨우 읽어야 했다. 놀랍게도 Zotero에는 이 팝업 크기를 조절하...
Python에서도 프로젝트마다 독립적으로 패키지를 관리할 수 있도록 가상환경을 구성한다. 가장 기본적인 방식은 venv를 사용하는 것이며, 프로젝트 루트에 .venv 폴더를 만들어 그 안에 필요한 패키지를 설치하고 requirements.txt로 패키지 목록을 관리한다. 이렇게 하...
저번 편(python 개발 환경, 코드 포매팅)에 이어 vscode의 git 관련 도구 및 기타 유용한 도구들을 소개하고자 한다.
Github에는 커밋이나 Issue, Pull Request 등 contribution한 기록이 그래프로 남는다. 이 contribution graph를 한국 사람들은 github 잔디라고 부르며 성실함과 꾸준함을 드러내기 위해 사용하며, 또한 하나의 일일목표로 삼는 사람이 많다.
JetBrains 계열의 IntelliJ나 WebStorm을 사용하던 사람이 VSCode로 Python 개발을 시작하면 불편함을 느끼는 경우가 많다. VSCode는 기본적으로 단순한 텍스트 에디터에 가깝기 때문에, 제대로 활용하려면 여러 Extension을 설치하고 세부 설정을 직...
갑자기 AWS로 부터 잔액부족 메일이 왔다. 무려 25,000원이나 결제를 하라고 한다.
이번에는 서버에 MySQL을 설치 및 사용자를 추가하여 다른 컴퓨터에서도 서버의 MySQL에 접근 가능하도록 해봤어요. 제가 AWS 프리티어로 우분투 서버 인스턴스를 대여 중인데 아직 아무 프로그램도 안 올려놔서 데이터베이스라도 서버에서 돌릴려고요.🐎
이전 게시물에서 스프링을 다뤘는데 이제 스프링 부트를 세팅해볼게요.
스프링을 시작하기에 앞서 개발에 필요한 환경 세팅을 해보도록 하겠습니다~ 스프링 부트가 아닌 스프링인 점을 유의해주세요.
학교에서 진행 중인 랩 인턴 프로그램 중 머신러닝 연구실의 실습을 정리할려고 파이썬 가상환경을 구축하고 있었어요. 그런데 자꾸 가상환경에서 시스템 파이썬을 사용하는 거에요...
이번에 카카오 겨울 인턴십 서류 전형에 합격하여 인터뷰를 다녀왔습니다.
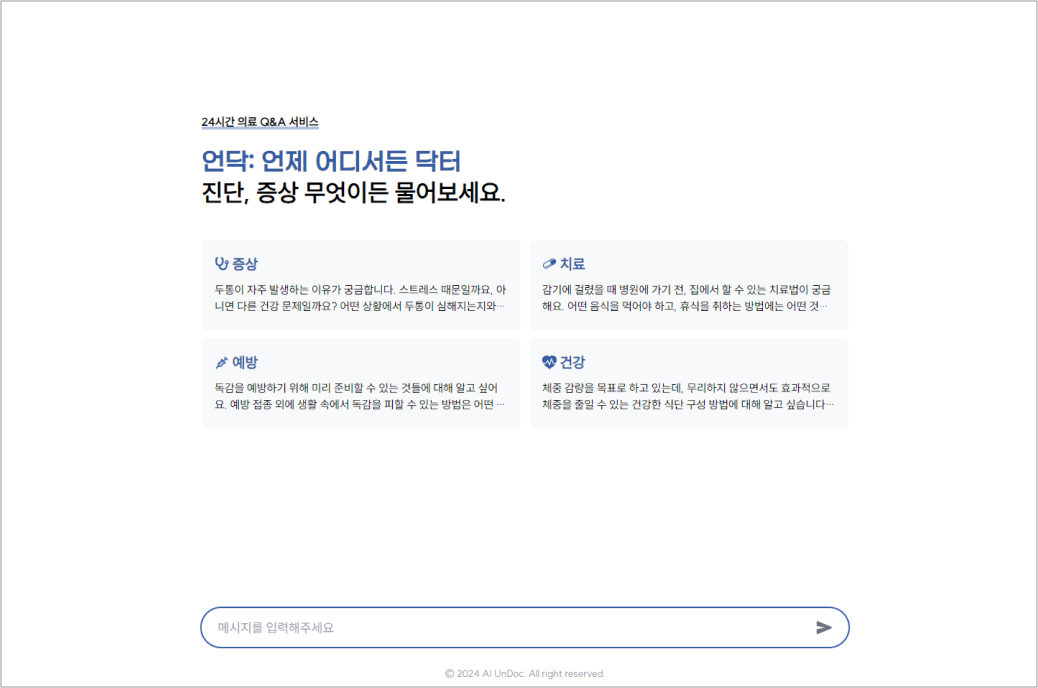
지난 구글 ML 부트캠프 수료 후기에 이어, 우수 프로젝트로 선정되었던 UnDoc 챗봇에 대해 회고를 남겨본다.
정말 많이 늦게 적는 수료 후기... 늦더라도 없는 것보단 낫다는 마음으로 적어본다. 작년, AI Engineer가 되고 말겠다는 다짐과 함께 시작했던 Google ML Bootcamp. 많은 기초를 다지고, 좋은 사람들과 인연을 맺고, 멋진 프로젝트까지 남길 수 있었던 뜻깊은 시...
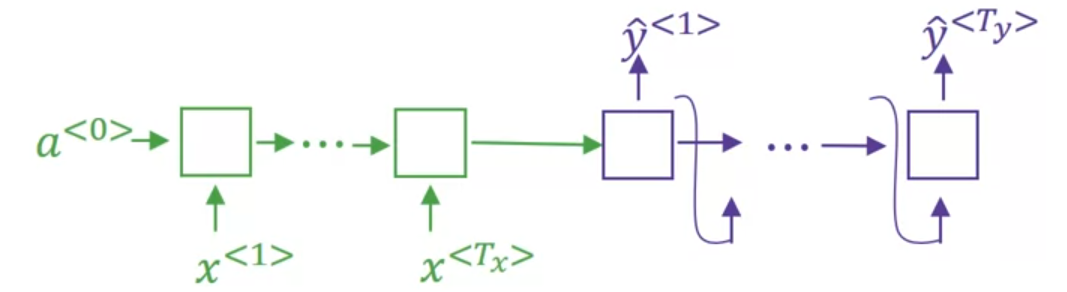
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 마지막 강의입니다. Encoder-Decoder, Attention, Transformer 등을 다룹니다.
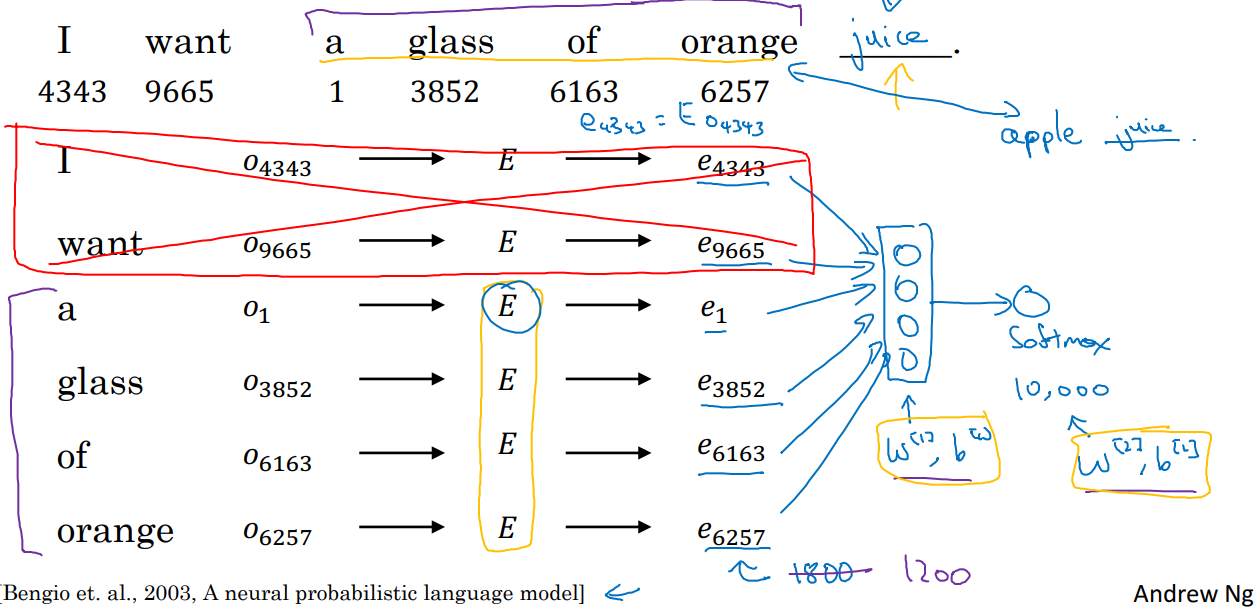
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 마지막 강의입니다. Natural Language Processing과 관련된 Word Embedding, Word2vec, GloVe 등을 배웁니다.
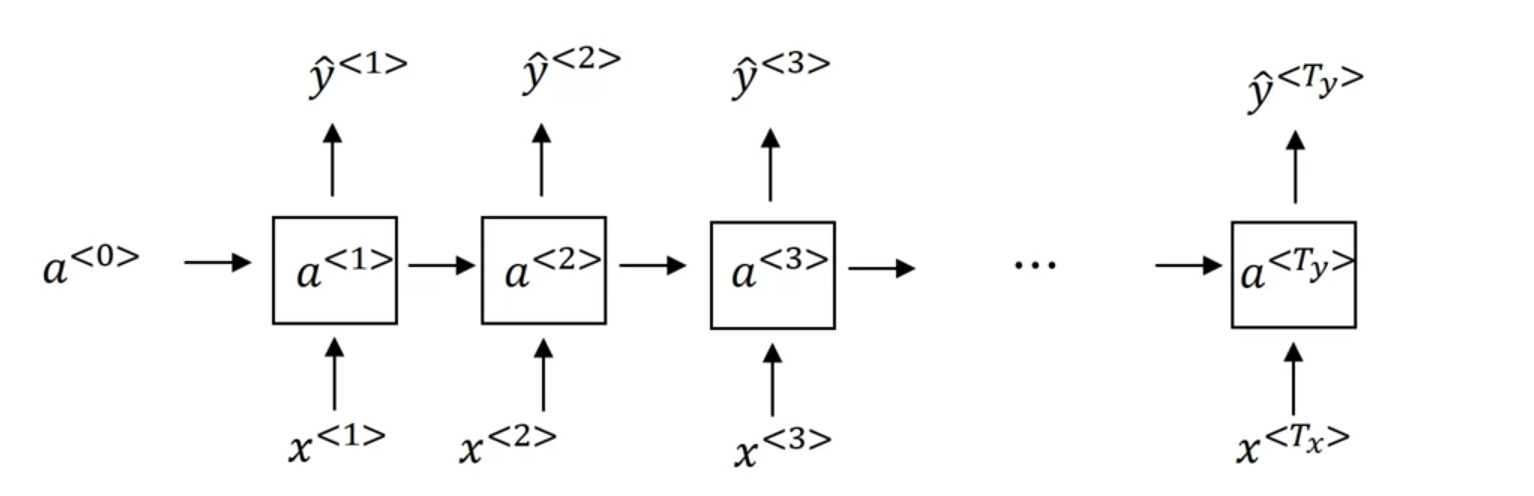
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 마지막 강의입니다. 이번에는 RNN을 베이스로 Language Model, LSTM, GRU 등을 다룹니다.
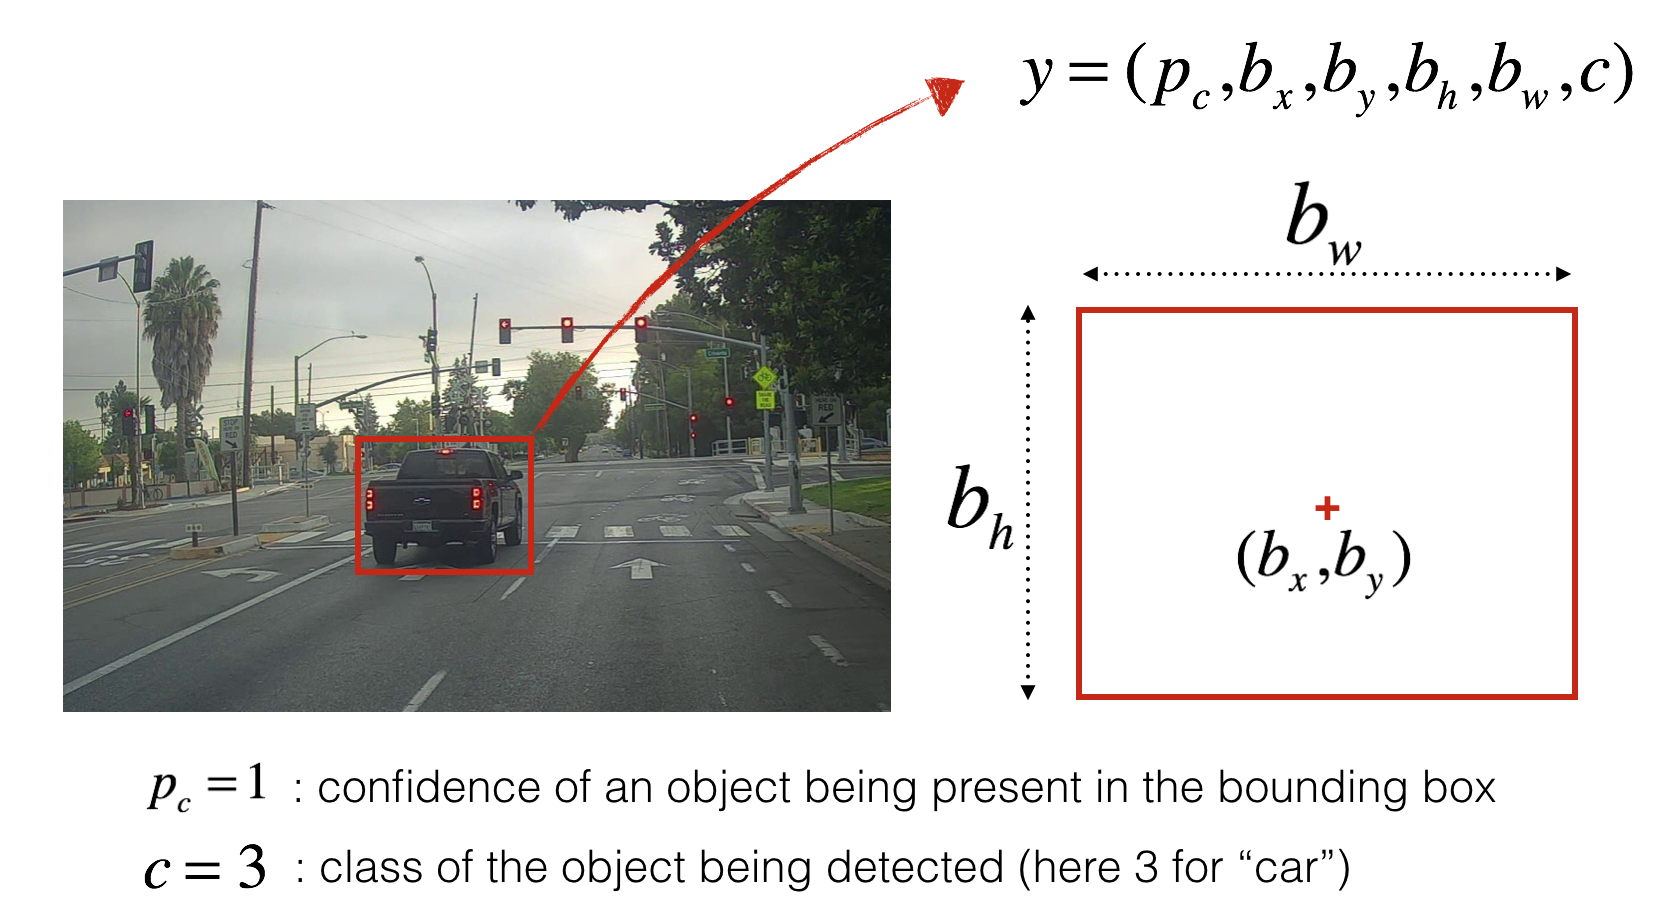
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 네번째 강의입니다. 객체 감지, 얼굴인식, YOLO, U-Net, Neural style transfer 등을 다룹니다.
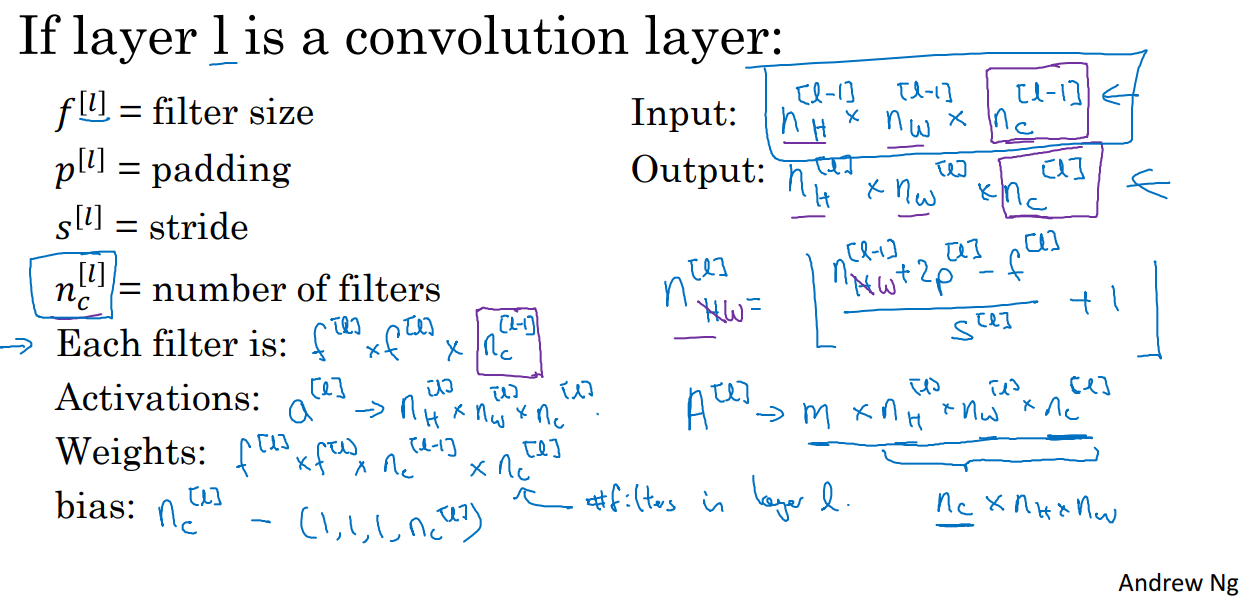
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 네번째 강의입니다.
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 세번째 강의입니다.
이번 게시글은 주로 Hyperparameter Tuning을 다룹니다.
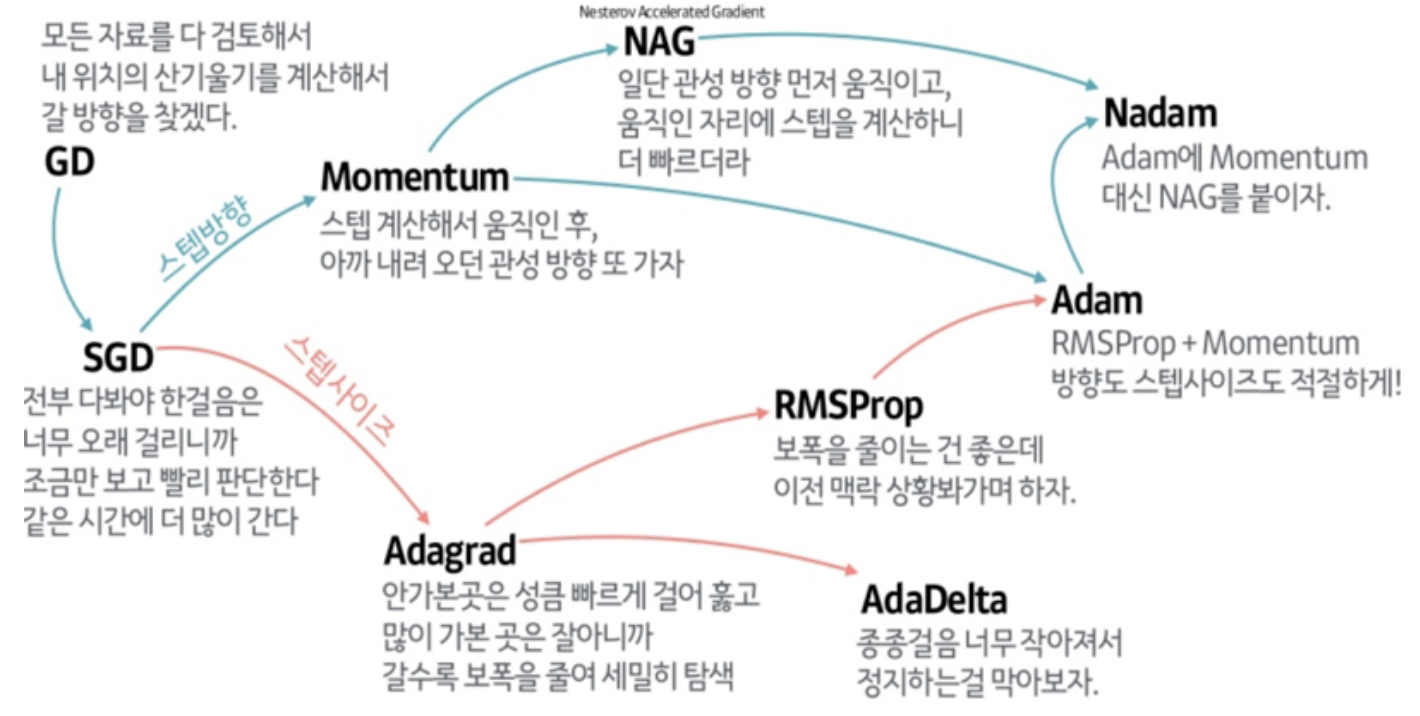
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 두번째 강의입니다. 이번 게시글은 학습을 가속화할 수 있는 Optimization Algorithm을 다룹니다.
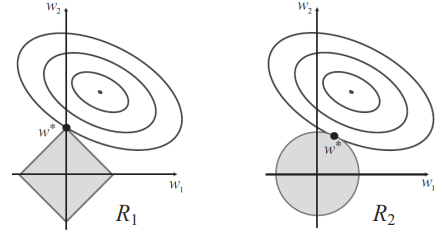
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 두번째 강의입니다. 이번 게시글은 Regularization을 다룹니다.
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 첫번째 강의입니다. Neural Networks and Deep Learning는 이걸로 끝입니다.
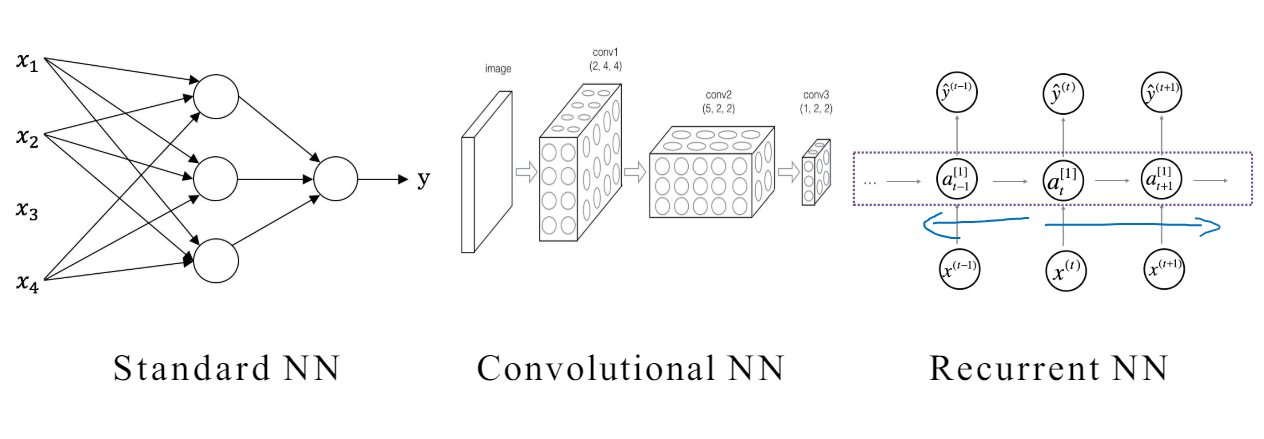
Andrew Ng 교수님의 Coursera - Deep Learning Specialization 첫번째 강의입니다.
구글 머신러닝 부트캠프 2024에 합격하여 후기를 남깁니다.
그 동안 바빠서 블로그 관리도 못하고 3-4개월 가량 방치했었지만, 다시 기록을 남기러 왔어요. 카테캠은 무사히 수료하고 무려 마지막 팀 프로젝트에서 대상을 받았습니다!
이제 sns-server를 완성했어요! Spring에서 JDBCTemplate을 사용해 layered Architecture로 만들었는데 구조도 깔끔하고 객체지향으로 기능 분리가 되어 있어 코드 짜는 내내 재밌었어요.
이번주부터 2주간 MySQL 강의를 듣습니다. sns 서버를 만든다고 하네요. 실습 위주라 직접 따라가며 프로그램을 만들었습니다.
이번 주로 스프링 강의는 마지막이네요. 선택강의로 스프링 심화랑 스프링 부트도 존재하니까 나중에 봐야겠어요.
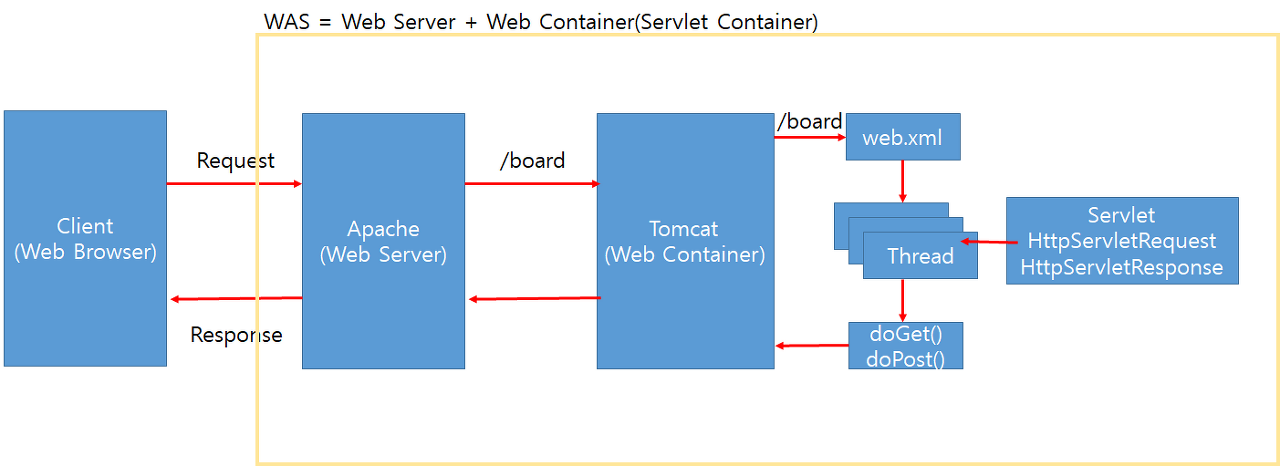
6주차는 스프링 MVC 패턴을 비롯한 심화를 배웠습니다. 저번 시간에 의문이 들었던 Servlet도 배우고 JSP(Java Server Page)를 다루는 법도 상세히 배웠어요.
5주차부터는 드디어 백엔드를 위한 스프링을 배웠습니다. 강의는 패스트캠퍼스의 남궁성 스프링 강좌였어요.
4주차의 내용은 자바의 함수형 프로그래밍, Lambda expression, Stream, Exception, Logging, I/O Stream, Serialization, Decorator Pattern 등을 배웠습니다.
이번 시간에는 github을 사용하여 협업을 하는 법을 실습했습니다!
3주차의 내용은 상속, 다형성, 인터페이스 등의 핵심적인 객체 지향 내용과 Object 클래스, Class 클래스, String 클래스 등을 배웠습니다.
4월 24일에 진행한 실시간 세션 - Git/Github 소개 및 활용법입니다. 첫 시간이라 git 개념과 git 명령어들을 배웠습니다.
2주차는 시험 기간과 겹쳐 필수 강의가 없었어요. 대신 선택강의를 자유롭게 수강하면 된다고 해서, 저는 기초부터 한번 훑고 넘어 갈려고 기초 강의를 들었어요.
4월 10일부터 첫주차 교육이 시작됐어요. 지금은 1단계 웹 개발 기초 교육 과정으로 총 10주간 자바와 Spring, MySQL을 학습한다고 하더라고요.
카카오 테크 캠퍼스 프로그램에 합격했어요!!
더 이상 미룰 수 없었던 매일메일 프로젝트에 대한 회고를 남긴다. 나는 단순한 챗봇이 아니라, 정말 사람들에게 실질적인 도움을 줄 수 있는 LLM 기반 서비스를 만들고 싶었다. 그 방향성 아래, 우리 팀은 하루 동안 받은 이메일을 요약 및 정리해주는 LLM Agent 시스템을 기획...
네이버 부스트캠프 AI Tech 7기 NLP 트랙을 수료했다. 조금 늦었지만, 간단하게 후기를 정리해본다.
이번주는 새로운 프로젝트 기계독해를 진행하기에 앞서 관련된 강의를 학습하였습니다. 시간이 나면 첫번째 프로젝트에 대한 회고도 작성하고 싶은데 가능할지 모르겠네요.
문장 유사도 측정 프로젝트를 위한 기초 지식들을 다룹니다.
이번 주부터는 다음주 추석을 끼워서 총 3주(학습 기간 2주) 간 문장 유사도 측정 프로젝트를 진행하게 되었습니다. 해당 기간의 강의로 먼저 AI 개발 기초를 수강하였습니다.
이번주는 Transformer와 Bert에 대해 자세히 공부하였습니다.
이번 주부터 각 도메인 별로 나뉘어져서 개별적인 강의를 수강하게되었습니다. 3~4주차 2주간 NLP 이론에 대해 학습합니다.
이번 주는 데이터 분석과 함께 데이터 시각화를 배웠습니다.
어떠한 작업 T에 대하여 경험 E 와 함께 성능 P 를 향상시키는 것을 머신러닝이라고 한다. <P, T, E>
pytorch의 tensor와 tensor 연산, torch.nn을 활용한 모델 구축을 다룹니다.
처음에는 나도 Obsidian용 기본 스킬 몇 개만 있으면 AI 비서가 금방 돌아갈 줄 알았다. markdown을 읽고, .base를 만지고, CLI로 앱까지 건드릴 수 있으니 얼핏 보면 충분해 보이기 때문이다. 그런데 며칠만 써 보면 금방 차이가 드러난다. 파일을 다룰 수 있는 ...
VS Code 위에서도 개인 비서용 환경을 만들 수는 있다. 문제는 일정 화면, 칸반 보드, 템플릿, 첨부 정리까지 붙이기 시작하면 다시 도구를 만드는 일로 돌아가기 쉽다는 점이다. 내가 Obsidian을 계속 쓰는 이유는 markdown 파일 기반이라서만이 아니라, 이미 잘 만들...
Obsidian 구조를 잘 만들어도 오래 가는 건 별개다. 시간이 지나면 AGENTS.md는 두꺼워지고, 장기 메모리와 임시 판단이 섞이고, 새 규칙이 생길 때마다 어디를 고쳐야 할지 헷갈리기 시작한다. 1편과 2편이 왜 이 시스템을 다시 시도하게 됐는지와 구조를 어떻게 나눴는지를...
이 시리즈의 1편에서는 일일기록 -> AI 후처리 -> Day Planner 흐름을 보여줬다. 그런데 그 자동화가 한두 번 반짝하고 끝나지 않으려면, 그 뒤에서 에이전트가 길을 잃지 않는 구조가 먼저 있어야 한다.
Obsidian을 오래 못 쓰는 이유는 기능이 부족해서가 아니다. 구조를 제대로 잡는 순간, 메모보다 유지 보수가 더 커지기 때문이다.
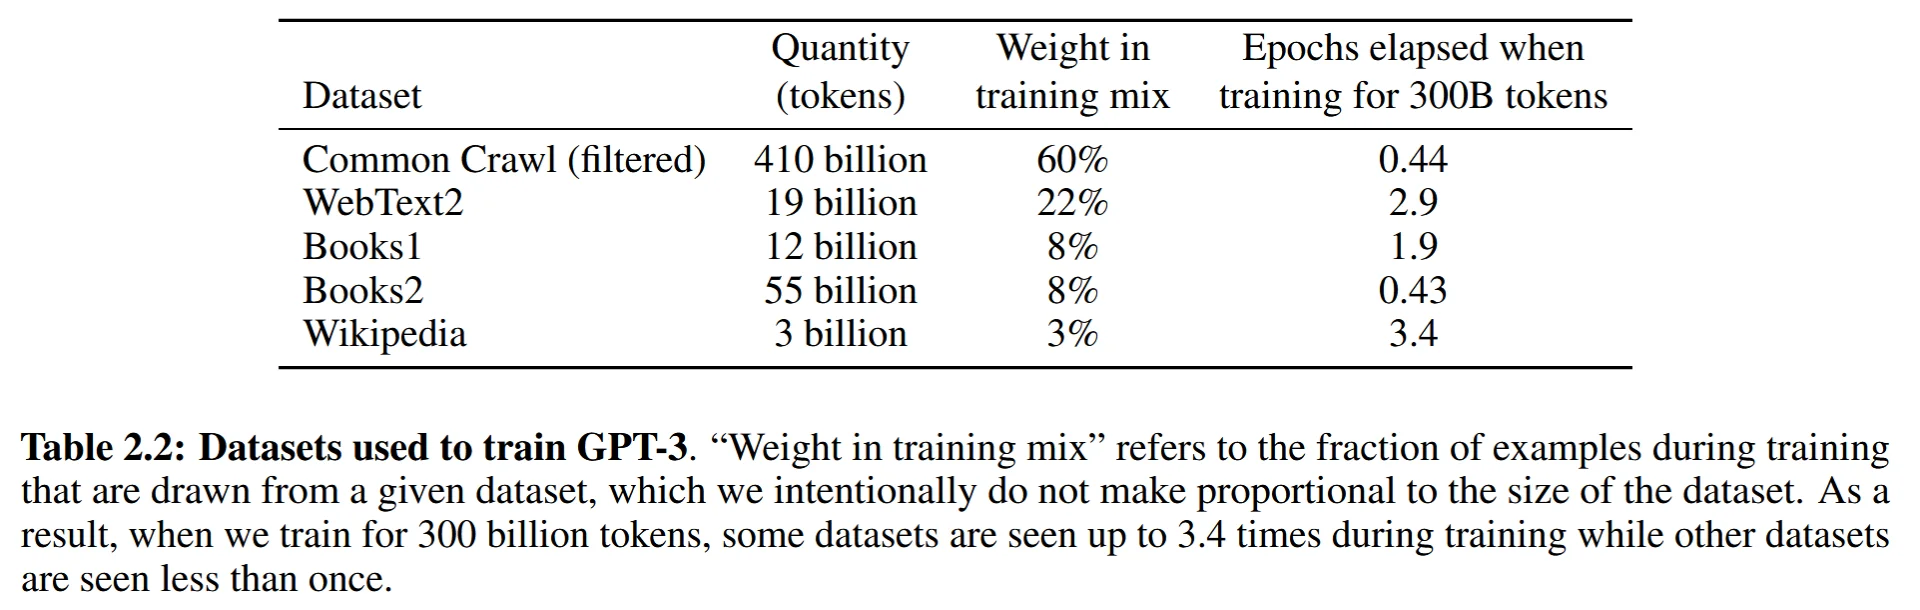
GPT-3는 175B parameter의 autoregressive language model을 task별로 fine-tuning하지 않고, instruction과 example을 context에 넣는 것만으로 여러 task에 적응시킨다. 핵심은 GPT-2보다 약 100배 큰 mo...
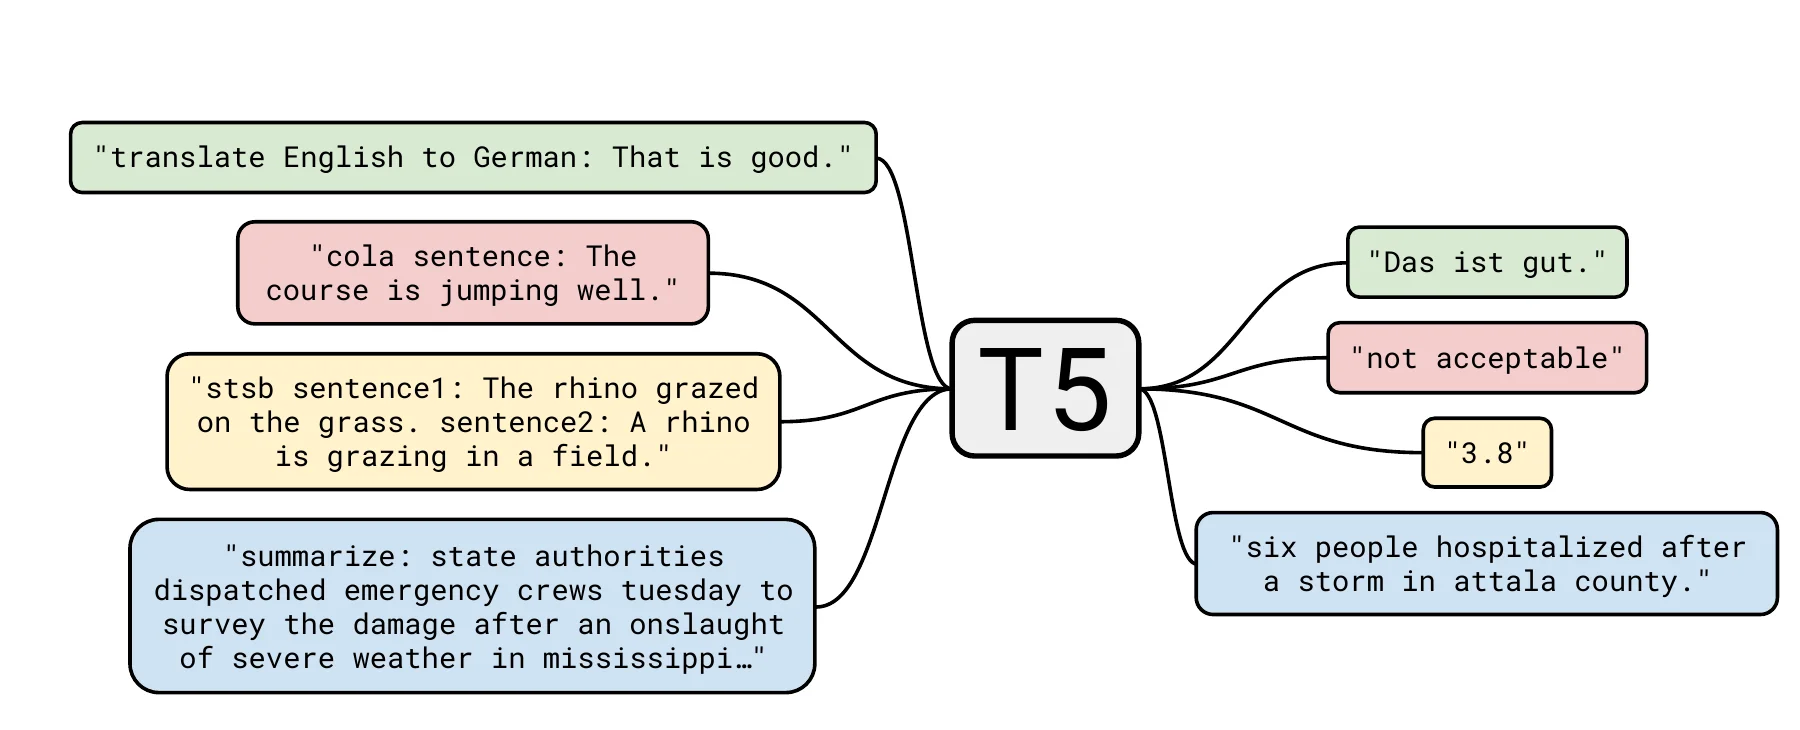
T5(Text-to-Text Transfer Transformer)는 분류, 질의응답, 요약, 번역처럼 입출력 구조가 다른 NLP 과제를 모두 text → text 문제로 바꾼다. 이 논문은 새로운 attention block을 제안하기보다 하나의 학습 interface 안에서 a...
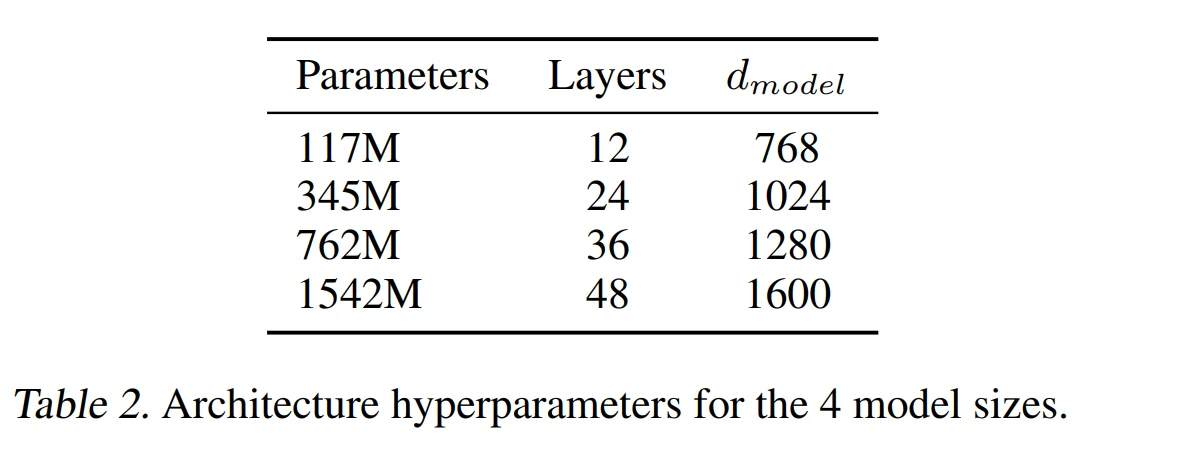
GPT-2는 task별 supervised training 없이, 다양한 web text로 학습한 language model 하나가 여러 NLP task를 수행할 수 있는지 시험했다. GPT-1이 pretrained representation을 task마다 fine-tuning했다...
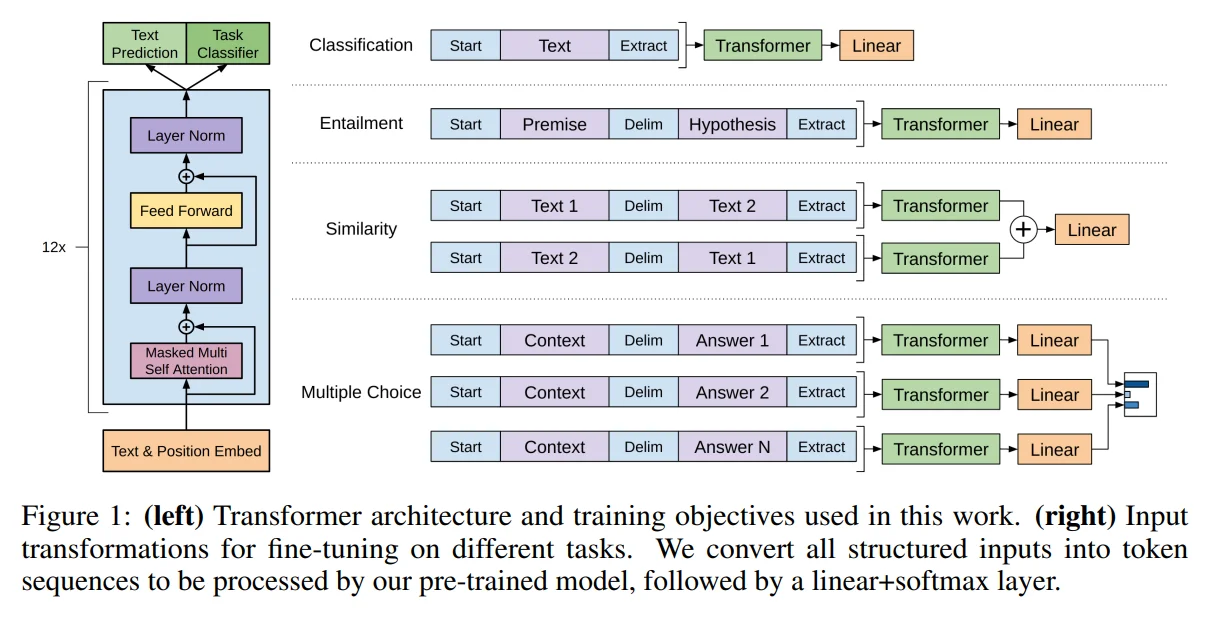
GPT-1은 대규모 unlabeled text로 Transformer language model을 먼저 학습한 뒤, labeled data가 있는 downstream task에 맞게 model 전체를 fine-tuning하는 두 단계 framework를 제시했다. 지금은 익숙한 방...
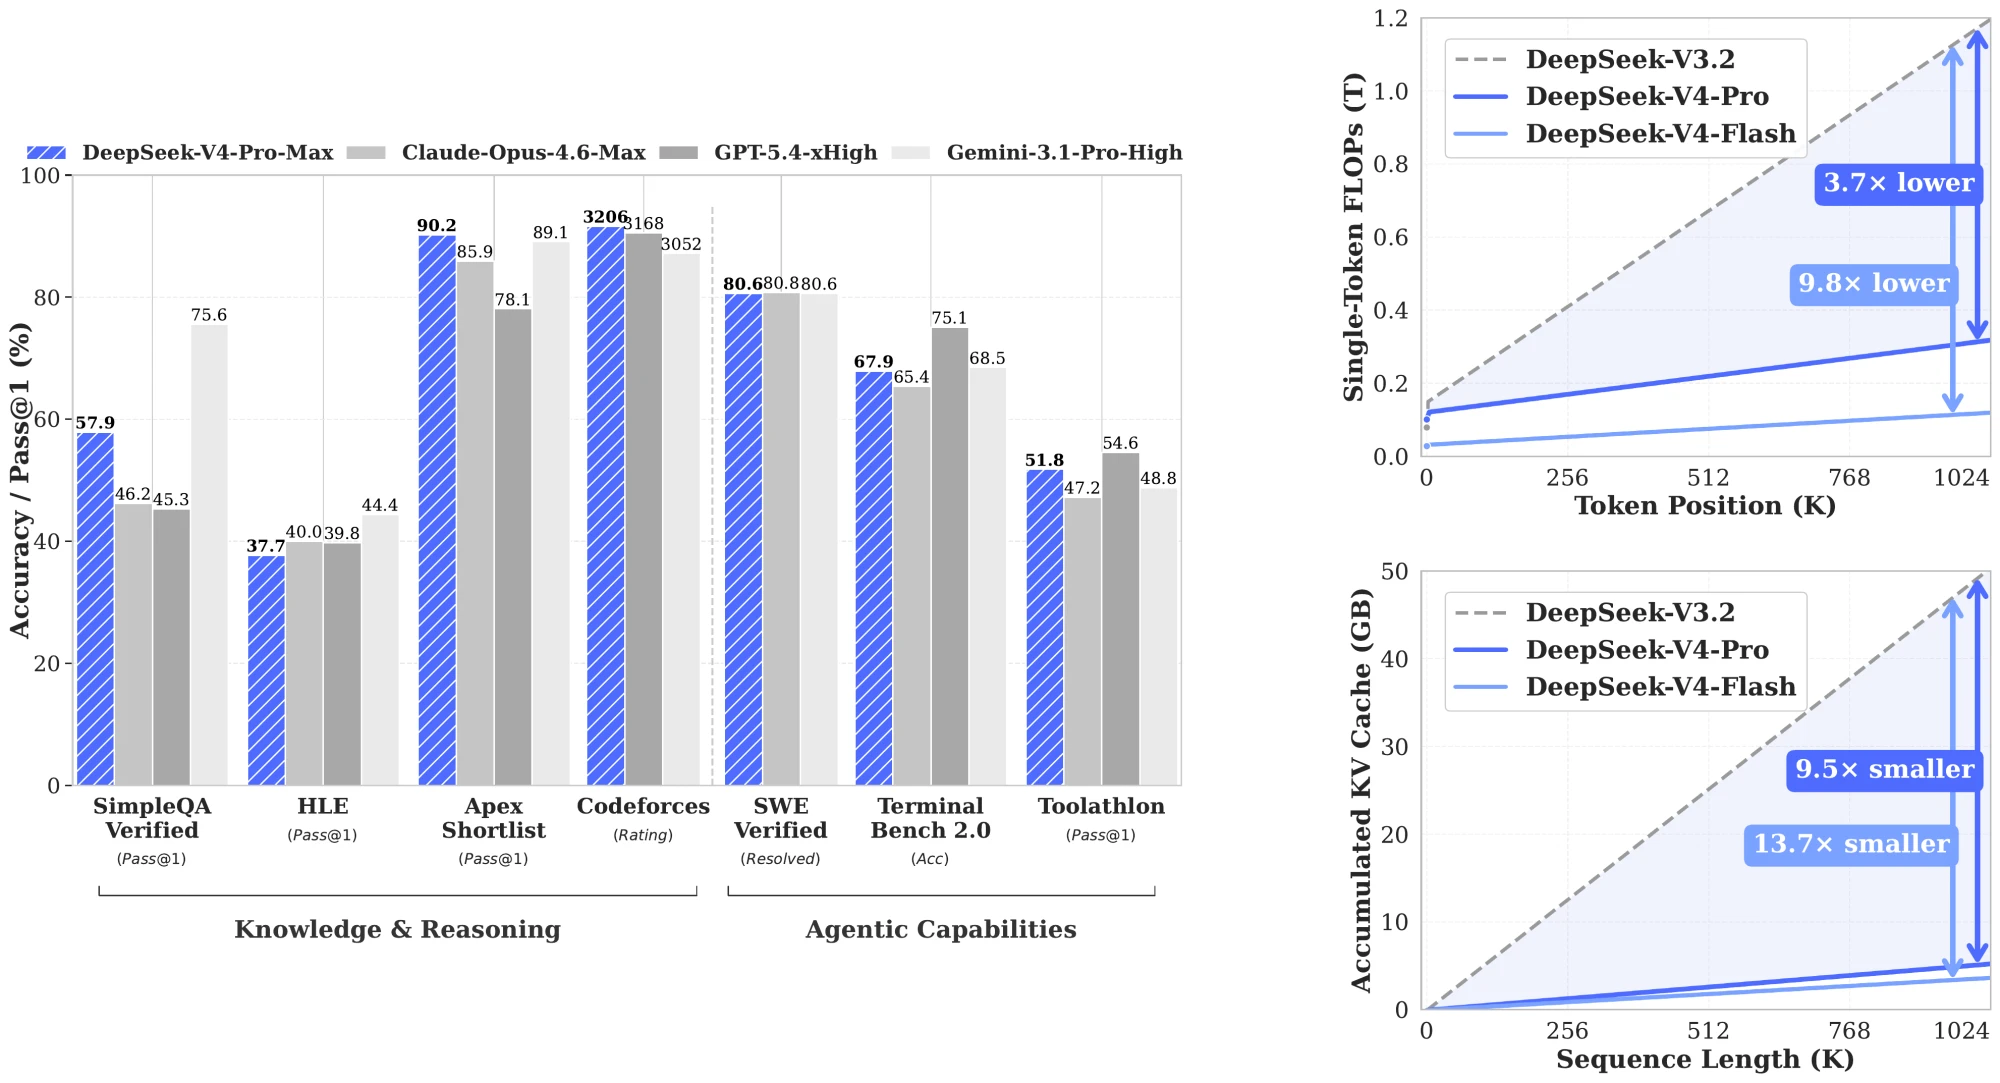
DeepSeek-V4는 100만 토큰 context를 처리하기 위해 attention 하나만 바꾼 모델이 아니다. Residual connection, MoE, optimizer, kernel, KV cache, RL rollout과 post-training을 같은 목표에 맞춰 함...
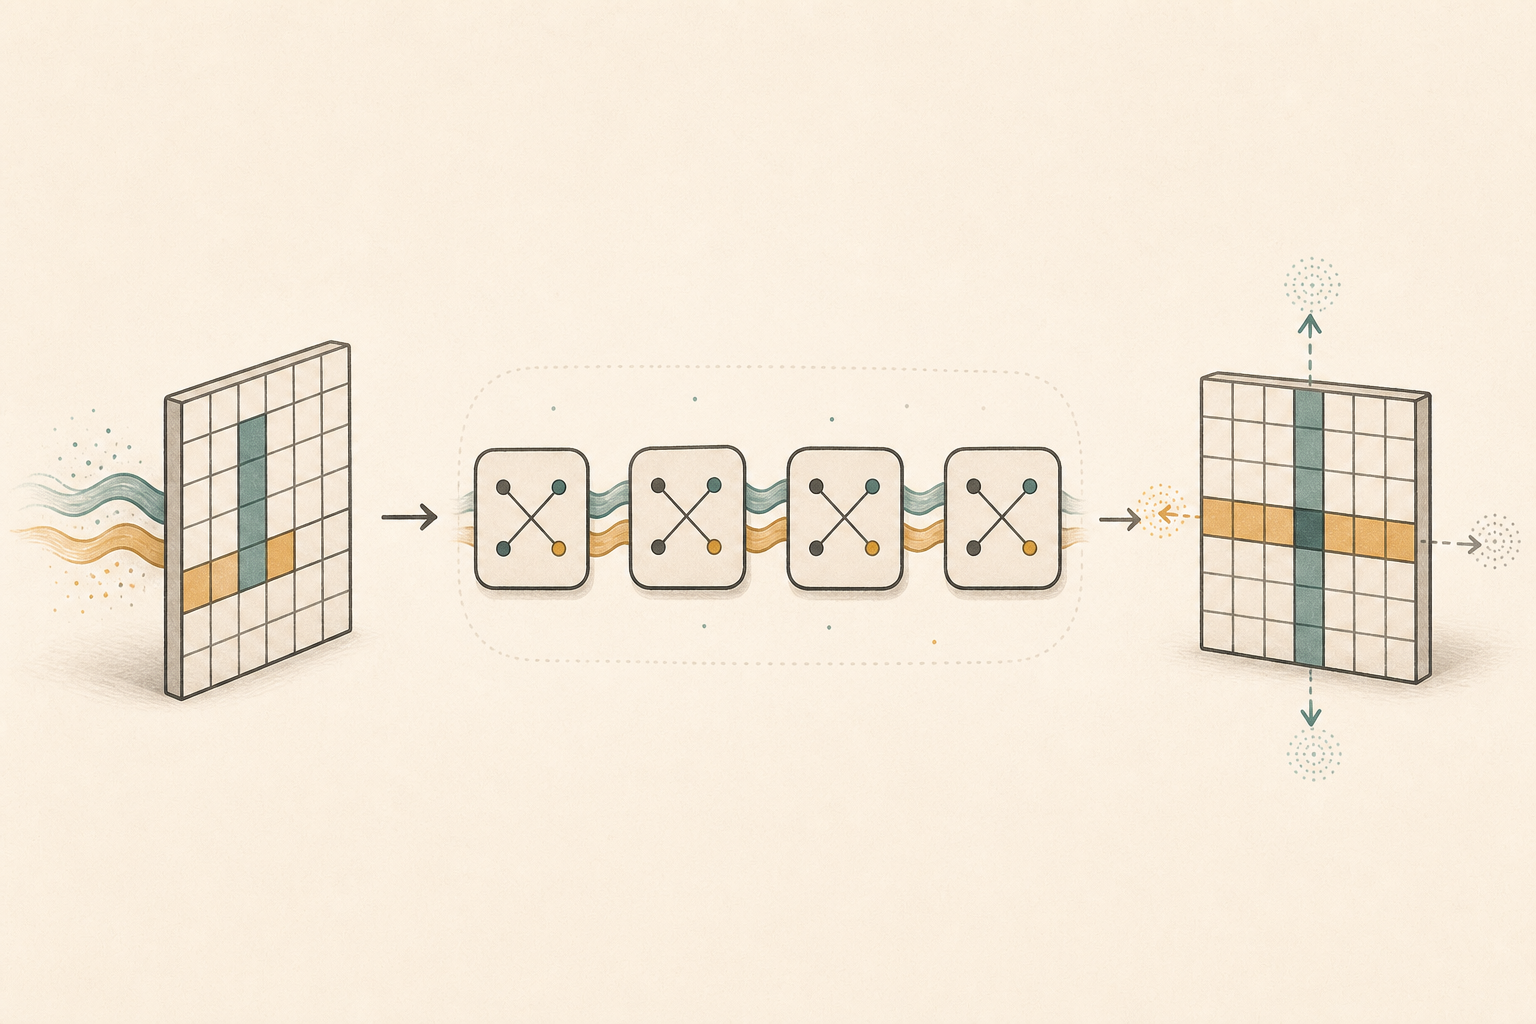
일반적인 언어 모델은 각 위치에서 바로 다음 token 하나를 예측한다. Multi-token Prediction(MTP)은 같은 context representation으로 앞으로 올 여러 token을 함께 맞히도록 학습한다.
Muon은 SGD momentum이 만든 2차원 행렬 update를 Newton–Schulz iteration으로 근사 직교화한 뒤 weight에 적용하는 optimizer다. 이름도 MomentUm Orthogonalized by Newton-Schulz에서 왔다.
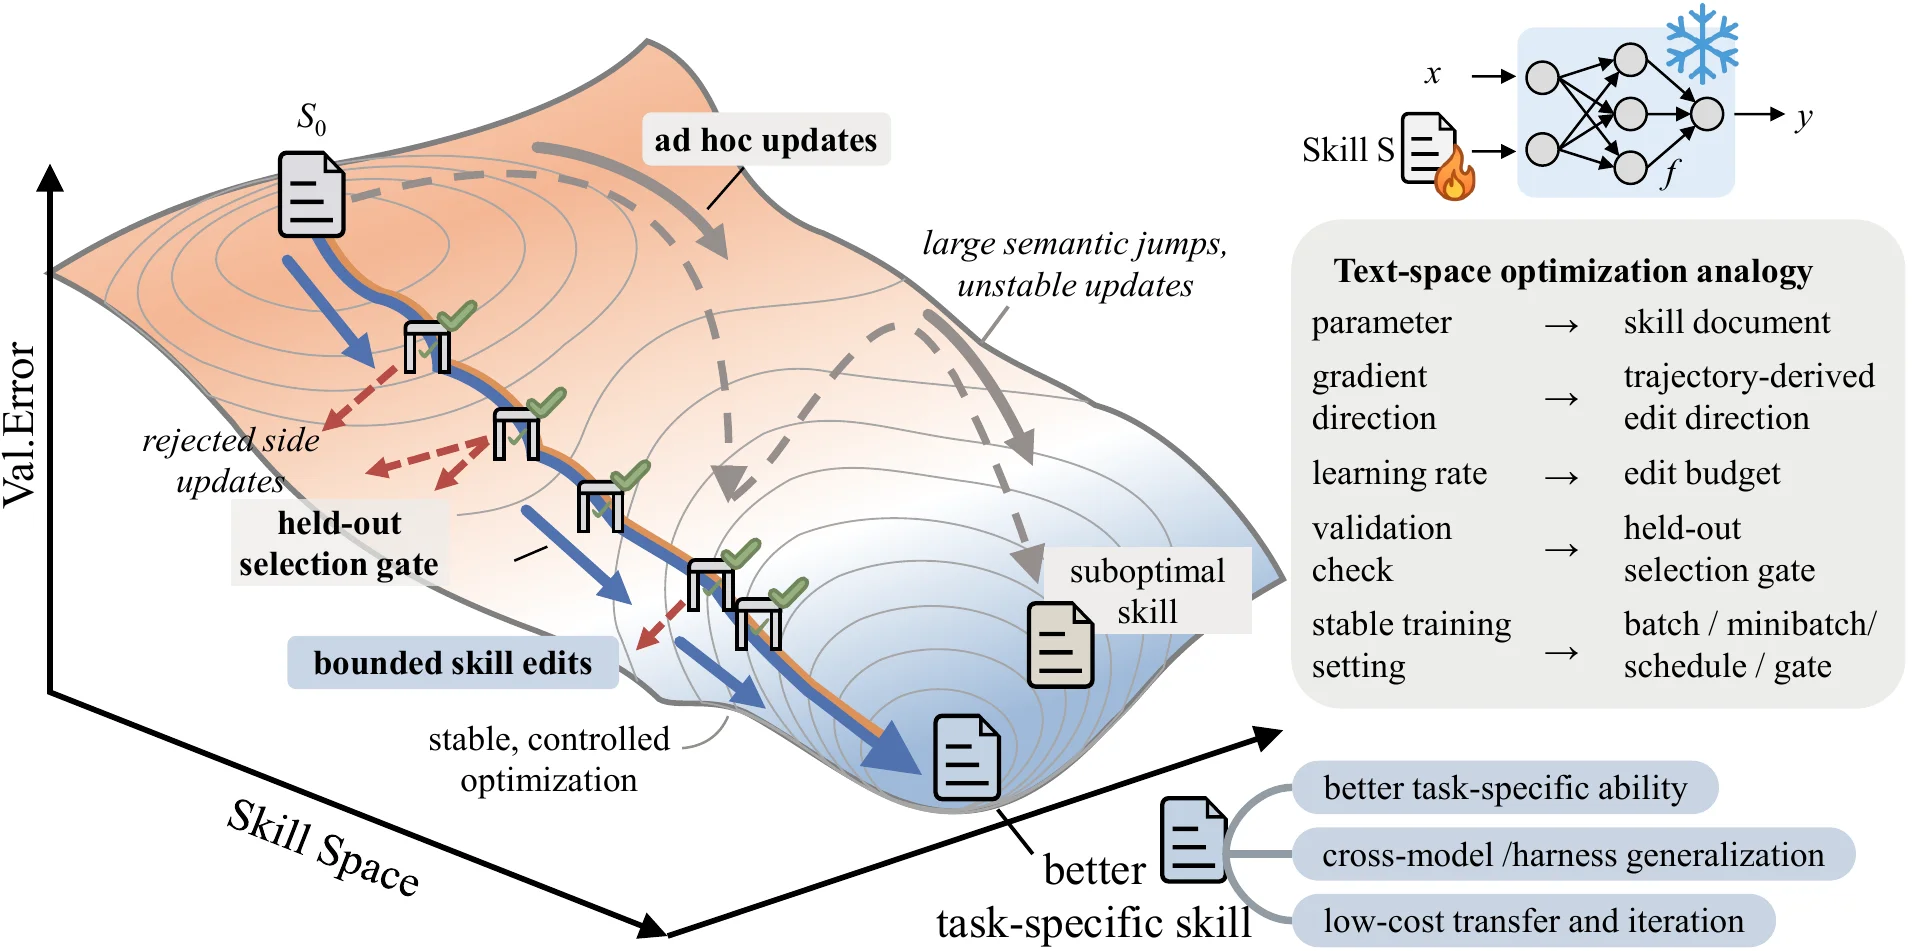
SkillOpt는 모델 가중치를 고정한 채 에이전트의 skill 문서를 최적화한다. 실패한 rollout을 읽고 규칙을 추가·삭제·교체하되, held-out validation 점수가 실제로 올랐을 때만 새 문서를 채택한다.
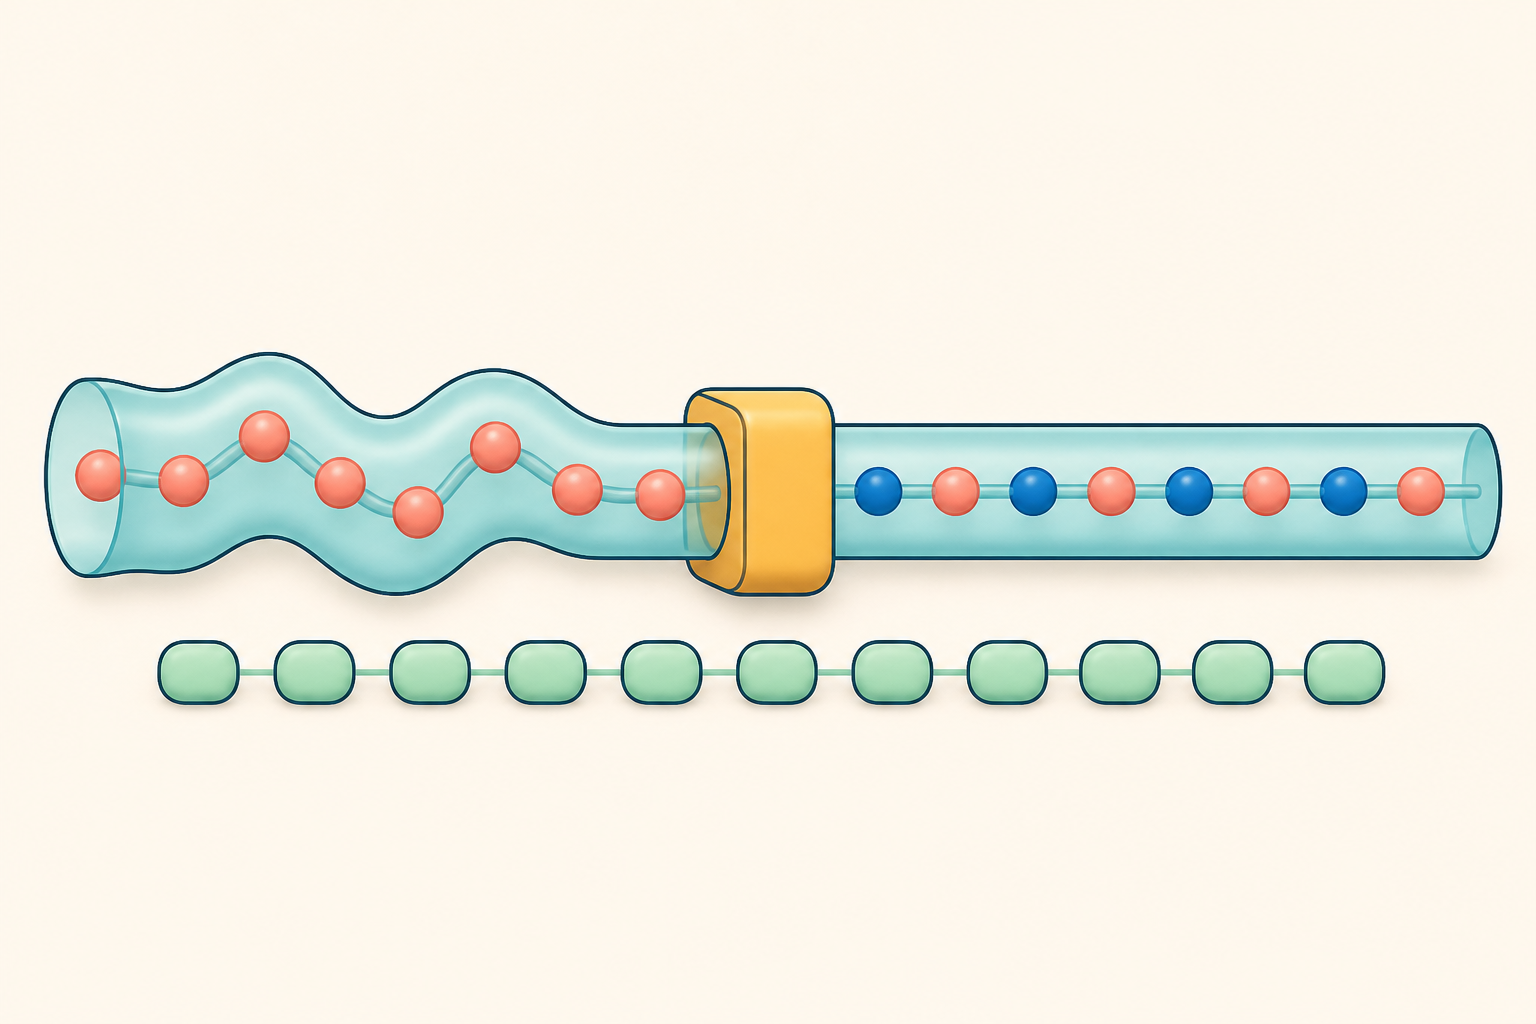
Semantic Tube Prediction(STP)은 한 token sequence 안에서 앞·뒤 hidden-state의 이동 방향을 맞추는 학습법이다. 별도의 target encoder나 두 view 없이 기존 forward의 hidden state를 재사용한다.
LLM-JEPA는 Transformer를 새로 설계하지 않는다. 기존 Next Token Prediction(NTP)에, 같은 의미를 가진 두 표현의 hidden representation을 맞추는 보조 loss를 더한다.
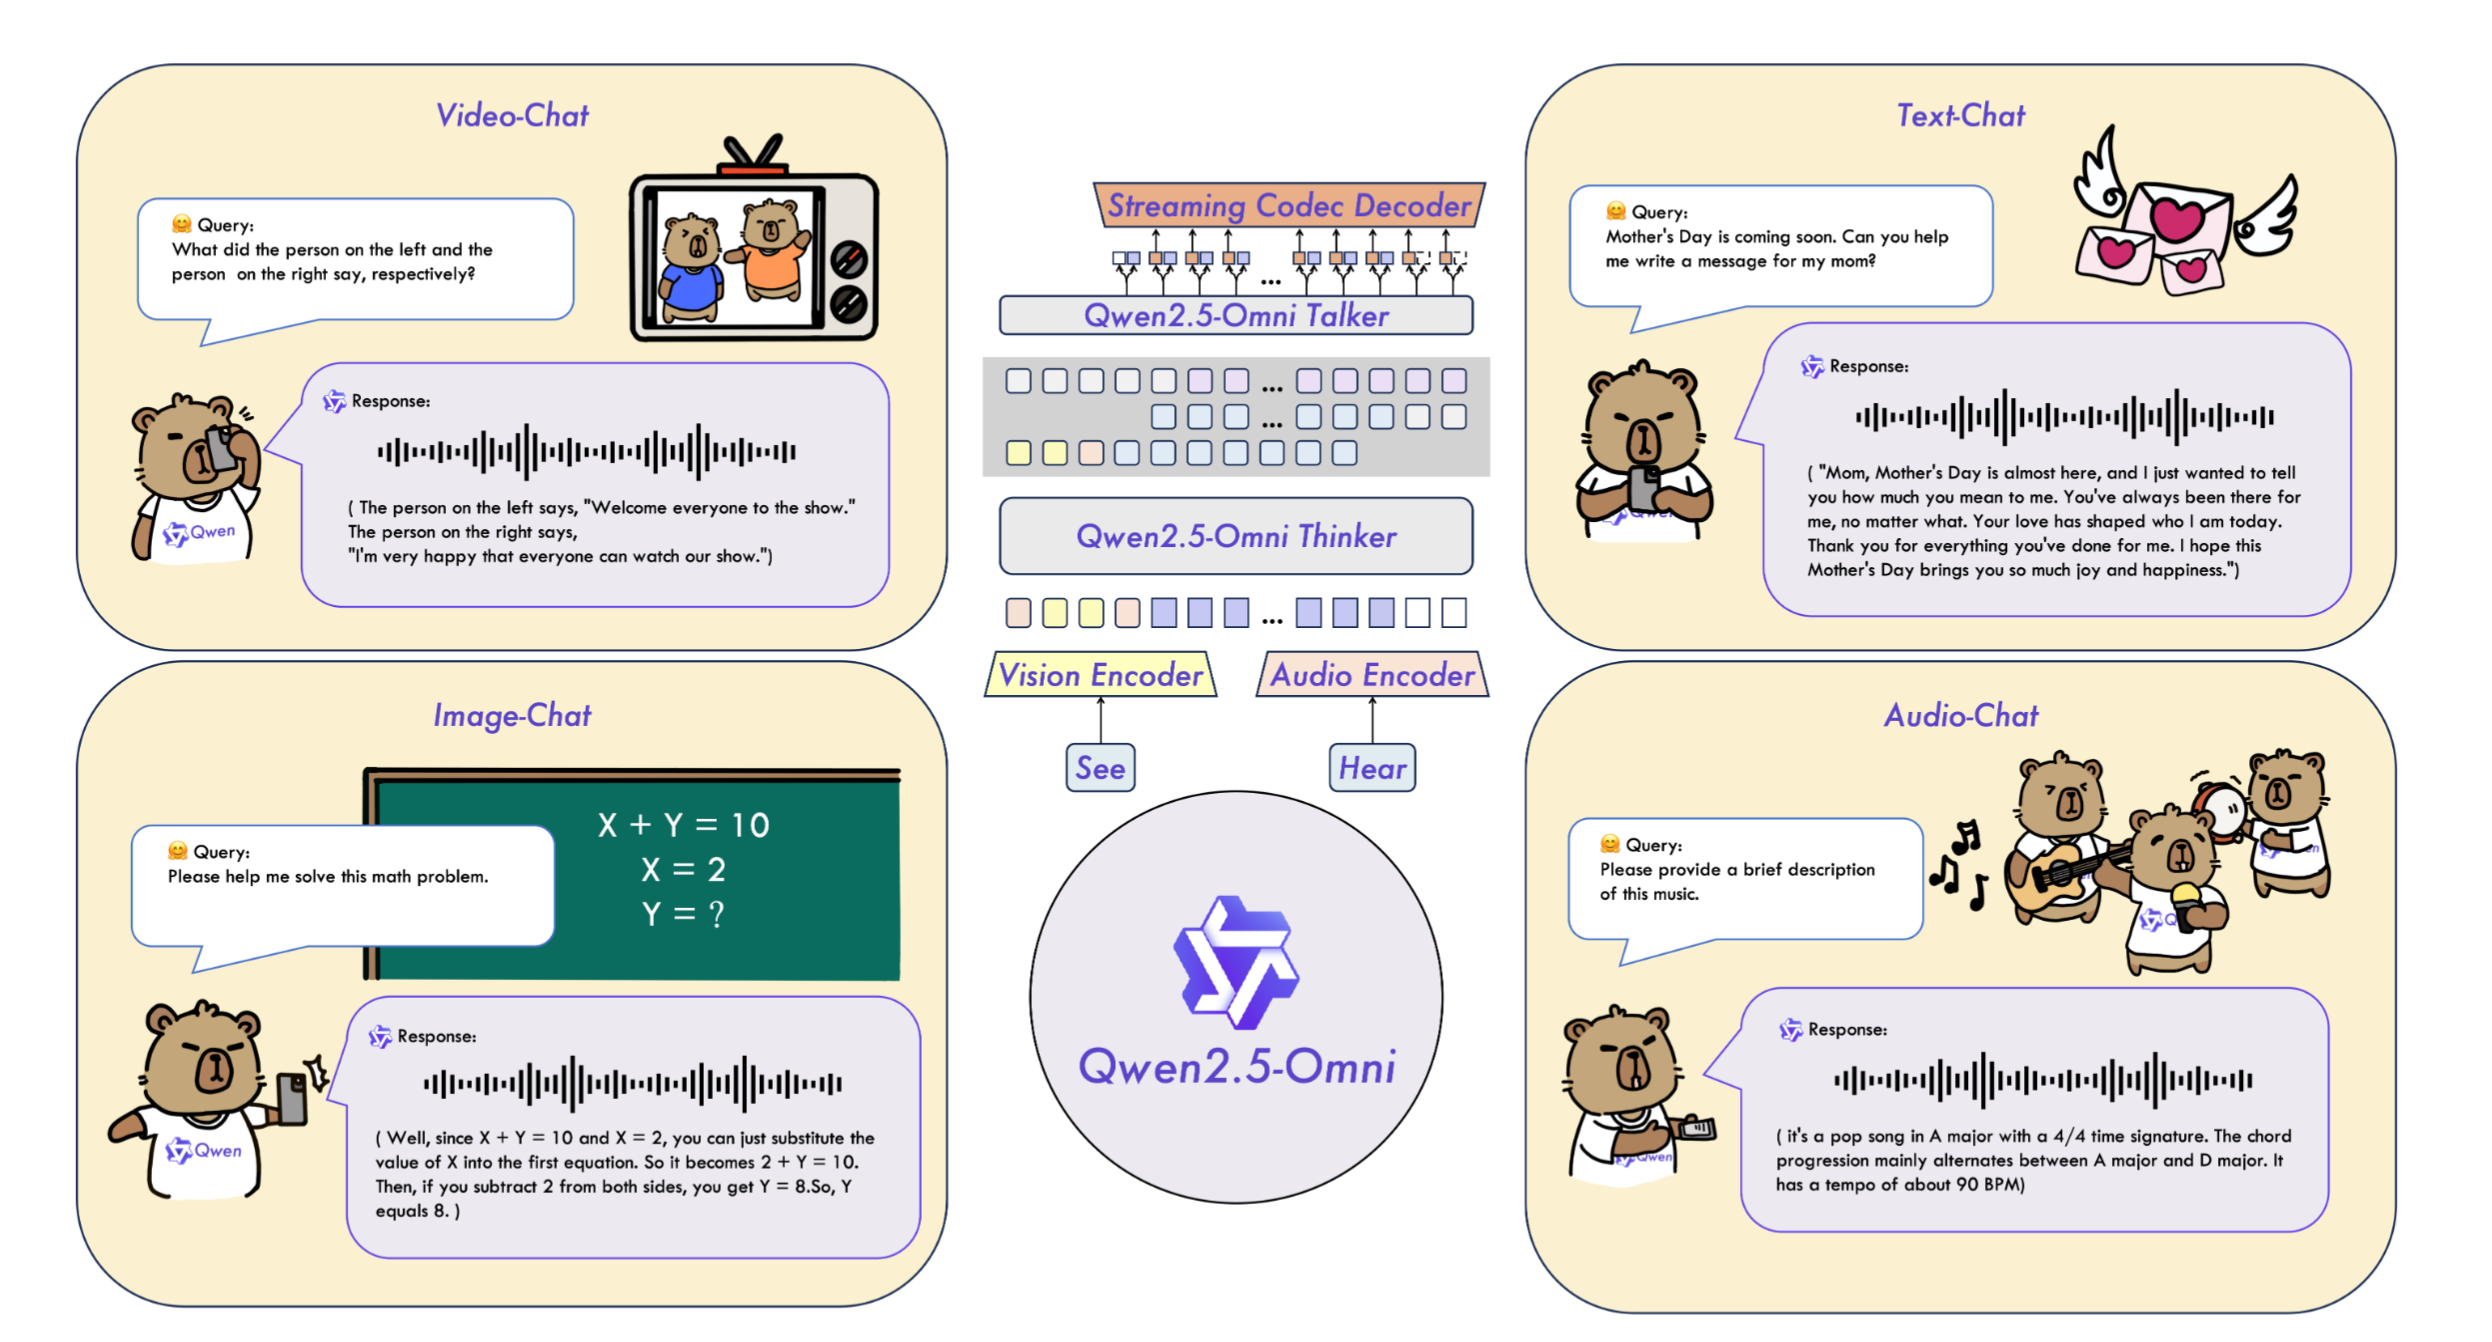
Qwen2.5-VL을 정리한 뒤, 오디오까지 함께 다루는 모델이 어떻게 구성되는지 궁금해서 Qwen2.5-Omni Technical Report를 중심으로 스터디 내용을 정리했다.
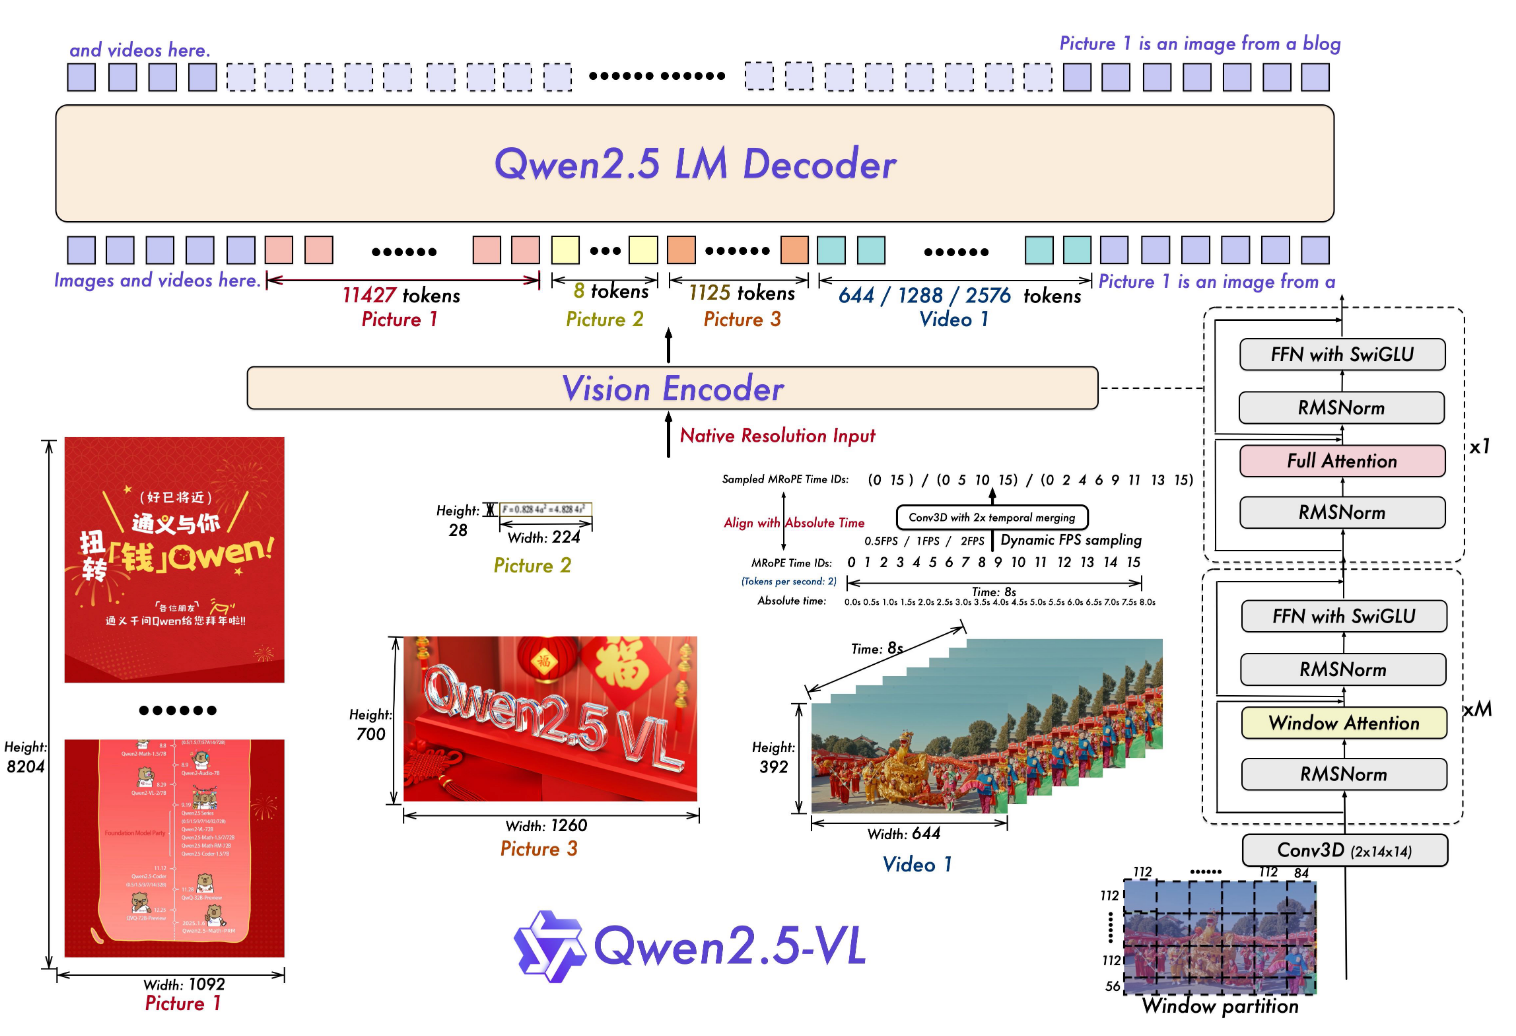
요즘 AI 서비스들은 대부분 이미지 인식 기능을 탑재하고 있다. 과연 이런 멀티모달 VLM은 실제로 어떤 모델 구조를 가지고 있을까?
똑같은 말만 하던 LLM에게 다양한 대답을 얻는 방법이 있다고한다. 훈련 없이, 오직 프롬프트만으로 다양성을 끌어올리는 접근이다.
저번에 소개한 JEPA 계열의 최신 논문, Vision-Language JEPA다. 월드 모델(world model) 관점에서 보았을 때 충분히 경쟁력 있는 비전‑언어 아키텍처로 보인다.
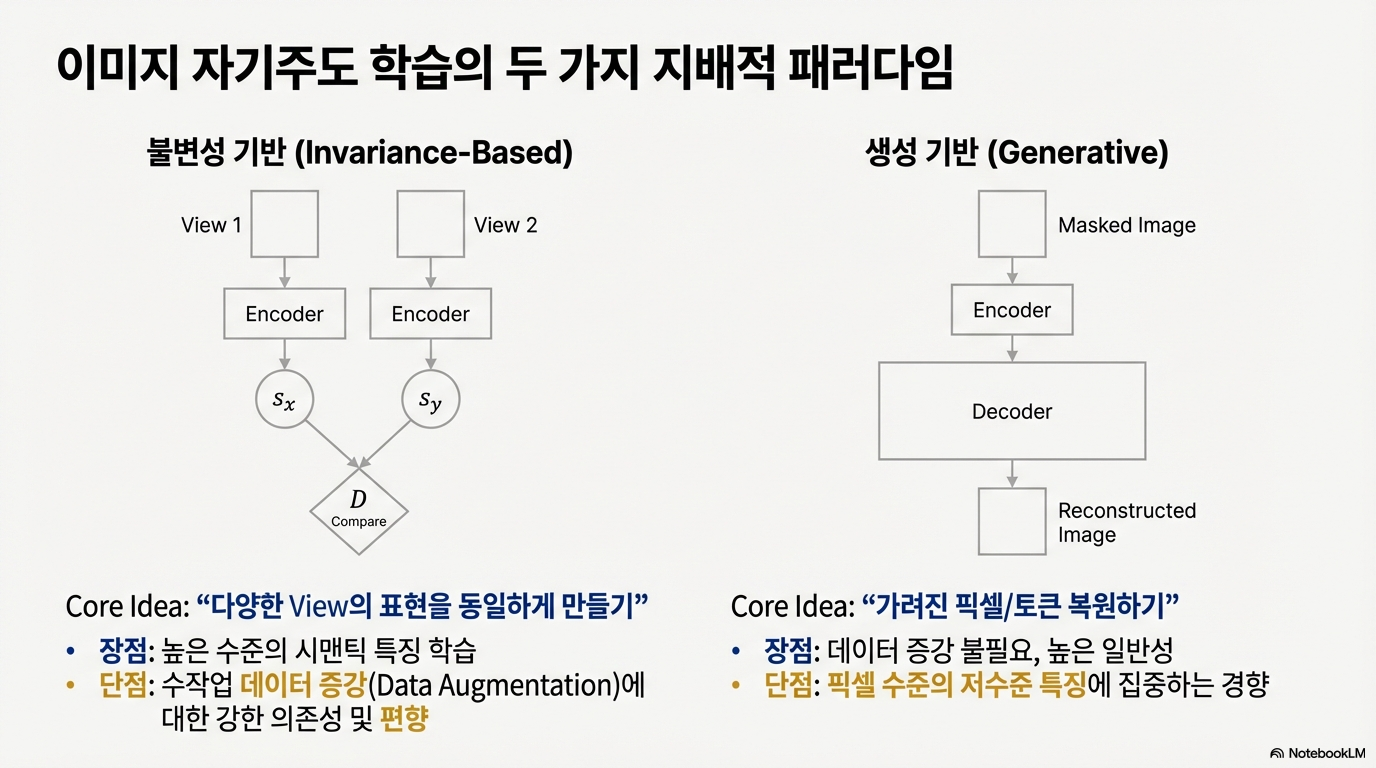
Meta의 얀 르쿤은 LLM(생성형 모델)만으로는 AGI에 도달하기 어렵다고 보고, 생성 중심 패러다임을 넘어 월드 모델을 연구하고 있다. 그 흐름 속에서 VL-JEPA, V-JEPA 등이 등장했고, I-JEPA는 JEPA 시리즈의 시작점이 되는 이미지 자기지도 학습 논문이다.
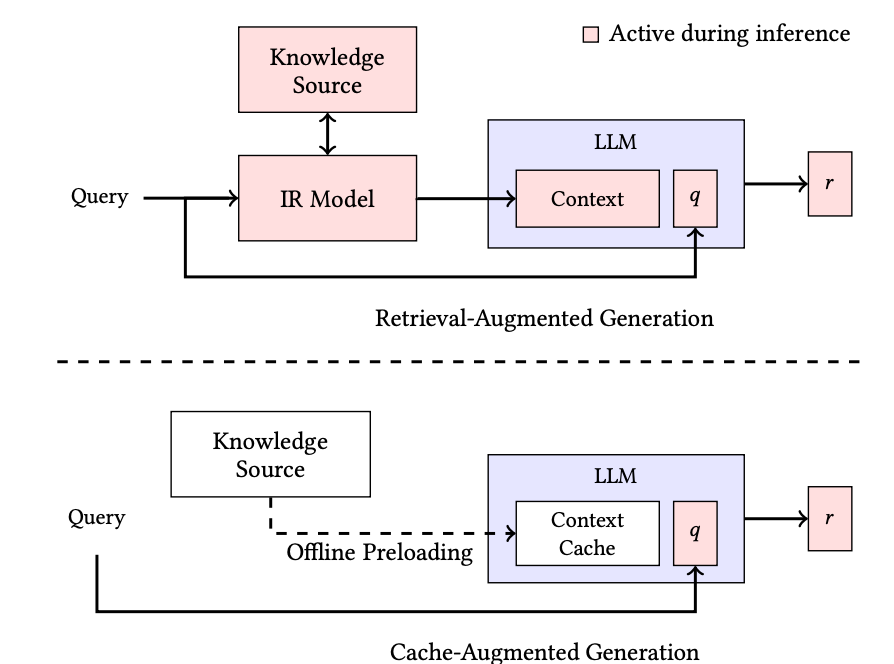
이 논문은 “RAG 대신 CAG를 쓰자”는 주장이다. (Retrieval → Cache) 핵심은 KV Cache 재활용이다.
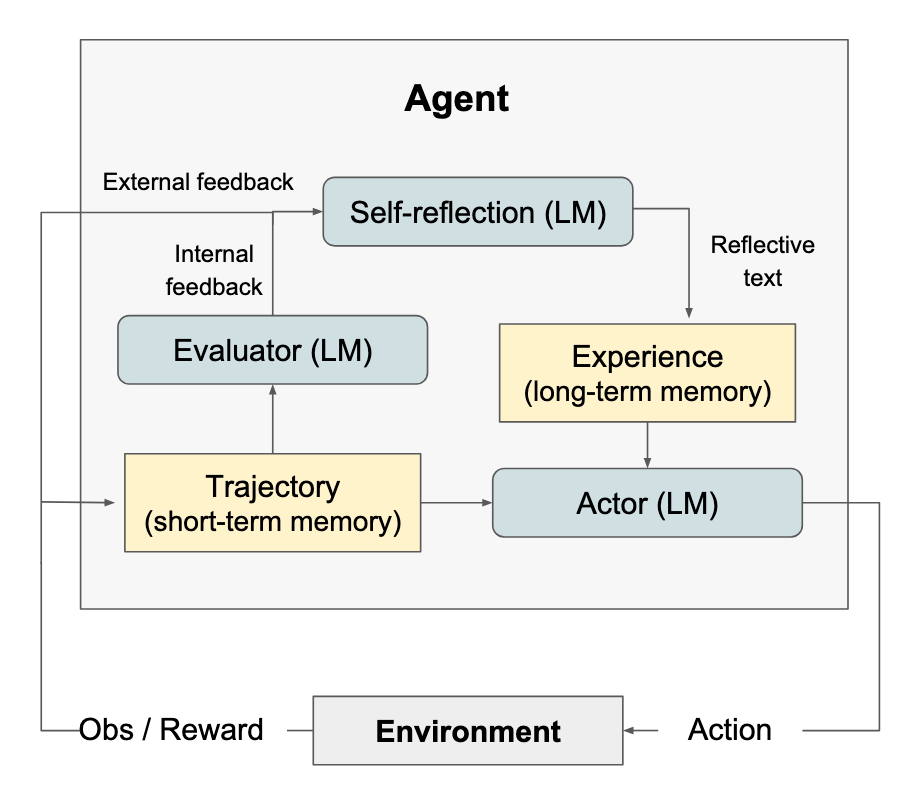
Reflexion은 2023년 10월에 나온 논문으로, LLM이 시행착오로부터 스스로 피드백을 생성하고 개선할 수 있는 프레임워크이다.
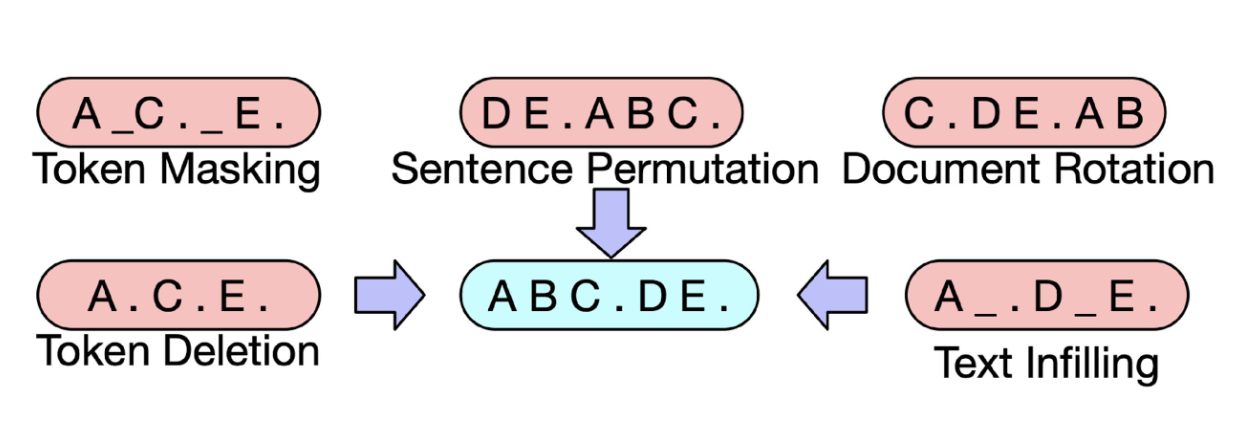
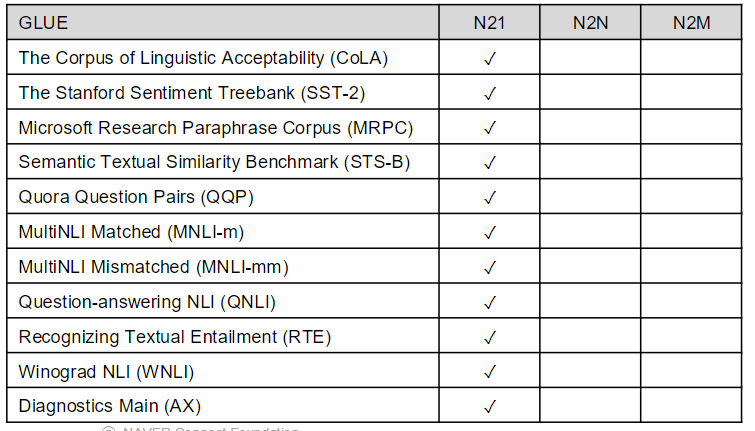
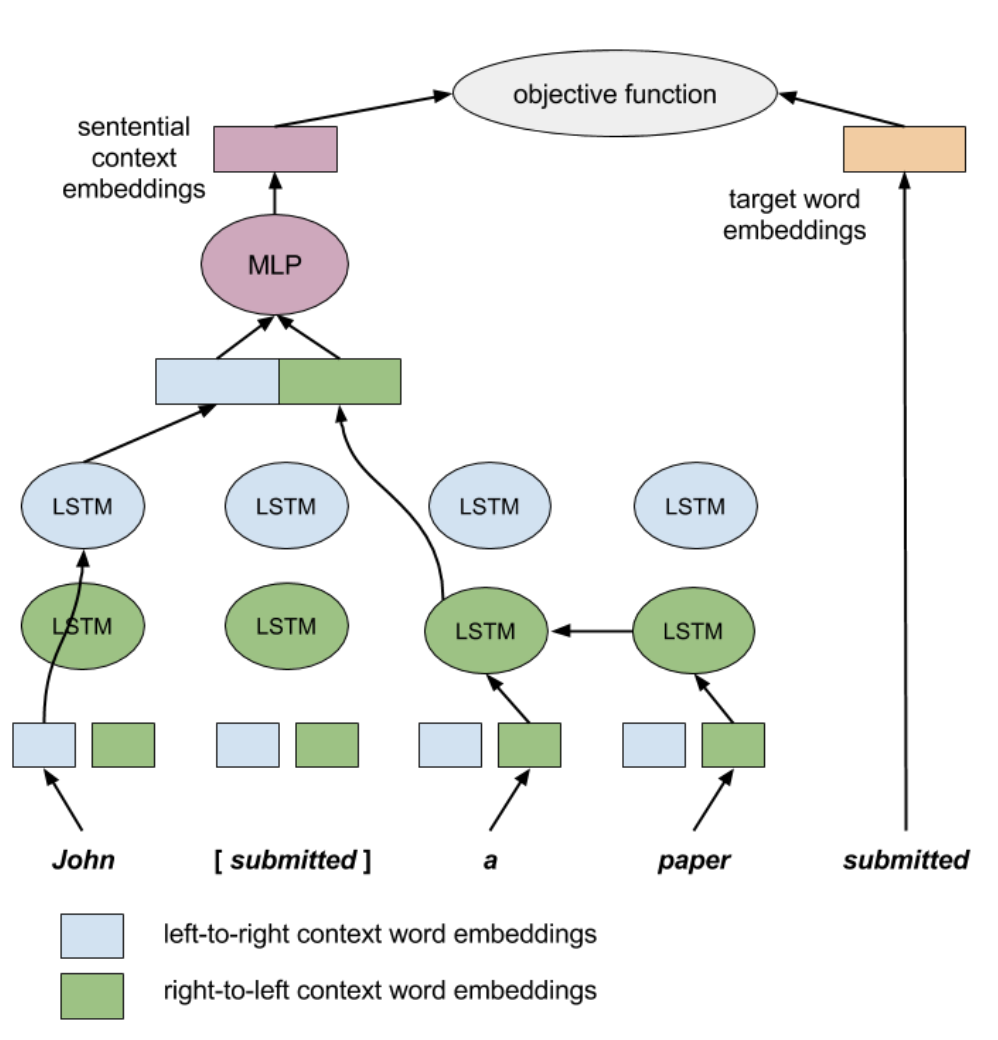
Bidrectional Encoder Representations from Transformers(BERT)는 unlabeled text로부터 좌우 문맥을 포함한 양방향 표현을 사전학습하게 설계된 모델이다. 또한, Question Answering, 언어 추론 같은 광범위한 작업에...
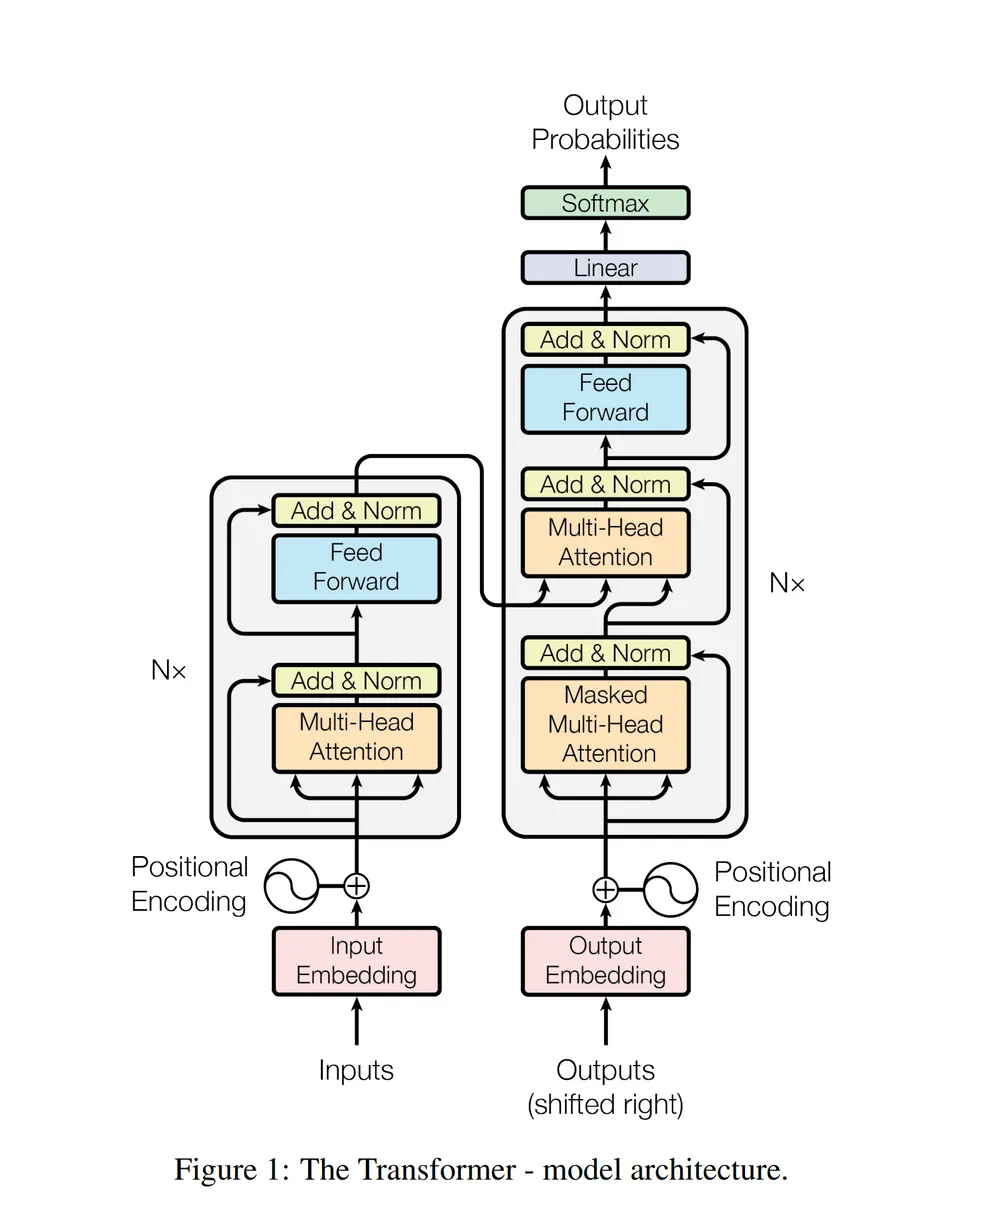
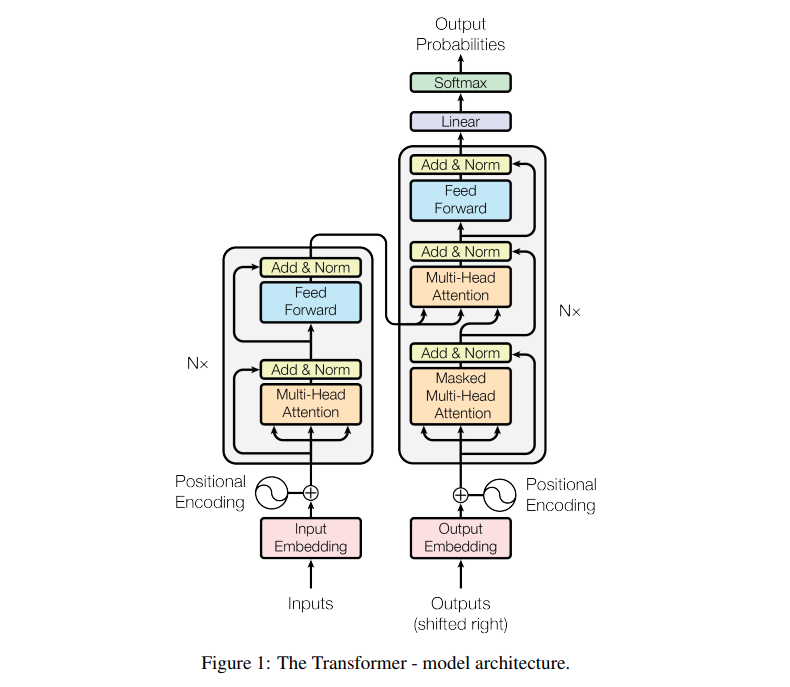
기존 sequence 변환 모델은 RNN 또는 CNN 기반의 인코더-디코더 구조를 바탕으로 한다. 최고 성능의 모델들은 여기에 attention mechanism 을 사용하고 있는데, 우리는 RNN과 CNN을 배제한 채 attention mechanism 만을 사용하는 새로운 구조...