DeepConf 논문 리뷰 - Token Confidence로 Reasoning Trace 고르기
DeepConf는 같은 문제에서 여러 reasoning trace를 생성한 뒤 모두 같은 표로 세지 않고, 모델의 token probability에서 얻은 confidence로 경로를 평가하는 test-time scaling 방법이다. 별도 학습이나 외부 verifier 없이 완성된 경로를 선별·가중하거나, 생성 도중 confidence가 무너진 경로를 조기 종료한다.
Token probability를 답의 confidence로 올리기
가장 크게 남은 점은 “다음 token의 확률 분포가 뾰족할수록 모델이 자신 있어 한다”는 내부 신호를 token 선택에만 쓰지 않고, 추론 경로와 최종 답의 confidence로 끌어올릴 수 있다는 것이다. 이미지 분류 모델이 각 class의 확률을 내고 이를 예측의 confidence로 해석하듯, 언어 모델에서도 reasoning trace에 걸친 token probability를 모으면 “이 답이 정답일 가능성이 얼마나 높은가”를 나타내는 answer-level confidence score를 만들 수 있겠다는 생각으로 이어졌다.
언어 모델의 답은 하나의 class가 아니라 길이가 가변적인 token sequence이므로 이미지 분류의 class probability를 그대로 옮길 수는 없다. 어느 token과 구간을 모을지, 긴 답과 짧은 답을 어떻게 비교할지, 중간의 불확실성을 얼마나 크게 반영할지가 필요하다. DeepConf의 평균, bottom 10%, lowest group과 tail confidence는 이 aggregation을 구체화한 사례다. 다만 논문이 만든 값은 정답 여부와 상관관계가 있는 score이지, $P(\text{correct}\mid x)$로 calibration된 정답 확률은 아니다. 자신 있는 오답도 있으므로 둘을 같게 취급하면 안 된다.
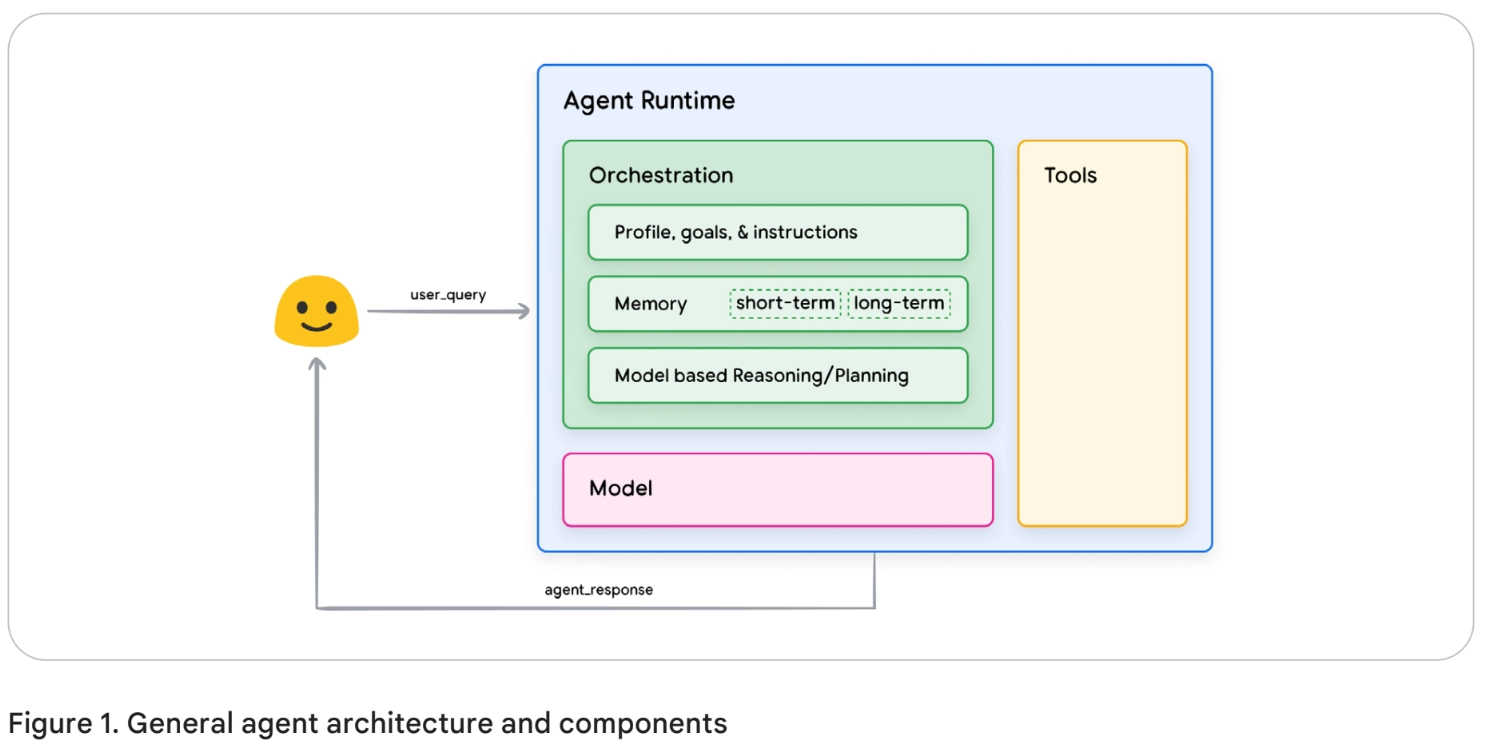
이 방식은 같은 문제에서 여러 경로를 만들고 최종 답을 서로 비교할 수 있는 수학 올림피아드 같은 단답형 추론에 특히 잘 맞는다. 논문이 말하는 online도 병렬 reasoning trace를 생성하는 도중 낮은 confidence 경로를 끊는다는 뜻이지, 외부 도구와 환경 상태가 계속 바뀌는 실시간 agent interaction을 뜻하지 않는다.
Agent에서는 경로마다 관찰한 상태와 실행한 tool call이 달라 최종 답 문자열만으로 vote하기 어렵고, 한 단계의 낮은 token confidence가 전체 task 실패를 뜻하지도 않는다. Agent에 적용하려면 token confidence만 모으는 데서 그치지 않고 상태·행동 단위의 성공 기준, tool 결과를 포함한 verifier와 장기 credit assignment가 함께 필요하다.
Parallel thinking의 낭비
Self-consistency는 같은 prompt에서 서로 다른 reasoning path를 sampling하고 최종 답을 majority vote한다. 단일 경로보다 안정적이지만 trace 수에 비례해 token이 늘고, 확신 있게 전개된 경로와 중간에 흔들린 경로를 같은 한 표로 취급한다. Trace를 512개까지 늘려도 정확도 향상은 점차 포화된다.
DeepConf의 질문은 “더 많은 경로를 만들 것인가”보다 “어떤 경로에 계산과 표를 줄 것인가”에 가깝다. Offline 방식은 이미 완성된 trace에서 낮은 confidence 경로를 버리고, online 방식은 생성 중 낮은 confidence 구간이 나타난 trace를 끝까지 만들지 않는다.
Token confidence에서 trace confidence까지
Token $i$에서 확률이 높은 상위 $k$개 후보를 $P_i(j)$라 하면 token confidence는 다음과 같다.
\[C_i=-\frac{1}{k}\sum_{j=1}^{k}\log P_i(j)\]논문과 공식 구현은 $k=20$을 사용한다. 한 token만 고립해서 보는 정답 확률이 아니라 상위 후보들의 분포가 얼마나 한쪽으로 기울었는지를 나타내는 내부 신호다. 값이 클수록 모델이 한 선택에 더 강하게 수렴한 상태로 해석한다.
Trace 전체 평균은 길이가 $N$일 때 다음과 같다.
\[C_{\mathrm{avg}}=\frac{1}{N}\sum_{i=1}^{N}C_i\]평균값은 올바른 trace와 틀린 trace를 어느 정도 가르지만, 긴 추론의 한 구간에서 발생한 confidence 급락을 나머지 token이 덮을 수 있다. DeepConf는 현재 token까지 최근 $n$개 token으로 겹치는 window $G_i$를 만들고 group confidence를 계산한다.
\[C_{G_i}=\frac{1}{|G_i|}\sum_{t\in G_i}C_t\]여기서 파생한 지표는 세 가지다.
- Bottom 10% group confidence는 한 trace에서 가장 낮은 group confidence 10%의 평균이다.
- Lowest group confidence $C_{\mathrm{least}}(t)=\min_{G_j\in G}C_{G_j}$는 가장 불확실했던 단일 구간만 본다.
- Tail confidence는 마지막 $K$개 token의 평균이며, 실험에서는 $K=2{,}048$을 사용한다.
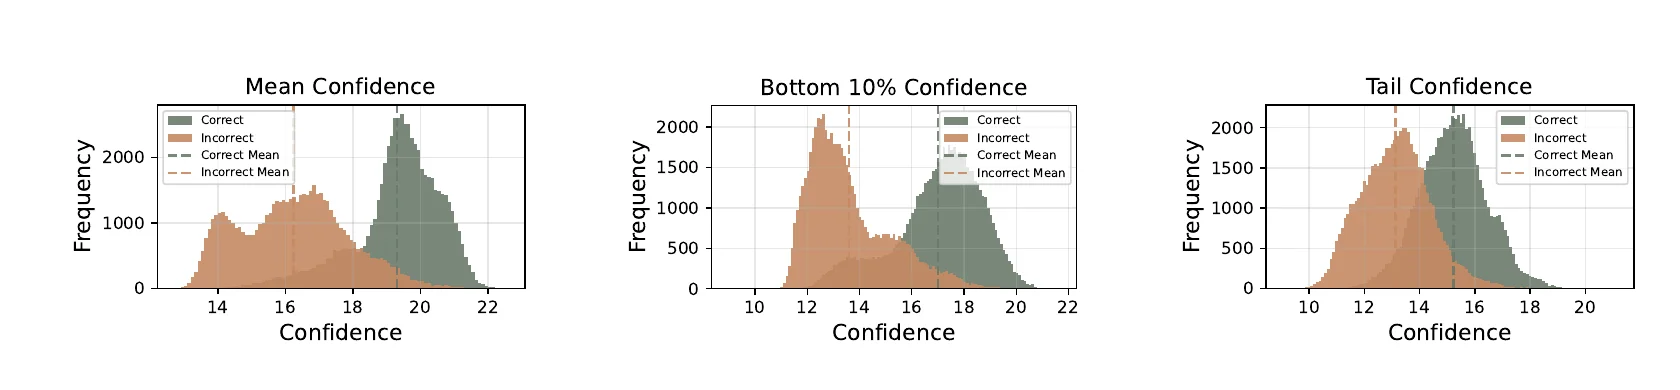
HMMT25의 문제당 4,096개 trace 분포를 보면 정답 trace의 confidence가 오답보다 오른쪽에 놓인다. 전체 평균보다 bottom 10%와 tail에서 두 분포가 더 분명히 갈린다. 저자들은 wait, however, think again처럼 추론이 재검토로 흔들리는 구간의 낮은 confidence가 이후 오류와 연결될 수 있다고 본다. 다만 분포가 겹치므로 confidence만으로 정답을 판정할 수 있다는 결과는 아니다.
Offline DeepConf
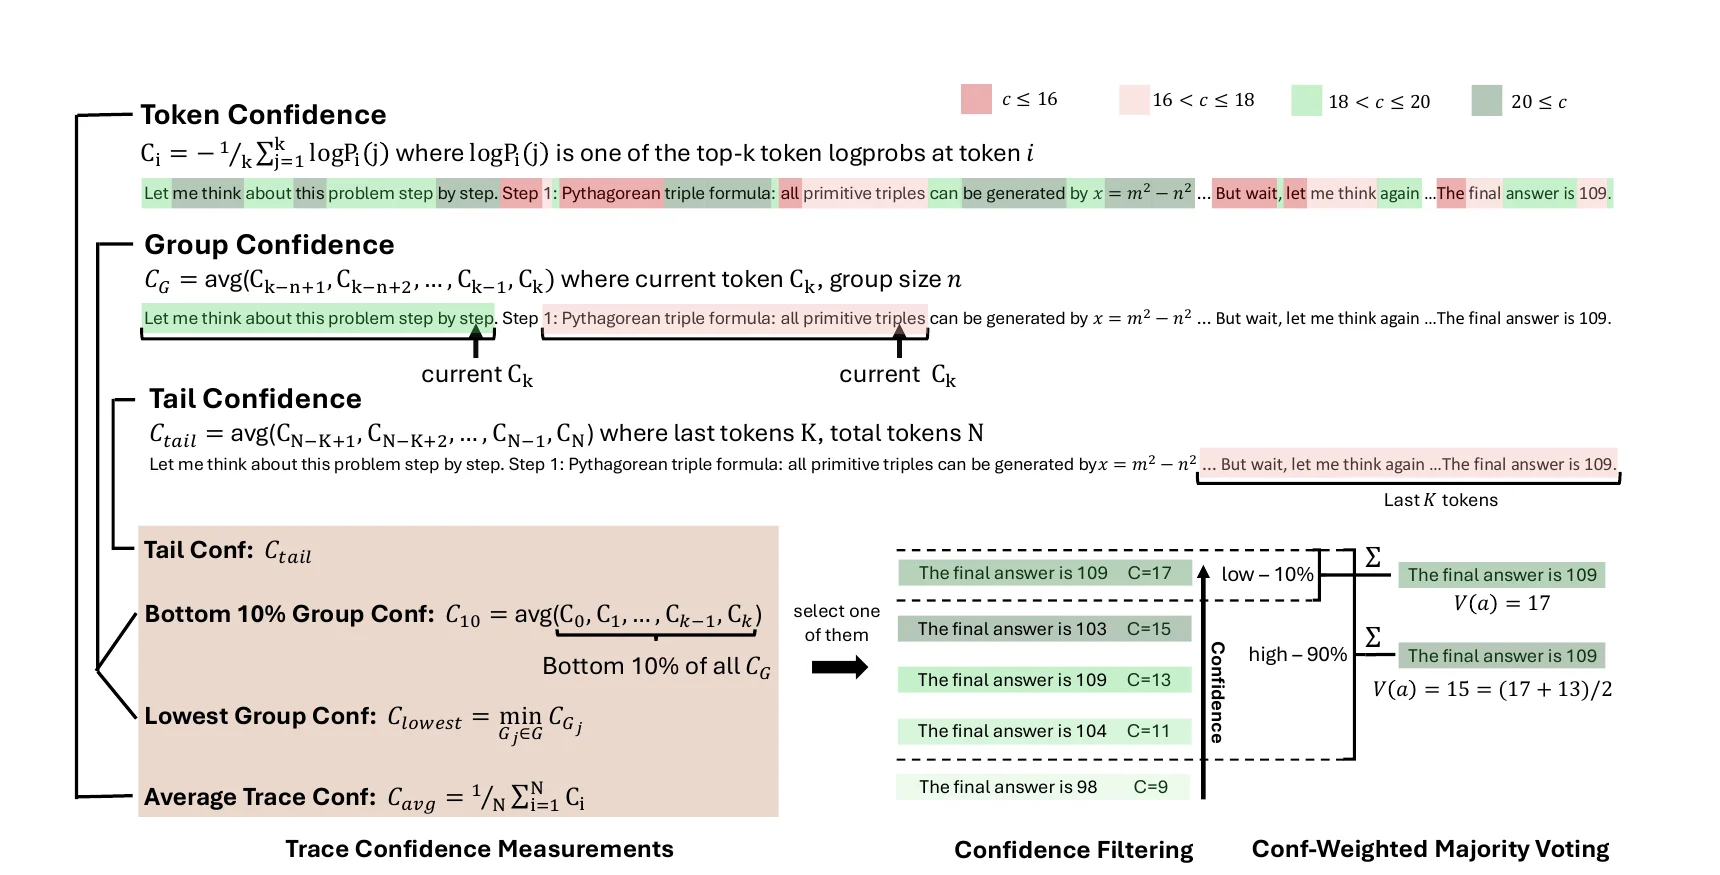
Offline 방식은 문제당 $K$개의 완성된 trace에 confidence를 매기고 상위 $\eta\%$만 남긴다. 남은 trace가 답 $a$에 주는 표도 1이 아니라 trace confidence $C_t$로 가중한다.
\[V(a)=\sum_{t\in T}C_t\,\mathbf{1}[\operatorname{answer}(t)=a]\] \[\hat a=\arg\max_a V(a)\]상위 10%만 남기는 설정은 소수의 높은 confidence 경로에 집중해 이득이 클 수 있지만, 모델이 같은 오답을 자신 있게 반복하면 diversity를 잃는다. 상위 90%를 유지하는 설정은 낮은 confidence 경로만 걷어내므로 정확도 상승은 작아도 더 보수적이다.
Online DeepConf
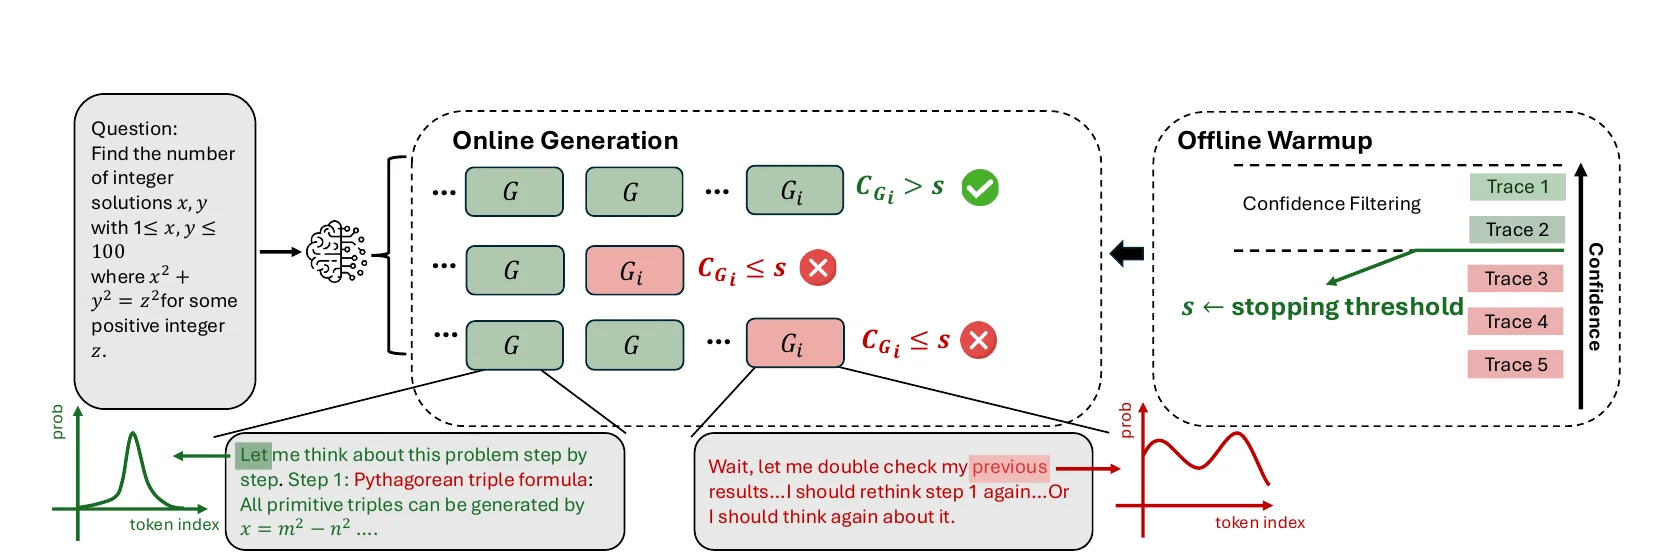
Online 방식도 곧바로 한 경로만 생성하는 방식은 아니다. 새 prompt마다 먼저 $N_{\mathrm{init}}=16$개의 완성된 warmup trace를 만들고, lowest group confidence의 percentile로 중단 기준 $s$를 정한다.
\[s=\operatorname{Percentile}_{100-\eta}\left(\{C_t:t\in T_{\mathrm{warmup}}\}\right)\]이후 병렬 trace를 생성하면서 2,048-token group confidence가 $s$ 아래로 내려가면 그 trace를 중단한다. DeepConf-low는 상위 10%를 남기는 $\eta=10$의 공격적인 기준이고, DeepConf-high는 상위 90%를 남기는 $\eta=90$의 보수적인 기준이다.
완성된 trace는 offline과 같은 confidence-weighted vote에 들어간다. 현재 1위 답 $\hat a$의 표 비중
\[\beta=\frac{V(\hat a)}{\sum_a V(a)}\]가 $\tau=0.95$에 도달하면 새 trace sampling도 멈추고, 합의가 나지 않으면 최대 budget $K$까지 계속한다. 따라서 token 절감은 낮은 confidence 경로의 조기 종료와 문제별 합의에 따른 sampling 종료가 함께 만든다.
실험 결과를 읽는 법
실험은 DeepSeek-R1-0528-Qwen3-8B, Qwen3-8B·32B, GPT-OSS-20B·120B를 AIME24·25, BRUMO25, HMMT25와 GPQA-Diamond에 적용했다. 문제마다 완성된 trace 4,096개를 미리 만들고, 여기서 최대 $K=512$개의 working set을 다시 뽑는 실험을 64회 반복했다. Online 평가는 이 공통 pool로 생성과 조기 종료를 모사했으므로 실제 serving의 latency까지 측정한 결과는 아니다.
Offline 결과에서 GPT-OSS-120B의 AIME25 정확도는 단일 trace 91.8%, 512개 majority vote 97.0%, tail confidence로 상위 10%를 남겼을 때 99.9%였다. DeepSeek-8B AIME25는 82.3%에서 bottom 10% 기준 87.5%로, Qwen3-32B AIME24는 85.3%에서 90.8%로 올랐다.
공격적 filtering이 항상 이기지는 않았다. GPT-OSS-120B의 BRUMO25는 majority vote 86.7%보다 bottom 10% 상위 10% 결과가 82.9%로 낮았고, HMMT25도 92.9%에서 tail 상위 10%가 88.9%로 떨어졌다. 높은 confidence와 정답이 같지 않으며, model·dataset별로 자신 있는 오답이 모일 수 있다는 반례다.
Online AIME25에서 GPT-OSS-120B의 512-trace majority vote는 $3.23\times10^8$ token으로 97.1%를 기록했다. DeepConf-high는 $1.42\times10^8$ token으로 97.0%, DeepConf-low는 $0.49\times10^8$ token으로 97.9%였다. 최대 84.7% token 절감은 이 DeepConf-low 설정의 결과다. 반면 Qwen3-32B BRUMO25에서는 DeepConf-low가 93.3%에서 92.4%로 낮아져, 절감률과 정확도 사이의 trade-off가 다시 나타났다.
Self-consistency에서 compute routing으로
Self-consistency는 다양한 경로를 만든 뒤 최종 답의 빈도로 합의한다. Early-stopping self-consistency는 답의 표가 충분히 모이면 추가 trace sampling을 멈춘다. Self-Certainty 계열은 완성된 response의 내부 token distribution으로 best-of-N을 고른다.
DeepConf는 이 흐름에서 trace의 평균 confidence보다 가장 약한 구간을 본다. 그 결과 “몇 개의 완성된 경로를 더 만들지”뿐 아니라 “현재 생성 중인 이 경로를 계속 만들지”까지 내부 신호로 결정한다. 외부 reward model이나 verifier 없이 test-time compute를 배분한다는 점이 의의지만, verifier가 확인하는 정답성을 confidence가 대신 보장하는 것은 아니다.
Confidence가 정답을 보장하지 않는 지점
- 자신 있는 오답은 filtering과 weighted vote에서 오히려 영향력이 커진다. Confidence calibration이나 별도 uncertainty 추정이 필요한 이유다.
- 상위 $k$개 token log-probability를 계속 읽어야 하므로, 해당 분포를 노출하지 않는 hosted API에는 그대로 적용할 수 없다. 공식 구현은 vLLM 기반 open-weight model을 전제로 한다.
- Online 방식도 prompt마다 16개의 완성된 warmup trace가 필요하다. 2,048-token window를 채우기 전에 끝나는 짧은 trace에서는 조기 종료 이점도 제한된다.
- 평가 과제는 최종 답을 추출하고 같은 답끼리 묶을 수 있는 수학·과학 문제다. 서술형 품질, tool 사용, 환경 변화와 장기 상호작용의 성공은 평가하지 않았다.
- 추가 학습은 없지만 설정값이 없는 방법은 아니다. Top-$k=20$, window 2,048, warmup 16, 유지 비율 10%·90%와 합의 기준 0.95가 비용·정확도·diversity를 바꾼다.
참고 자료
공유하기
X LinkedIn'Paper Review' 카테고리의 다른 글

댓글남기기