DeepSeek-V4 리뷰 - 100만 토큰 Architecture와 System
DeepSeek-V4는 100만 토큰 context를 처리하기 위해 attention 하나만 바꾼 모델이 아니다. Residual connection, MoE, optimizer, kernel, KV cache, RL rollout과 post-training을 같은 목표에 맞춰 함께 설계했다.
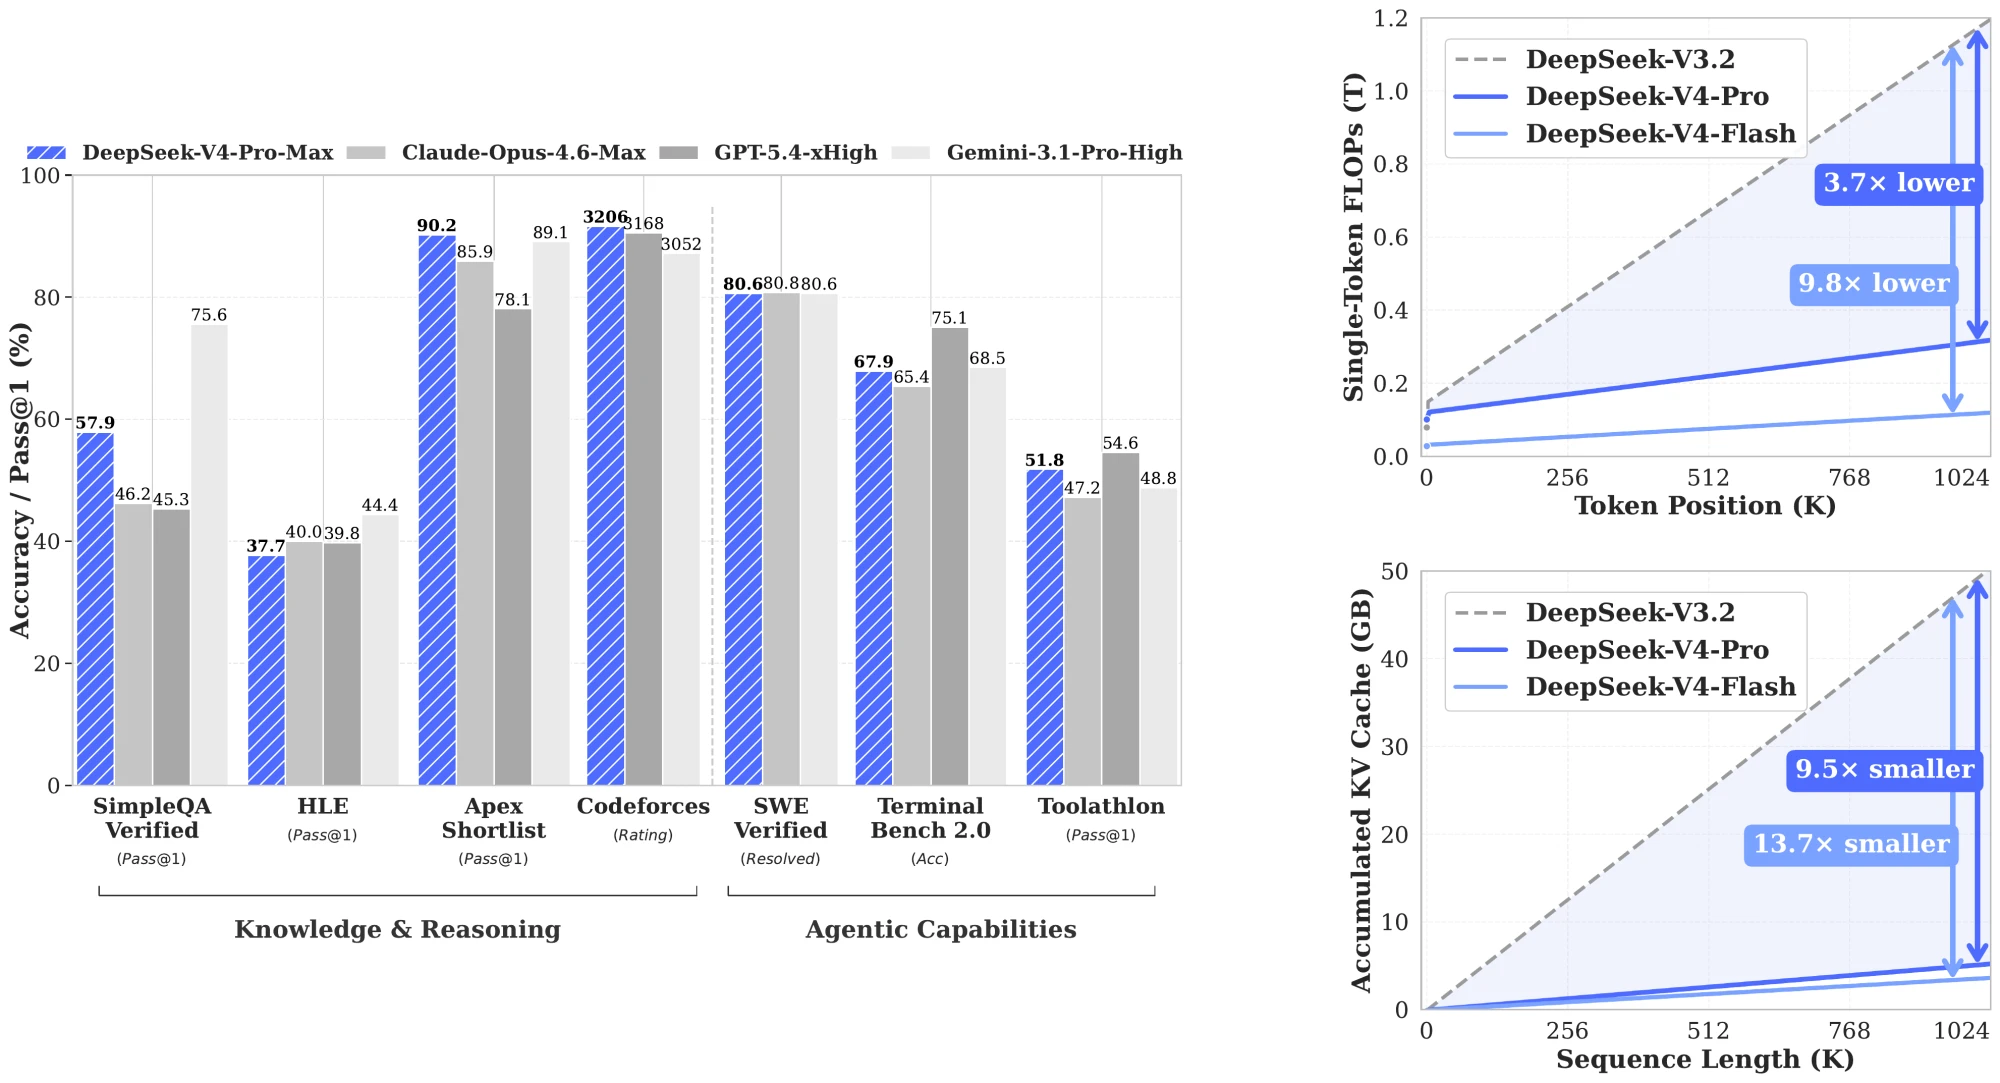
이 글은 기술 보고서가 평가한 preview 버전의 DeepSeek-V4-Flash와 DeepSeek-V4-Pro를 다룬다. 공식 model collection에 이후 공개된 checkpoint의 변경점과 성능은 보고서의 검증 범위가 아니다.
총평
이 보고서의 가치는 새로운 아이디어 하나보다 최신 frontier LLM을 실제로 성립시키는 구성요소가 어떻게 연결되는지 보여주는 데 있다.
- CSA와 HCA: 먼 과거의 KV를 압축하고 선택적으로 읽는다.
- mHC: Residual stream을 네 갈래로 넓히되 혼합 행렬을 안정적인 범위로 제한한다.
- Muon: 대부분의 2D weight에 직교화한 momentum update를 적용한다.
- MoE와 system 공동 설계: Expert 통신, fused kernel, cache와 storage를 architecture에 맞춘다.
- Specialist와 OPD: 수학·코딩·agent specialist를 따로 만든 뒤 여러 teacher의 분포를 한 model에 통합한다.
가장 인상적인 부분은 CSA와 HCA 자체보다 compression state cache, Lightning Indexer, grouped output projection, fused MoE kernel, million-token RL과 token-level WAL까지 하나의 system으로 연결한 점이다.
반면 CSA·HCA·mHC·Muon·data·model size·post-training을 동시에 바꿨는데 component ablation은 부족하다. 최종 성능 향상을 어느 기법의 공으로 돌려야 하는지는 분리하기 어렵다.
Flash와 Pro
| 항목 | DeepSeek-V4-Flash | DeepSeek-V4-Pro |
|---|---|---|
| 전체 parameter | 284B | 1.6T |
| Token당 active parameter | 13B | 49B |
| Transformer layer | 43 | 61 |
| Hidden dimension | 4,096 | 7,168 |
| Routed expert | 256개 중 6개 | 384개 중 6개 |
| Shared expert | 1개 | 1개 |
| CSA compression / top-k | 4 / 512 | 4 / 1,024 |
| HCA compression | 128 | 128 |
| Local sliding window | 128 tokens | 128 tokens |
| Pre-training token | 32T | 33T |
| 최대 context | 1M | 1M |
Flash는 더 작은 active parameter로 reasoning budget을 길게 가져가는 위치에 있고, Pro는 knowledge와 복합 agent task에서 더 강하다. 두 모델은 inference cost와 capability 사이의 서로 다른 지점을 보여주지만, 작은 model이 큰 model을 일반적으로 대체한다는 실험은 아니다.
보고서가 강조하는 1M context 효율은 DeepSeek-V3.2 대비 single-token inference FLOPs와 누적 KV cache 추정치다. Pro는 각각 27%와 10%, Flash는 10%와 7%다. End-to-end latency, throughput, 전력이나 전체 serving cost가 같은 비율로 줄었다는 뜻은 아니다.
전체 Architecture
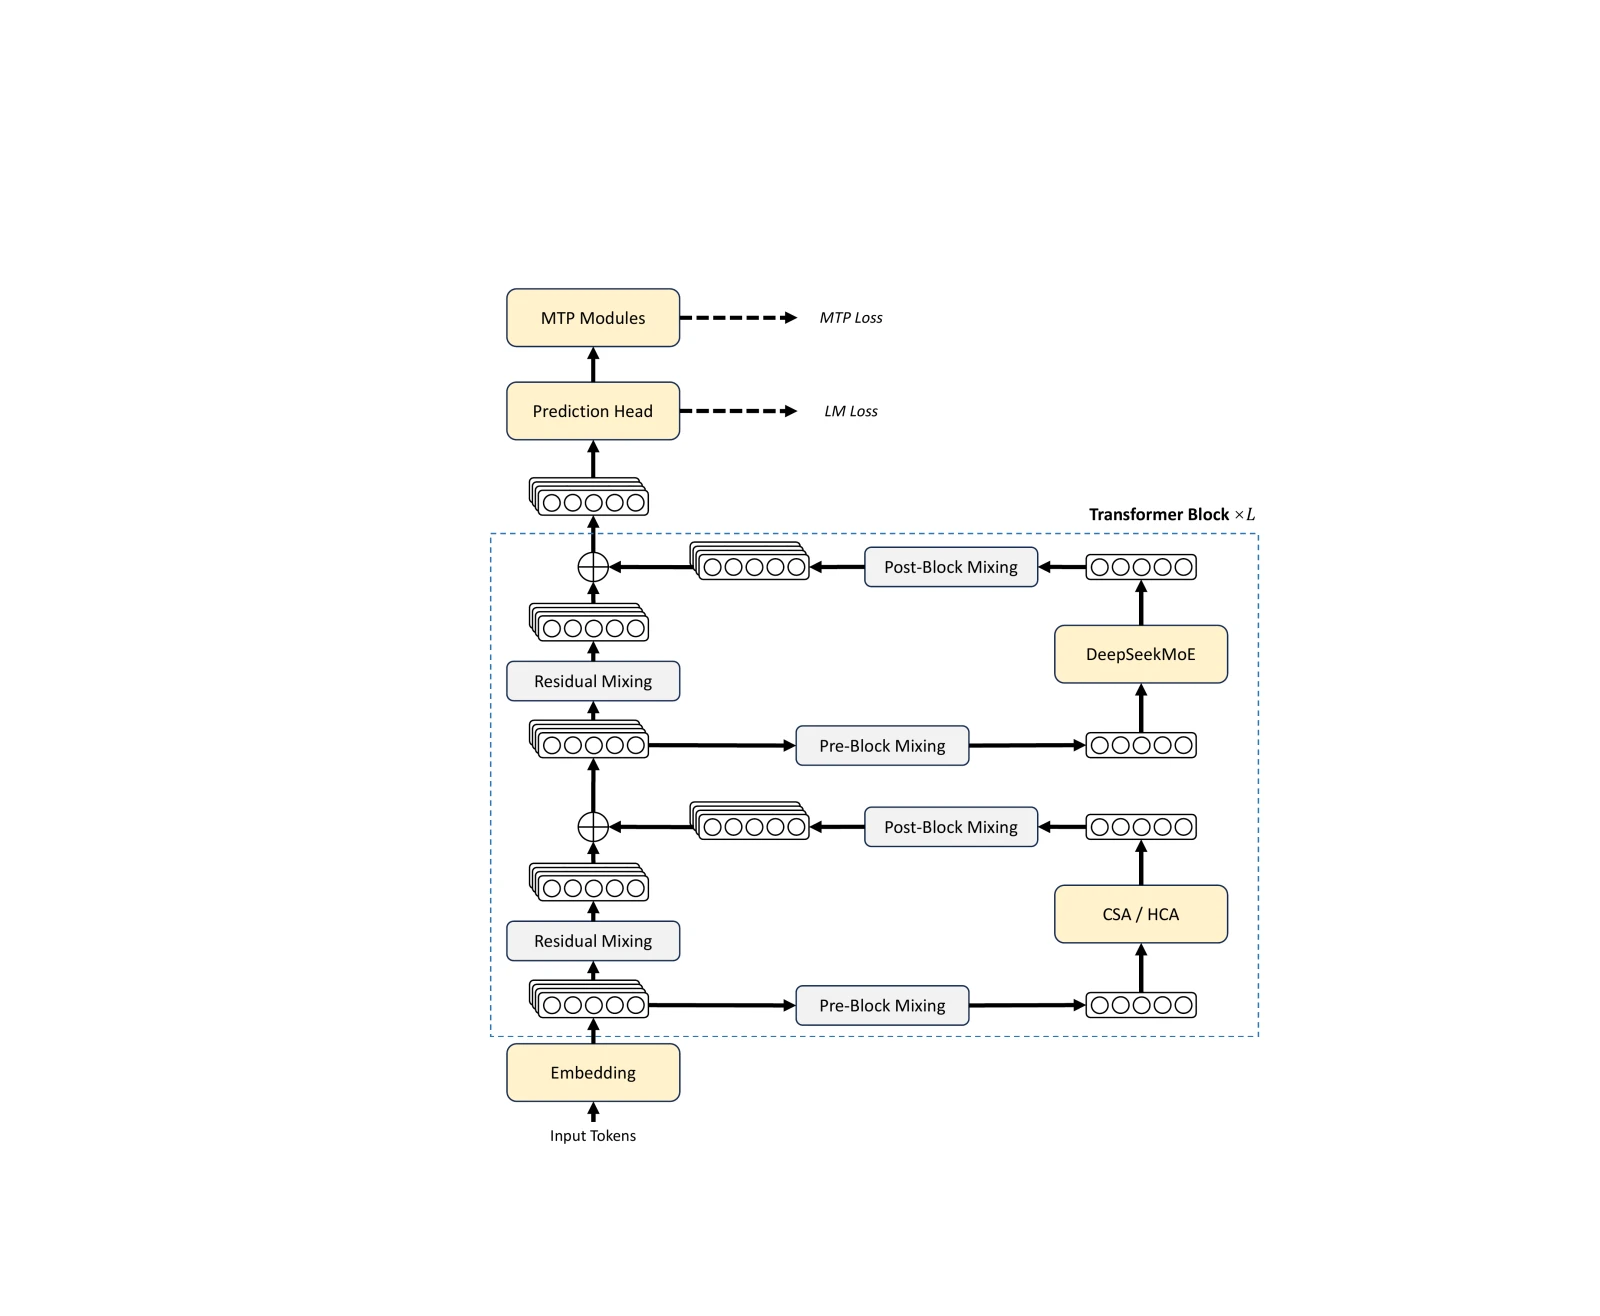
기본 뼈대는 decoder-only Transformer다. Attention은 CSA 또는 HCA, FFN은 DeepSeekMoE가 맡고 일반 residual connection은 mHC로 바뀐다. Multi-Token Prediction은 DeepSeek-V3의 depth-1 보조 objective를 유지한다.
Token embedding
    ↓
mHC residual stream 4갈래로 확장
    ↓
┌──────── Transformer block × L ────────┐
│ mHC input mixing                      │
│   → RMSNorm                           │
│   → CSA 또는 HCA + local window       │
│   → Grouped Output Projection         │
│   → mHC residual writeback            │
│                                       │
│ mHC input mixing                      │
│   → RMSNorm                           │
│   → MoE router                        │
│   → shared expert 1 + routed top-6    │
│   → mHC residual writeback            │
└───────────────────────────────────────┘
    ↓
Final RMSNorm → LM head
Attention과 MoE는 역할이 다르다. Attention은 현재 token이 sequence의 어디에서 정보를 읽을지 정하고, MoE router는 그렇게 문맥이 반영된 token vector를 어떤 FFN들이 처리할지 정한다.
DeepSeekMoE
MoE expert 하나는 별도의 Transformer가 아니라 SwiGLU 형태의 작은 FFN이다.
\[\begin{aligned} \mathbf g_i&=\operatorname{SiLU}(W^{(i)}_{\mathrm{gate}}\mathbf u_t), \\ \mathbf v_i&=W^{(i)}_{\mathrm{up}}\mathbf u_t, \\ \operatorname{FFN}_i(\mathbf u_t) &=W^{(i)}_{\mathrm{down}}(\mathbf g_i\odot\mathbf v_i) \end{aligned}\]모든 expert는 같은 $d$차원 token vector를 받아 서로 다른 weight로 변환한다. 선택된 expert가 다른 sequence 구간을 다시 attention하는 구조가 아니다.
\[\operatorname{MoE}(\mathbf u_t) =\operatorname{FFN}^{(s)}(\mathbf u_t) +\sum_{i\in\mathcal T_t}g_{i,t}\operatorname{FFN}^{(r)}_i(\mathbf u_t)\]Flash는 256개, Pro는 384개의 routed expert를 가지며 token마다 6개를 선택한다. Shared expert 하나는 모든 token이 항상 통과한다. 전체 parameter와 active parameter의 큰 차이가 여기서 생긴다.
일반 layer에서는 token vector와 expert centroid의 affinity에 load-balancing bias를 더해 top-6를 고른다. 실제 출력을 섞을 때는 bias를 뺀 affinity를 normalize한다. 첫 세 MoE layer는 learned routing 대신 token ID의 deterministic hash로 expert를 선택한다.
Expert weight가 여러 GPU에 나뉘어 있으므로 routing 뒤에는 dispatch와 combine 통신이 필요하다. V4는 expert를 작은 wave로 나눠 현재 wave의 계산, 다음 wave의 수신, 이전 wave의 송신을 겹친다.
mHC: 네 갈래 residual stream을 안정적으로 섞기
일반 residual connection은 한 stream에 layer output을 더한다. Hyper-Connections는 residual stream을 여러 갈래로 넓혀 block 전후에 섞는다.
\[X_{l+1}=B_lX_l+C_lF_l(A_lX_l)\]- $A_l$: 여러 residual branch를 실제 layer input 하나로 혼합
- $B_l$: residual branch 사이의 정보 혼합
- $C_l$: layer output을 branch에 분배
V4는 residual stream을 네 갈래로 둔다. Attention과 MoE가 받는 hidden dimension 자체는 그대로여서 주 계산량을 크게 늘리지 않고 표현 통로를 넓힌다.
제약 없는 $B_l$을 깊게 곱하면 특정 방향의 signal과 gradient가 커지거나 사라질 수 있다. mHC는 $B_l$의 모든 원소를 음이 아니게 하고, 각 행과 열의 합을 1로 맞춘 doubly stochastic matrix로 제한한다.
\[B_l=\operatorname{Sinkhorn}(\exp(\tilde B_l))\]Sinkhorn-Knopp normalization을 20회 적용한다. 이 조건에서는 $\lVert B_l\rVert_2\leq1$이고 여러 layer의 mixing matrix를 곱한 결과도 같은 집합에 남는다. Residual mixing 자체가 signal을 증폭시키는 문제를 막는다.
수학적인 안정성 제약이 있다는 것과 전체 model의 benchmark 기여는 구분해야 한다. 보고서에는 mHC만 제거한 full-model ablation이 없다.
CSA: 압축하고 필요한 block만 고르기
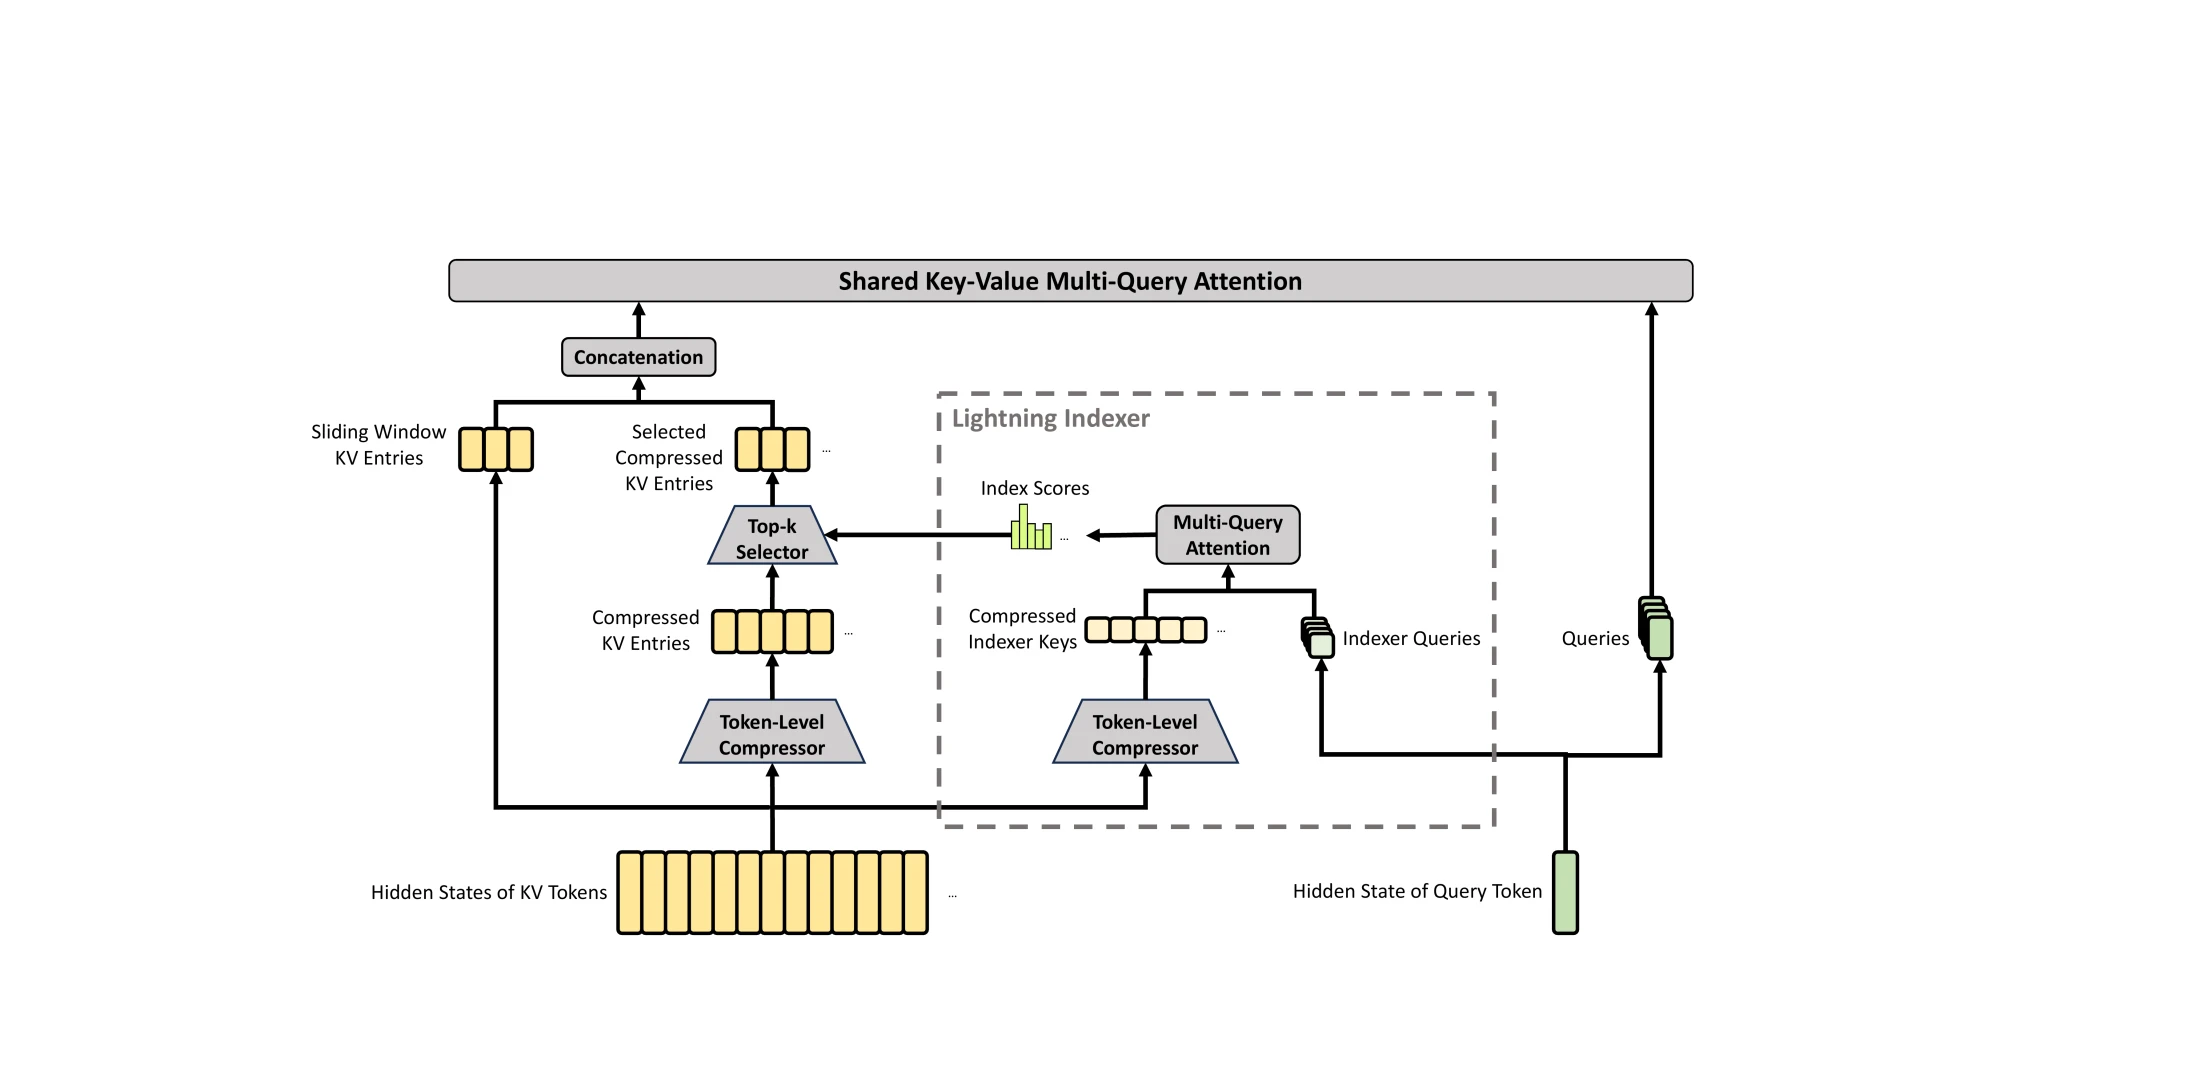
Compressed Sparse Attention은 먼 과거를 다음 순서로 처리한다.
Hidden states
    → 4 token마다 compressed KV 하나 생성
    → 별도 Lightning Indexer가 관련 block에 점수 부여
    → Flash 512개 / Pro 1,024개 block 선택
    → 최근 128 token의 원본 KV와 결합
    → Shared KV multi-query attention
압축은 단순 평균이 아니다. 현재 4-token block과 이전 block의 후보를 함께 놓고 channel별 softmax weight로 섞는다. 한 compressed entry가 8-token 범위를 보지만 entry는 4 token 간격으로 만들어져 전체 KV 길이는 원본의 1/4이 된다.
Lightning Indexer는 본 attention과 별도의 compressor와 query를 사용한다. 검색용 key로 block의 관련도를 계산해 위치만 고르고, 실제 내용은 그 위치의 compressed KV에서 가져온다. Indexer는 내용을 전달하는 경로가 아니라 참조할 주소를 고르는 경로다.
최근 128 token은 압축하지 않은 sliding-window KV로 유지한다. 아직 완성되지 않은 현재 block을 압축하면 미래 token이 섞일 수 있다는 causal 문제를 피하고, 가까운 단어·숫자·순서의 정확한 해상도를 보존한다.
HCA: 더 강하게 압축하고 전체를 보기
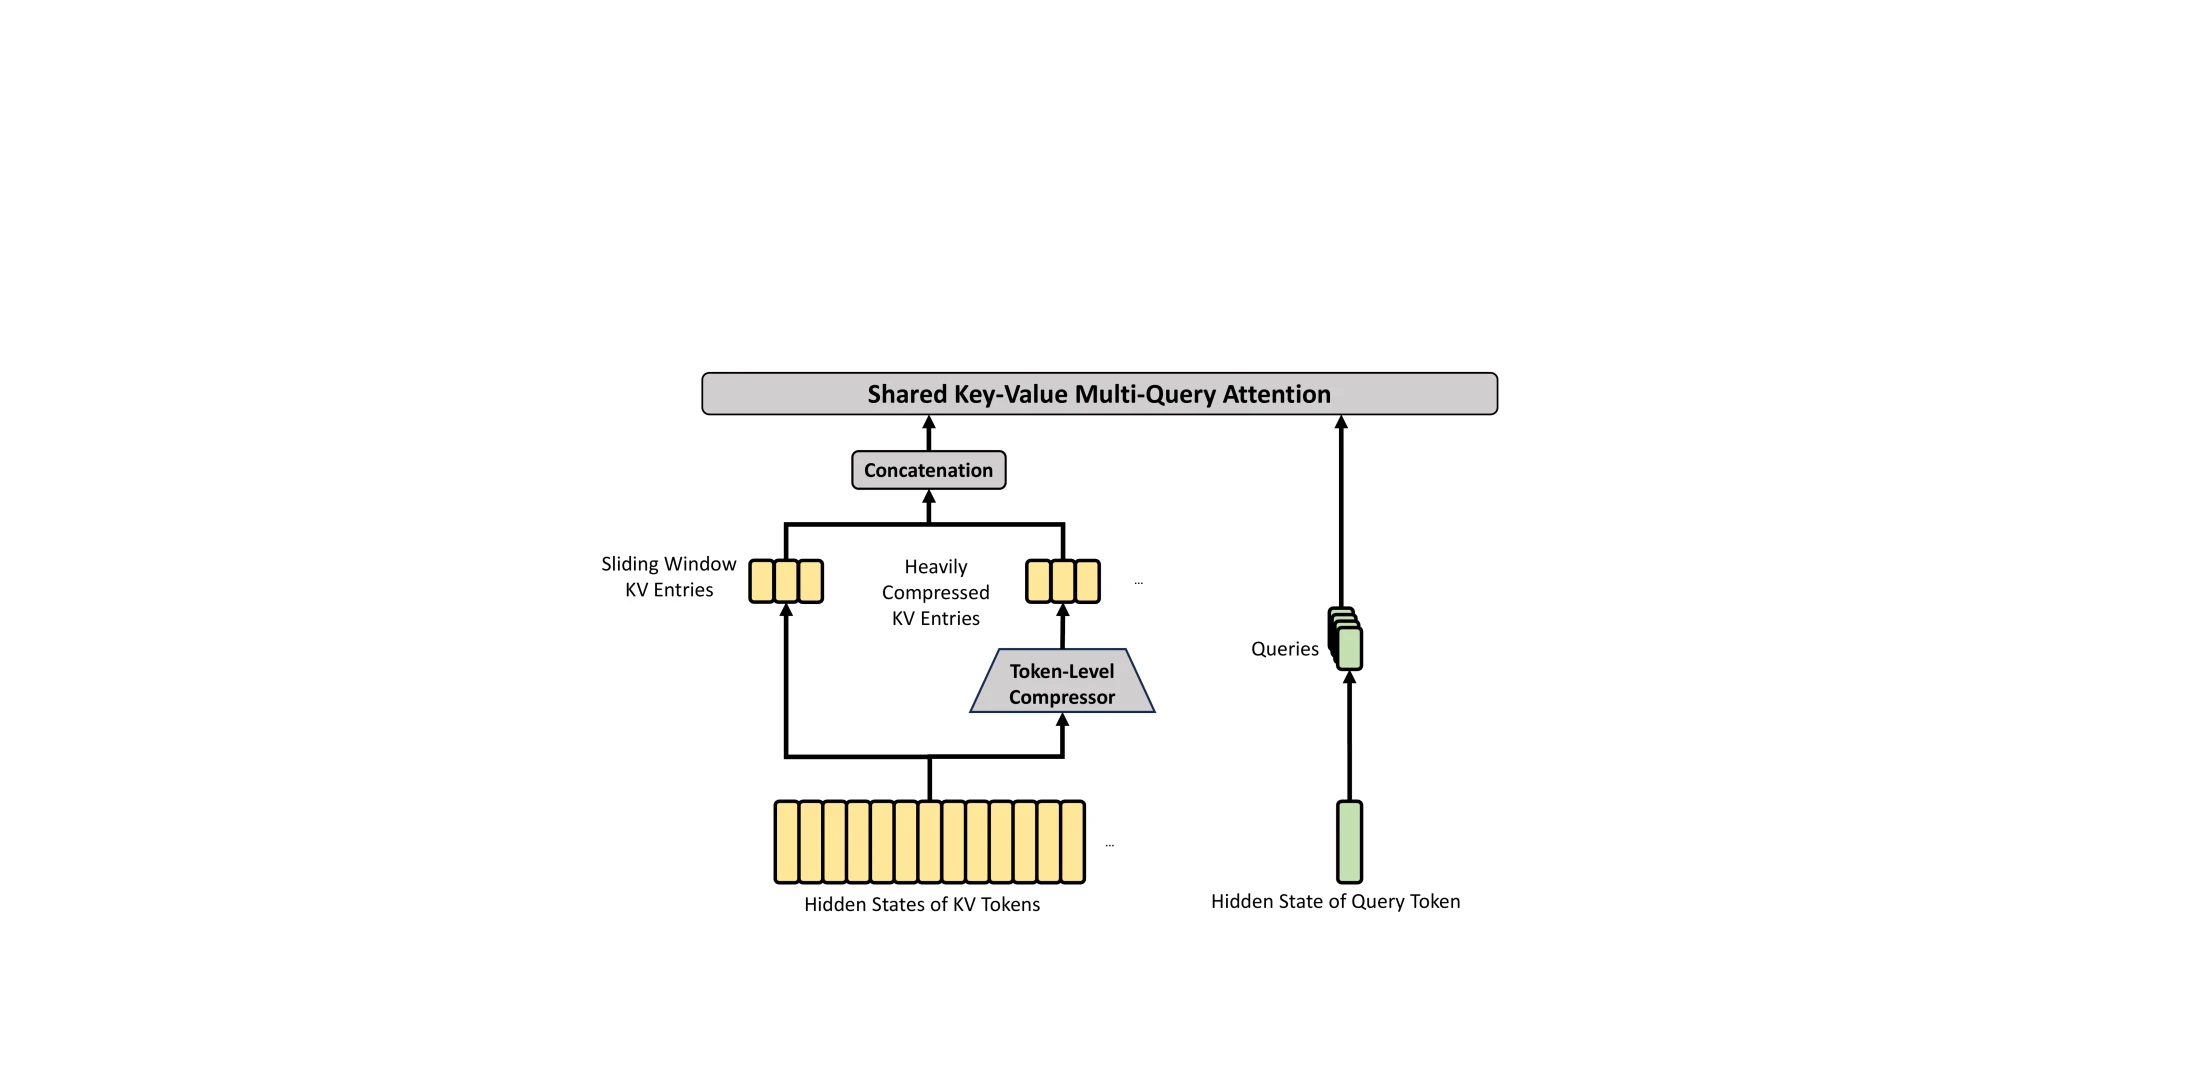
Heavily Compressed Attention은 128 token을 512차원 KV 하나로 줄인다. CSA와 달리 block이 겹치지 않고 Lightning Indexer나 top-k selector도 없다. 이미 history가 1/128로 줄었기 때문에 압축된 과거 전체를 dense attention한다.
token 0–127   → compressed KV 0
token 128–255 → compressed KV 1
token 256–383 → compressed KV 2
HCA의 dense attention은 원본 token 전체를 본다는 뜻이 아니다. 1/128로 줄인 compressed history 전체를 본다는 뜻이다. 검색 실패는 없지만 압축하면서 잃은 세부 정보는 복구할 수 없다. 최근 128 token은 CSA와 동일하게 원본 sliding-window KV로 보완한다.
| 구분 | CSA | HCA |
|---|---|---|
| Sequence 압축 | 4 token마다 1개, 인접 block overlap | 128 token마다 1개, overlap 없음 |
| 원거리 KV 선택 | Lightning Indexer top-k | 모든 compressed KV |
| 최근 정보 | 128-token sliding window | 128-token sliding window |
| 역할 | 비교적 세밀한 과거를 선택적으로 회수 | 거친 전역 history를 빠짐없이 확인 |
CSA와 HCA는 한 layer 안에서 순서대로 실행되지 않는다. 지정된 Transformer layer의 attention 자체를 각각 대체하고, model은 두 종류의 layer를 번갈아 배치한다.
핵심 미해결점은 압축된 KV가 실제로 무엇을 보존하는지다. 보고서는 전체 model 성능을 보여주지만 CSA-only, HCA-only, 압축률별 quality-efficiency ablation은 제공하지 않는다.
Muon optimizer
V4는 attention·MLP·MoE 등 대부분의 2D weight에 Muon을 사용하고, embedding·prediction head·RMSNorm·mHC gate에는 AdamW를 사용한다.
Muon은 SGD momentum update를 Newton–Schulz iteration으로 근사 직교화한다. 몇 개의 singular direction에 update가 몰리는 현상을 줄이고 방향별 크기를 평탄화한다. V4는 빠른 coefficient를 8회, 안정적인 coefficient를 2회 적용하는 Hybrid Newton–Schulz와 weight decay, shape별 RMS 보정을 결합한다.
자세한 수식과 대규모 LLM 확장은 Muon optimizer 리뷰에 분리했다. V4 보고서에는 같은 architecture를 AdamW로 학습한 직접 ablation이 없어, 전체 성능 중 Muon의 기여만 따로 계산할 수는 없다.
Architecture를 실제 system으로 만들기
Expert Parallelism
MoE의 dispatch, expert matrix multiplication과 combine을 작은 wave로 쪼개 통신과 계산을 하나의 mega-kernel에서 겹친다. 보고서는 non-fused baseline 대비 일반 inference에서 1.50–1.73배, latency-sensitive serving에서 최대 1.96배 속도를 보고한다. 이 수치는 해당 kernel과 hardware 구성의 결과다.
TileLang과 결정론적 kernel
복잡한 attention과 MoE를 수백 개의 작은 PyTorch operator로 실행하지 않고 TileLang으로 fused kernel을 만든다. Z3로 tensor index와 boundary를 분석하고 host-side overhead를 줄인다.
같은 token은 batch 위치나 함께 묶인 request가 달라도 bitwise 동일한 결과를 내도록 reduction 순서를 고정한다. RL rollout과 training의 log-prob가 어긋나는 문제, loss spike를 재현하기 어려운 문제를 줄이기 위한 설계다.
State cache와 KV cache
일반 PagedAttention은 모든 layer의 cache block이 같은 크기와 갱신 규칙을 가진다고 가정한다. V4에서는 CSA, HCA와 sliding-window KV가 서로 다르다.
- 최근 window와 아직 압축되지 않은 tail token은 고정 크기 state cache에 둔다.
- 압축이 끝난 CSA/HCA entry는 일반 KV cache에 둔다.
- 공유 prefix는 disk에 저장해 다시 prefill하지 않는다.
- 큰 sliding-window KV는 전부 저장하거나, 간격별 checkpoint만 남기거나, 필요할 때 재계산할 수 있다.
Architecture에서 얻은 cache 절감을 실제 serving storage까지 이어간 부분이다.
1M context를 학습한 방법
두 model은 짧은 context로 시작해 training sequence를 단계적으로 늘렸다.
4K → 16K → 64K → 1M
짧은 context model에 inference-time extrapolation만 붙인 것이 아니다. Flash는 32T, Pro는 33T token을 pre-train했고 64K 단계에서 Lightning Indexer를 먼저 학습한 뒤 sparse attention을 도입했다.
Trillion-parameter MoE의 loss spike에는 두 가지 engineering fix를 사용했다.
- Anticipatory Routing: 문제가 생겼을 때 일정 step 전 parameter로 expert route를 미리 계산한다.
- SwiGLU Clamping: Linear branch와 gate의 outlier를 제한한다.
효과는 있었지만 원리가 충분히 설명된 것은 아니다. Data도 web·수학·code·long document·다국어를 포함해 32T token 이상이라고만 공개됐고, mixture 비율과 decontamination 절차는 구체적이지 않다.
Specialist를 하나의 model로 합치기
Post-training은 domain specialist를 먼저 만든 뒤 하나의 model로 통합한다.
Base model
  → domain별 SFT
  → domain별 GRPO RL
  → 수학·코딩·agent·instruction specialist
  → multi-teacher On-Policy Distillation
  → DeepSeek-V4
Non-think, Think High, Think Max는 단순히 같은 model의 token budget만 다르게 준 조건이 아니다. RL의 length penalty와 evaluation context도 함께 다르다.
On-Policy Distillation에서는 최종 student가 자기 trajectory를 생성하고, 그 위치에서 관련 specialist teacher의 full-vocabulary 분포를 따라간다.
\[\mathcal{L}_{\mathrm{OPD}}(\theta) =\sum_iw_iD_{\mathrm{KL}}(\pi_\theta\,\|\,\pi_{E_i})\]10개가 넘는 teacher의 weight를 직접 merge하지 않고, student가 실제로 방문하는 trajectory에서 domain별 분포를 통합한다.
Tool call 대화에서는 user message와 tool round를 넘어 이전 reasoning trace를 유지한다. 검색어 생성, URL fetch 여부, 대화 제목 같은 보조 예측은 별도 small model 대신 기존 KV cache 뒤에 special token을 붙여 병렬 실행한다.
RL system에는 다음 장치가 들어간다.
- FP4 QAT: MoE expert와 CSA indexer 일부를 MXFP4로 학습한다.
- Token-level WAL: rollout token을 매 step 기록해 preemption 뒤 중간부터 이어간다.
- Million-token RL: 무거운 per-token data를 shared memory에서 mini-batch 단위로 관리한다.
- DSec sandbox: function call, container, microVM과 full VM을 하나의 API로 묶고 trajectory를 복구한다.
Benchmark 결과 읽기
DeepSeek-V4-Pro-Max의 대표 수치는 다음과 같다.
| 영역 | Benchmark | V4-Pro-Max | 비교 범위 |
|---|---|---|---|
| 지식 | SimpleQA-Verified | 57.9 | Open model 중 높지만 Gemini 75.6보다 낮음 |
| 추론 | GPQA Diamond | 90.1 | 비교한 주요 closed model보다 낮음 |
| 코딩 | LiveCodeBench | 93.5 | 보고서 표에서 가장 높음 |
| Long context | MRCR 1M | 83.5 | Opus 92.9보다 낮고 Gemini 76.3보다 높음 |
| Agent | Terminal Bench 2.0 | 67.9 | GPT-5.4 75.1보다 낮음 |
| Agent | SWE Verified | 80.6 | Opus 80.8에 근접 |
| Search | BrowseComp | 83.4 | Gemini 85.9, Opus 83.7에 근접 |
Open model의 knowledge와 reasoning 상한을 올렸고, 큰 test-time compute를 쓴 code·math에서는 closed model과 경쟁한다. Agent benchmark도 강하지만 closed model 우위가 남는 항목이 많다. 각 model의 tool, context와 reasoning budget이 다르므로 한 표를 동일 비용 비교로 읽으면 안 된다.
MRCR 8-needle의 의미
MRCR은 긴 multi-turn 대화에서 마지막 지시가 가리키는 과거 응답을 찾아 그대로 재현하는 long-context retrieval benchmark다.
"맥에 관한 글을 써줘" → 응답 A
여러 distractor 대화
"맥에 관한 글을 써줘" → 응답 B
같은 요청과 서로 다른 응답 C, D, ...
마지막 질문: "맥에 관한 네 번째 글을 반환해"
8-needle은 8개를 모두 반환한다는 뜻이 아니다. 같은 요청에 대응하는 8개 후보 중 마지막 지시가 가리키는 순번 하나를 찾아야 한다. Keyword만으로는 같은 요청의 여러 응답을 구분할 수 없어, 요청의 등장 횟수와 co-reference를 함께 추적해야 한다.
Scoring도 binary exact match가 아니다.
- 정답에 지정된 hash prefix가 없으면 0점이다.
- Hash가 맞으면 이를 제거한다.
- Model output과 ground truth를 Python
SequenceMatcherratio로 비교한다.
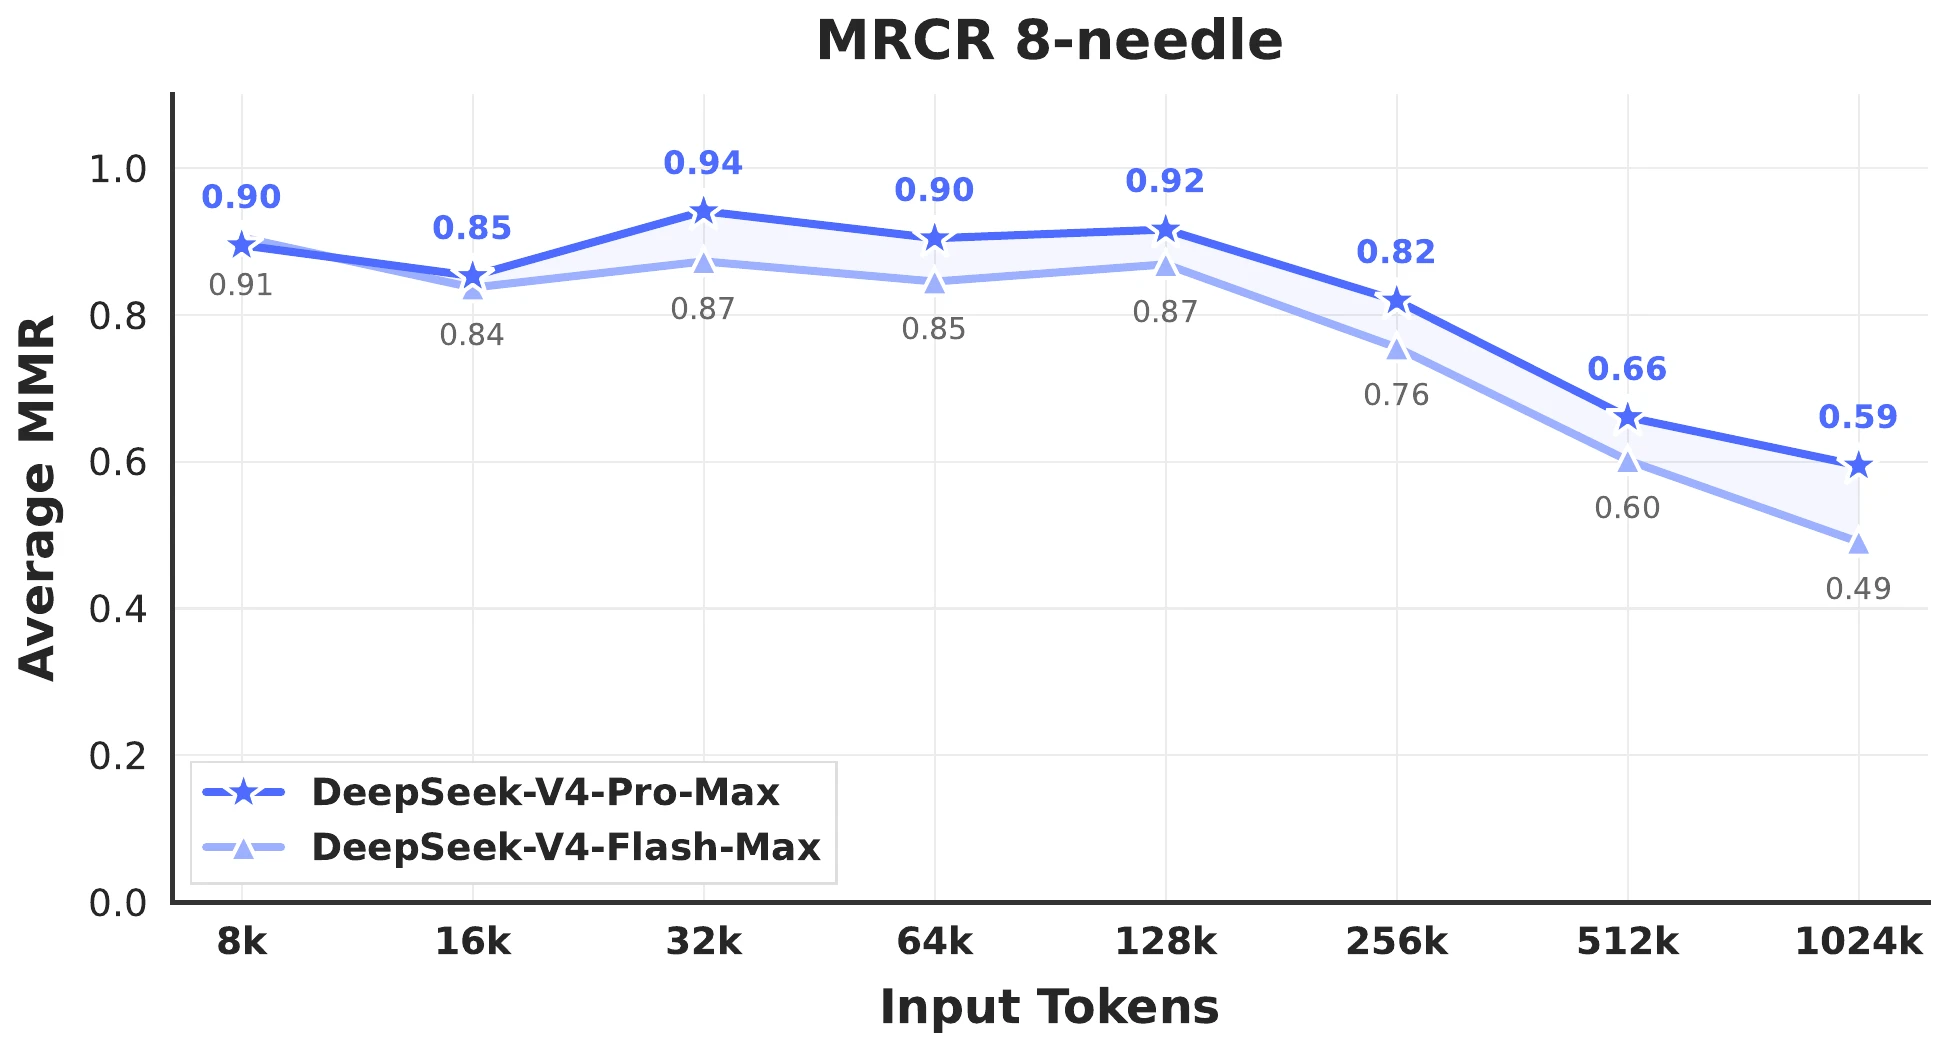
Figure 9의 8-needle 결과는 128K 이후 크게 낮아진다.
- Pro-Max: 128K 0.92 → 256K 0.82 → 512K 0.66 → 1M 0.59
- Flash-Max: 128K 0.87 → 256K 0.76 → 512K 0.60 → 1M 0.49
Pro-Max의 1M 0.59는 정답률 59%가 아니라 평균 문자열 match ratio다. 본문의 headline MRCR 1M = 83.5와도 산출 범위가 다르다. Figure 9는 8-needle을 context-length bin별로 나눈 point이고, 보고서는 headline metric의 needle·length aggregation을 충분히 설명하지 않는다. 두 숫자를 직접 환산하면 안 된다.
MRCR은 긴 입력에서 특정 내용을 찾아 순서까지 구분해 재현하는 능력을 측정한다. 1M token 전체의 의미를 종합해 깊게 추론하는 능력을 직접 검증하는 benchmark는 아니다.
Interleaved thinking과 실제 task
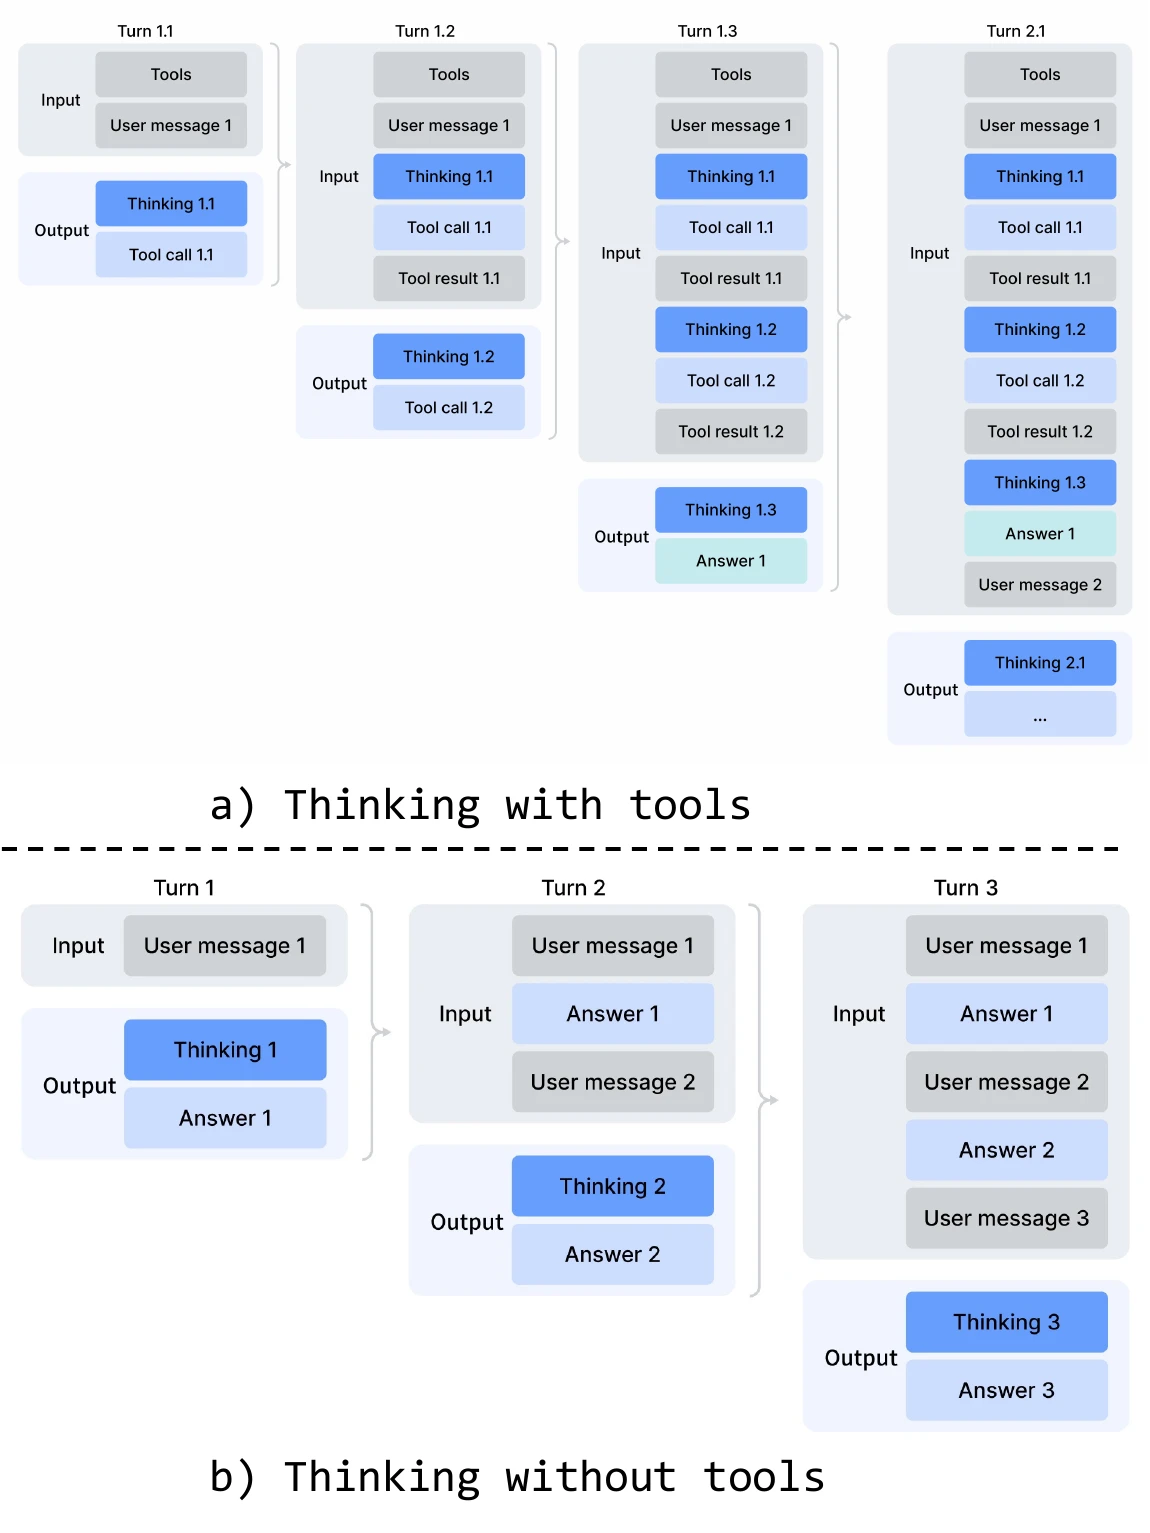
Tool-calling 대화에서는 tool 결과를 본 뒤에도 이전 reasoning trace를 유지한다. 일반 대화에서는 새 user message가 오면 과거 reasoning을 버린다. Tool result를 실제 tool message가 아닌 user message로 흉내 내는 framework는 이 경로를 사용하지 못할 수 있다.
보고서는 중국어 writing, agentic search, white-collar task와 code agent의 내부 평가도 제시한다. 실제 사용에 가까운 신호라는 장점이 있지만 대부분 비공개 dataset·harness와 human evaluation이다. 예시 몇 개와 aggregate win rate가 공개 benchmark를 대체하지는 않는다.
남은 한계
- 1M은 균일한 품질이 아니다. MRCR 8-needle은 128K 이후 계속 하락한다.
- 효율 수치의 범위가 좁다. Single-token FLOPs와 KV cache 추정치이며 end-to-end serving 비용은 아니다.
- Component ablation이 부족하다. CSA, HCA, mHC와 Muon의 개별 기여를 분리하기 어렵다.
- 학습 비용이 없다. GPU 수, 총 training FLOPs, wall-clock, 전력과 비용을 공개하지 않는다.
- Data 공개가 제한적이다. 총 token과 큰 category만 있고 mixture와 contamination 통제가 구체적이지 않다.
- 평가 조건이 섞인다. 비공개 harness, model별 다른 reasoning effort와 tool 조건이 포함된다.
- 안전성 평가가 없다. Misuse, alignment, 보안과 긴 agent trajectory의 위험을 다루지 않는다.
- Preview 보고서다. 공식 collection의 후속 checkpoint 변화는 별도 검증이 필요하다.
DeepSeek-V4는 “더 큰 MoE”보다 압축된 전역 기억과 선택적 세부 회수를 system 전체에서 구현한 long-context model로 이해하는 편이 정확하다. 1M이라는 최대 길이보다 CSA와 HCA가 무엇을 버리고 무엇을 남기는지, 그 손실을 local window와 layer interleaving이 어떻게 보완하는지가 이 보고서의 중심이다.
참고 자료
공유하기
X LinkedIn'Paper Review' 카테고리의 다른 글
댓글남기기