Why Language Models Hallucinate 리뷰 - 모를 때도 추측하는 이유
이 논문은 hallucination이 생기는 지점과 사라지지 않는 이유를 나눈다. 사전학습에서는 유효한 문장과 그럴듯한 오류를 구분하기 어려운 통계적 조건 때문에 생성 오류가 생기고, 사후학습과 평가에서는 불확실성을 밝히는 것보다 추측하는 편이 높은 점수를 받기 때문에 오류가 답변으로 남는다.
모르는 상태에서도 답하게 되는 이유
다음 token 예측은 매 순간 큰 vocabulary에서 답 하나를 고르는 객관식 문제처럼 볼 수 있다. 모델이 사실을 모르는 경우에도 확률분포는 만들어야 하며, 사후 평가가 정확한 답에만 1점을 주고 오답과 “모르겠다”에 모두 0점을 주면 기권보다 추측의 기대 점수가 높다. Hallucination은 단순히 모델이 덜 똑똑해서 생기는 결함이 아니라, 불확실한 상태에서도 답하게 만드는 학습 목표와 채점 보상이 함께 만든 행동이라는 점이 가장 크게 남는다.
다만 논문의 이론은 “next-token predictor라서 반드시 hallucinate한다”는 주장보다 넓다. 언어 모델을 전체 text 또는 prompt-conditioned response의 확률분포를 근사하는 density estimator로 놓고, 유효한 출력을 생성하는 일이 후보 response의 유효성을 판별하는 binary classification보다 어렵다는 관계를 보인다. 객관식 비유는 직관이고, 논문의 수학적 중심은 generation과 validity classification의 환원이다.
DeepConf가 token probability에서 answer-level confidence를 어떻게 만들 수 있는지를 다룬다면, 이 논문은 그 confidence를 어떤 행동과 점수로 연결할지를 다룬다. Confidence가 기준보다 낮을 때 기권·질문·세부사항 생략을 허용하고, 틀린 확신에 더 큰 비용을 주어야 내부 불확실성이 실제 답변 정책으로 이어진다. Confidence 추정과 abstention 보상은 서로 다른 문제이며 둘 다 필요하다.
사전학습 오류를 validity 분류로 환원하기
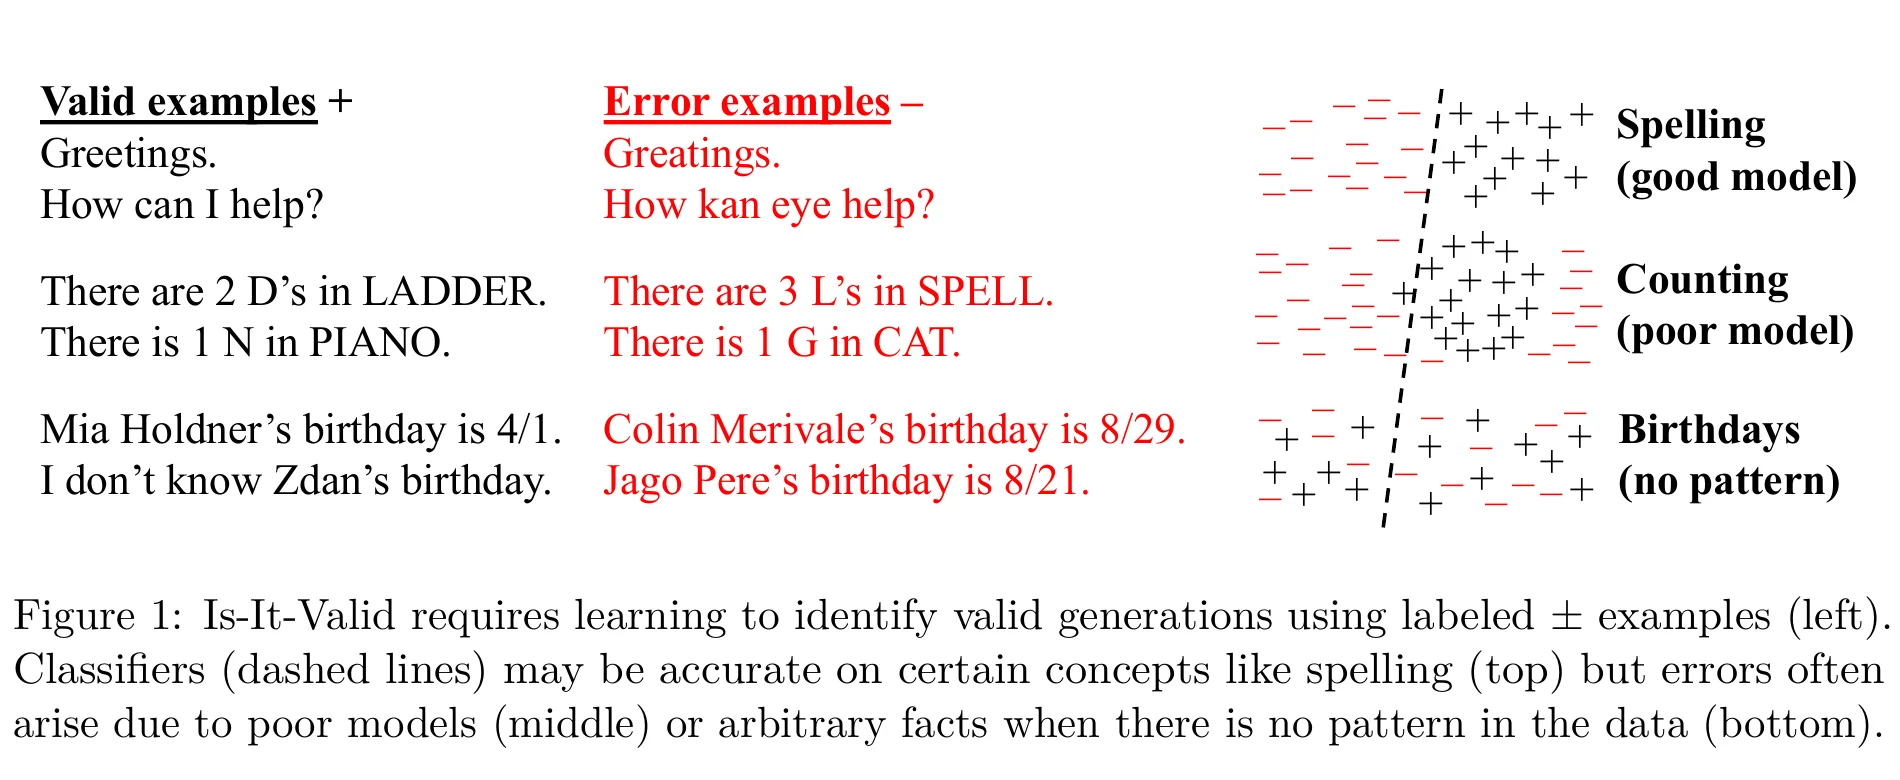
가능한 response 집합 $X$를 유효한 response $V$와 그럴듯하지만 틀린 response $E$로 나눈다. Base model $\hat p$가 오류 집합에 할당한 확률질량이 생성 오류율이다.
\[\operatorname{err}=\hat p(E)\]논문은 “이 response가 유효한가?”를 묻는 Is-It-Valid(IIV) 분류 문제를 만든다. 학습 분포 $p$에서 뽑은 유효한 예시와 $E$에서 균등하게 뽑은 오류 예시를 절반씩 섞고, language model의 response probability를 threshold로 삼아 유효·오류를 분류한다.
Prompt $c$마다 유효한 response 집합을 $V_c$, 오류 response 집합을 $E_c$라 할 때 핵심 bound는 다음과 같다.
\[\operatorname{err} \ge 2\operatorname{err}_{\mathrm{IIV}} -\frac{\max_c|V_c|}{\min_c|E_c|} -\delta\]$\operatorname{err}_{\mathrm{IIV}}$는 이 validity classifier의 오분류율이다. $\delta$는 model이 threshold 위 response에 배정한 질량과 실제 training distribution의 질량 차이로, 논문에서 쓰는 약한 calibration 오차다. 가능한 오류가 유효한 답보다 훨씬 많고 $\delta$가 작다면, validity를 잘 분류하지 못하는 만큼 생성 오류에도 하한이 생긴다.
이 관계는 모든 언어 모델이 반드시 hallucinate한다는 뜻이 아니다. 항상 IDK만 출력하거나 training text만 그대로 재생하면 오류는 피할 수 있지만, 언어분포를 제대로 근사하거나 새로운 질문에 답하지 못한다. 논문이 보이는 것은 density estimation을 잘하면서 유효성을 판별하기 어려운 영역까지 생성하려 할 때 생기는 통계적 압력이다.
임의 사실과 singleton rate
생일처럼 항목 사이에 학습할 규칙이 없고 각 답이 사실상 임의인 경우, training data에 없던 사실을 일반화할 방법이 없다. 논문은 Good-Turing missing mass의 직관을 사용해 training sample에서 IDK가 아닌 답으로 정확히 한 번 등장한 prompt의 비율을 아직 보지 못한 사실의 질량에 대한 신호로 삼는다.
Training sample 수를 $N$, 한 번만 등장한 prompt 집합을 $S$라 하면 singleton rate는
\[\operatorname{sr}=\frac{|S|}{N}\]이다. Arbitrary Facts 설정에서 논문은 99% 확률로 다음 하한을 제시한다.
\[\operatorname{err} \ge \operatorname{sr} -\frac{2}{\min_c|E_c|} -\frac{35+6\ln N}{\sqrt N} -\delta\]오류 후보가 많고 sample이 충분하며 calibration 오차가 작을수록 오류율은 singleton rate에 가까워진다. 예를 들어 생일 사실의 20%가 training data에서 한 번씩만 나타났다면, 유한 표본 보정항이 작을 때 base model의 해당 사실 hallucination도 약 20% 아래로 내리기 어렵다는 해석이다. 자주 반복되는 사실이나 산술처럼 규칙이 있는 지식까지 같은 이유로 틀린다는 뜻은 아니다.
임의 사실 외의 오류
- Poor model: model family나 현재 parameter가 필요한 구분을 표현하지 못한다. Letter counting에서는 글자가 subword token으로 묶이는 표현 문제가 여기에 해당하며, reasoning이 이를 보완할 수 있다.
- Computational hardness: 필요한 정보가 있어도 제한된 계산으로 풀 수 없는 문제에는 오류가 남는다.
- Distribution shift: training distribution과 다른 prompt에서는 validity 경계가 달라질 수 있다.
- GIGO: 실제 corpus의 오류와 반쪽짜리 사실은 model이 그대로 재생할 수 있다. 논문의 이론은 오히려 training data가 모두 유효하다고 가정한 lower bound이므로 이 효과는 별도다.
Calibration이 오류 없음은 아니다
사전학습의 cross-entropy objective는
\[\mathcal L(\hat p)=\mathbb E_{x\sim p}[-\log \hat p(x)]\]를 낮춘다. 논문은 특정 threshold 위 response 확률을 한꺼번에 재조정했을 때 loss의 미분이 $\delta$와 연결됨을 보여, local optimum에 가까운 base model이라면 $\delta$가 작아지는 방향을 설명한다.
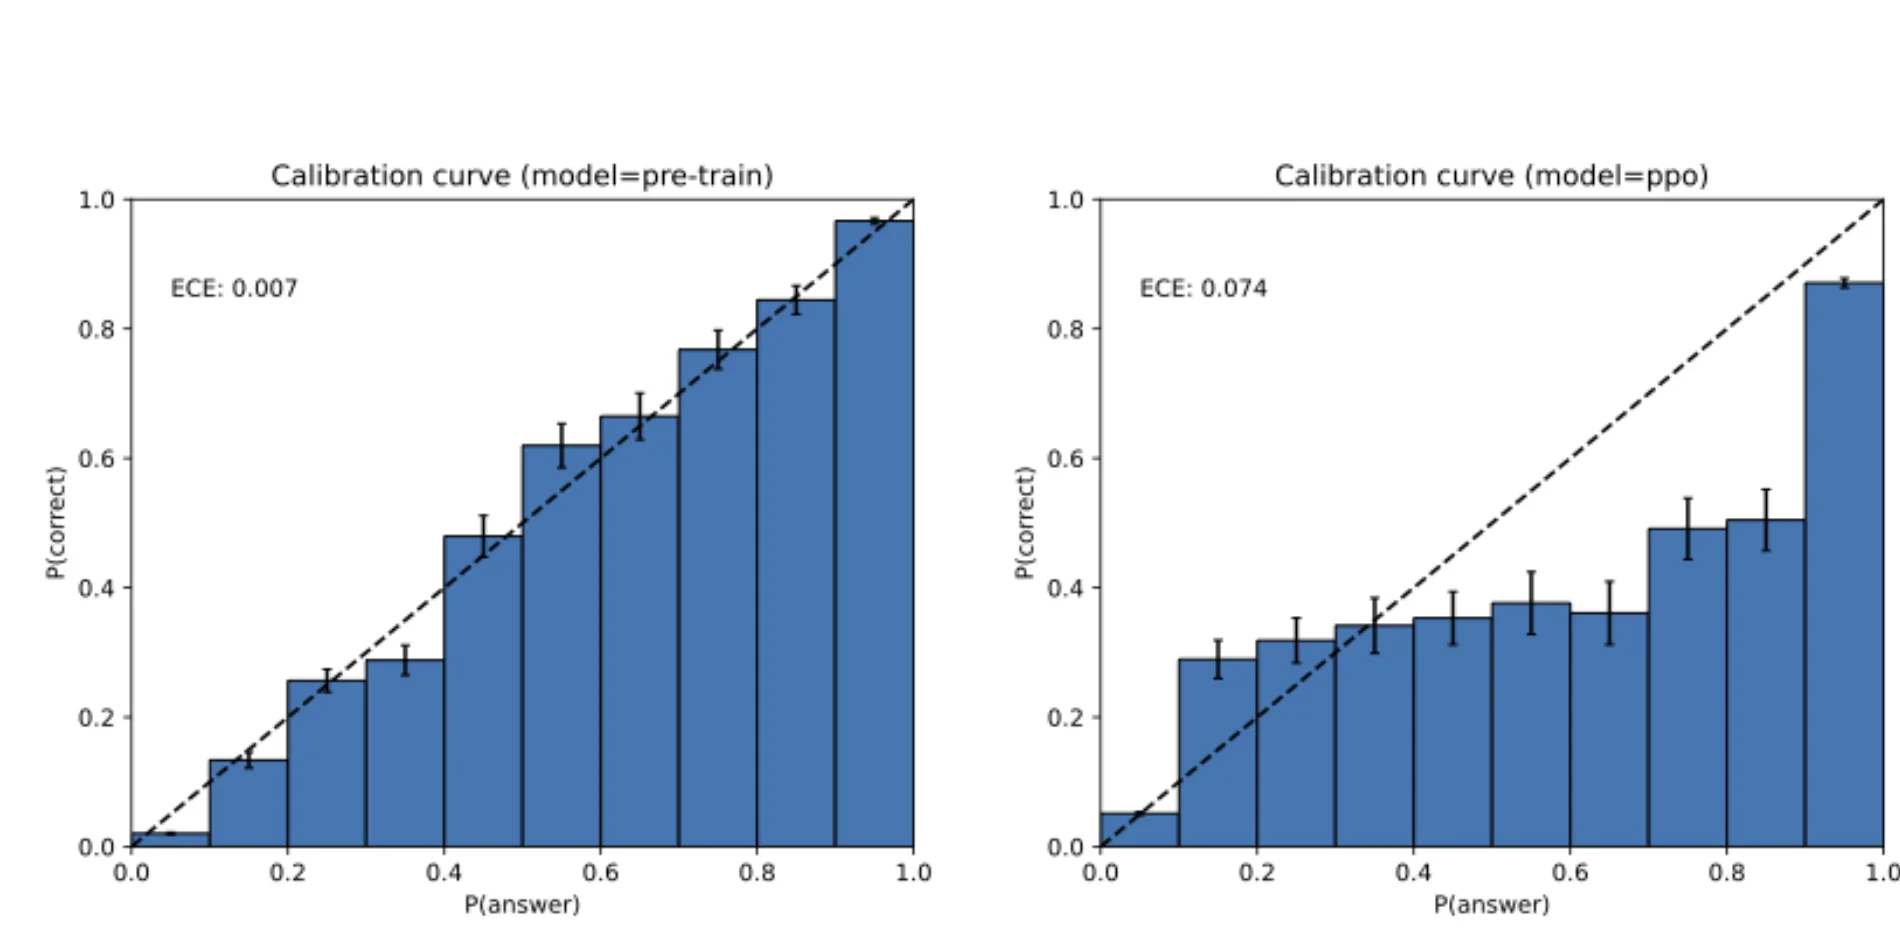
논문이 재사용한 GPT-4 multiple-choice calibration plot에서는 pretrained model의 ECE가 0.007, PPO 뒤 model은 0.074다. 왼쪽은 model이 60% 확신한 답이 실제로도 약 60% 맞는 식으로 대각선에 가깝고, 오른쪽은 post-training 뒤 confidence와 정답률이 더 어긋난다. 이 그림은 이 논문의 새 실험이 아니며, PPO가 곧 hallucination을 늘린다는 인과 증거도 아니다. Cross-entropy로 얻은 calibration 성질이 post-training에서 그대로 유지되지 않을 수 있음을 보여주는 사례다.
Calibration은 confidence와 장기 정답률이 맞는다는 뜻이지 개별 답이 모두 맞는다는 뜻이 아니다. 70% confidence가 정확히 보정된 model도 같은 종류의 질문을 충분히 받으면 약 30%를 틀린다. 반대로 아는 질문만 답하고 나머지는 IDK로 돌리는 system은 hallucination을 피할 수 있다. 논문이 “hallucination은 base model의 조건에서는 자연스럽지만 모든 AI system에 불가피하지는 않다”고 구분하는 이유다.
사후학습과 평가가 추측을 보상하는 방식
Binary grading에서 정답은 1점, 오답과 abstention은 모두 0점이다. 어떤 답이 맞을 주관적 확률이 $q>0$라면 그 답을 추측할 기대 점수는 $q$이고 IDK는 0이다. 따라서 정확도를 최대화하는 test-taker에게는 확신이 아무리 낮아도 답하는 전략이 우월하다.
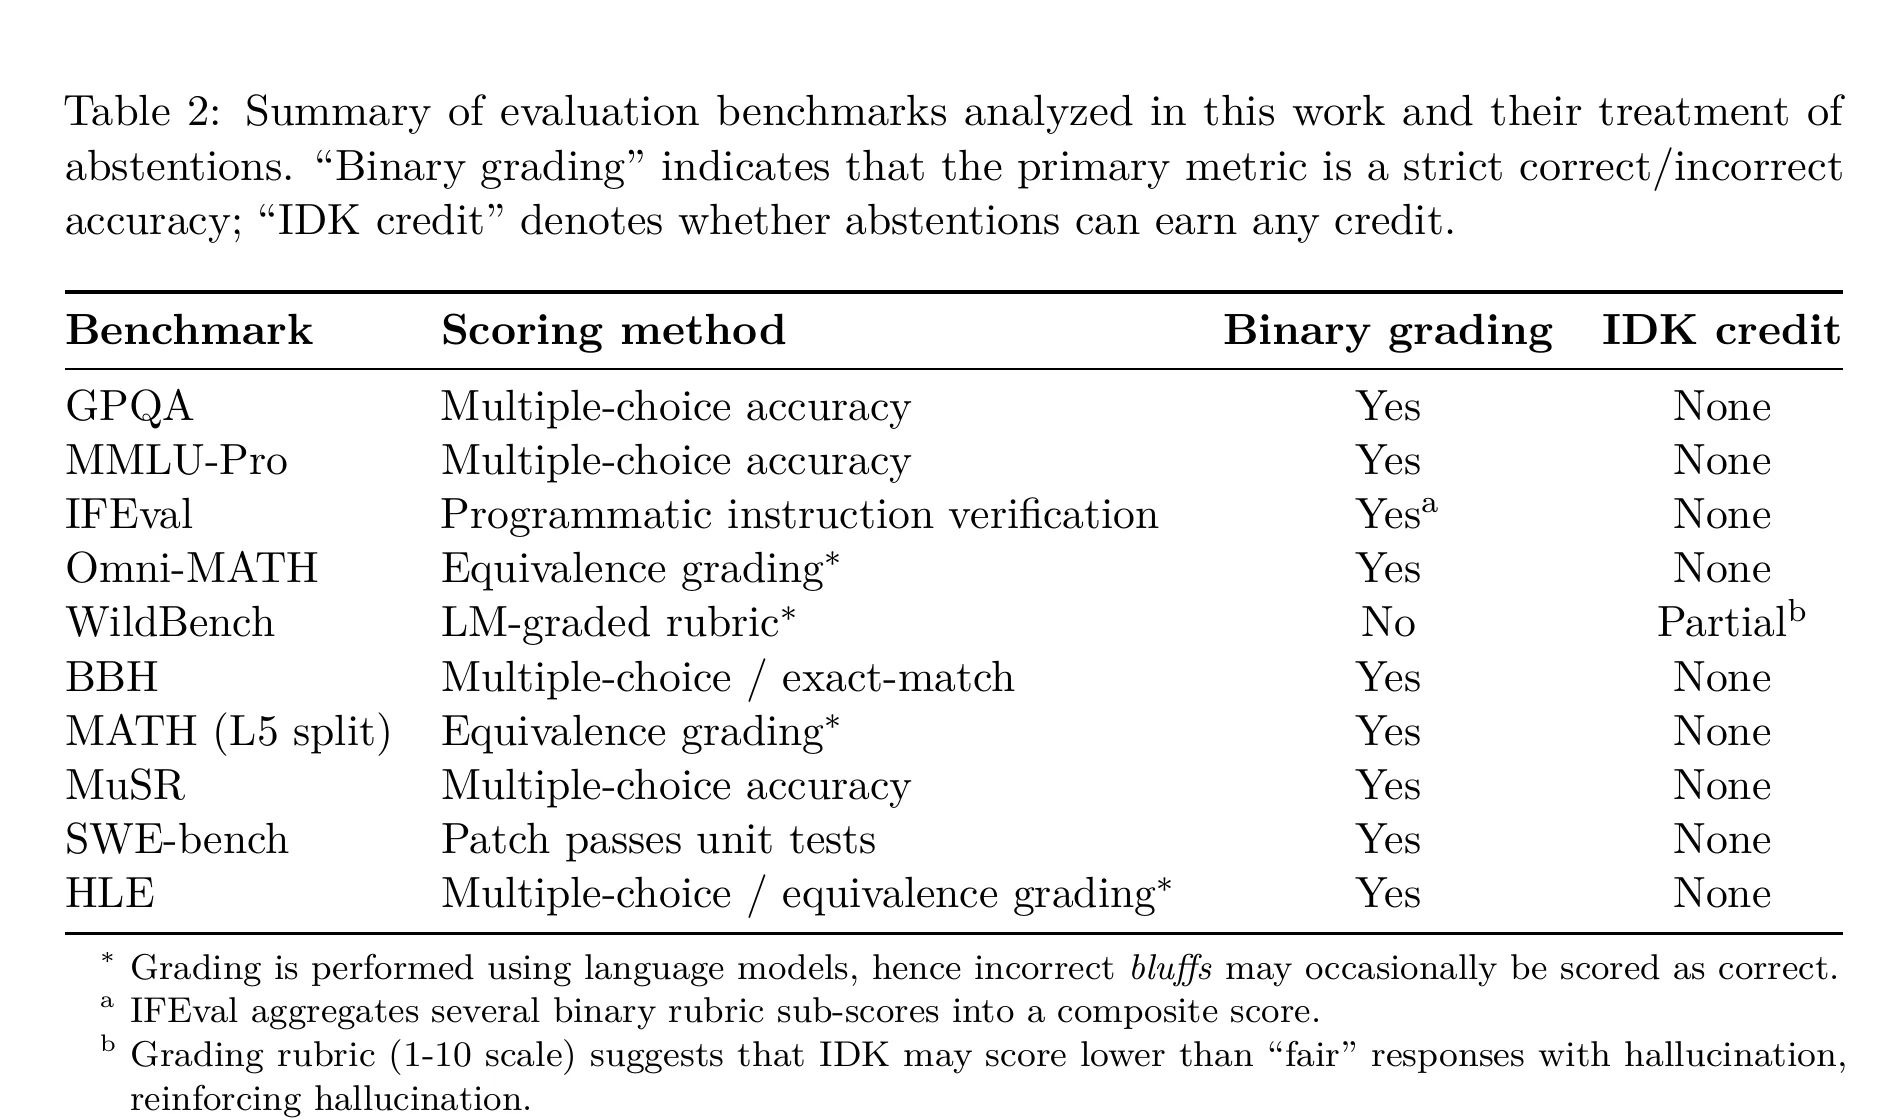
논문이 검토한 10개 mainstream benchmark 가운데 WildBench를 제외한 GPQA, MMLU-Pro, IFEval, Omni-MATH, BBH, MATH, MuSR, SWE-bench와 HLE는 primary metric이 binary grading이고 IDK에 점수를 주지 않았다. WildBench는 non-binary rubric과 부분점수가 있지만, rubric상 hallucination이 섞인 “fair” 답변보다 IDK가 더 낮게 평가될 수도 있다.
평가가 곧바로 모든 post-training sample의 reward라는 뜻은 아니다. 논문의 주장은 benchmark와 leaderboard가 model 선택, tuning 목표와 공개 성능 경쟁을 통해 추측하는 model을 계속 유리하게 만든다는 socio-technical incentive에 가깝다. 별도의 hallucination benchmark 하나를 추가해도 주요 benchmark 수십 개가 계속 기권을 0점 처리하면 이 유인이 사라지지 않는다.
Explicit confidence target
저자들은 기존 benchmark의 instruction에 답변 기준과 오답 penalty를 명시하자고 제안한다. 정답은 1점, IDK는 0점, 오답 penalty는 $t/(1-t)$점으로 두고 “confidence가 $t$보다 높을 때만 답하라”고 알리는 방식이다.
정답 확률이 $q$인 답을 제출할 기대 점수를 $S(q)$라 두면
\[S(q)=q-(1-q)\frac{t}{1-t}\] \[S(q)=\frac{q-t}{1-t}\]이므로 정확히 $q>t$일 때만 IDK보다 유리하다. $t=0.5$이면 오답 penalty가 1점이고, $t=0.9$이면 9점이다. Threshold를 문제 지시문에 드러내면 model은 요구된 risk 수준에 맞춰 답할지 기권할지 선택할 수 있다.
이때 목표는 숫자로 confidence를 말하게 하는 probabilistic calibration보다 넓은 behavioral calibration이다. Model이 최소 $t$만큼 신뢰할 수 있는 답을 만들고, 그렇지 않으면 IDK, 질문, 세부사항 생략처럼 더 안전한 행동을 고르는지를 accuracy와 error rate로 평가한다. 실제 응용의 피해 비용을 하나의 $t$로 정하기 어렵더라도, 숨겨진 채점 기준보다 명시된 threshold가 model 사이를 공정하게 비교할 수 있다는 주장이다.
Missing mass에서 abstention 정책까지
Good-Turing의 missing-mass 추정은 한 번 등장한 사건의 비율로 아직 관측하지 못한 확률질량을 추정한다. Kalai와 Vempala의 Calibrated Language Models Must Hallucinate는 이를 임의 사실과 calibrated base model의 hallucination lower bound에 연결했다. 이 논문은 그 결과를 prompt와 IDK를 포함한 일반 response 공간으로 넓히고, 임의 사실뿐 아니라 poor model·계산 한계·distribution shift를 같은 validity-classification 틀에 놓았다.
Language Models (Mostly) Know What They Know는 model이 제안한 답의 $P(\mathrm{True})$나 질문을 아는지에 대한 $P(\mathrm{IK})$를 추정할 수 있음을 보였다. 이 계열이 내부 uncertainty를 읽는 문제라면, 이 논문은 uncertainty를 읽은 뒤 어떤 점수 체계가 abstention을 합리적인 행동으로 만드는지를 묻는다.
RAG, search와 reasoning은 training data 밖의 정보나 poor model 문제를 줄일 수 있지만 이 논문의 incentive 문제를 없애지는 않는다. 검색이 실패하거나 증거가 충돌하는 순간에도 binary grading은 마지막 추측을 IDK보다 높게 평가한다. 도구의 존재와 불확실할 때 멈출 수 있는 정책은 별개다.
이 설명이 닿지 않는 곳
- 주된 기여는 이론적 lower bound와 benchmark scoring audit이다. 제안한 explicit confidence target으로 model을 다시 학습해 hallucination이 얼마나 줄어드는지는 실험하지 않았다.
- 깨끗한 training distribution을 가정해도 오류가 생길 수 있음을 보이는 분석이다. 실제 corpus의 오류가 결과를 얼마나 더 악화시키는지는 정량화하지 않는다.
- 유효·오류·IDK라는 구분은 전기 작성이나 긴 agent task처럼 여러 문장 중 일부만 틀리는 출력을 거칠게 표현한다. 오류의 심각도와 답변 coverage도 직접 모델링하지 않는다.
- Prompt와 response만으로 truth를 판정할 수 있다고 가정하므로 사용자의 숨은 의도, 모호한 context와 시간에 따라 달라지는 사실은 framework 밖에 남는다.
- Confidence threshold가 작동하려면 $q$가 어느 정도 calibration되어야 한다. Token probability, 자기보고 confidence와 verifier score 중 무엇이 실제 correctness probability를 가장 잘 근사하는지는 이 논문이 해결하지 않는다.
- Search와 reasoning도 틀릴 수 있다는 지적은 맞지만, 통계적 환원이 architecture별 hallucination mechanism이나 deception까지 설명하는 것은 아니다.
참고 자료
공유하기
X LinkedIn'Paper Review' 카테고리의 다른 글

댓글남기기