DeepConf 논문 리뷰 - Token Confidence로 Reasoning Trace 고르기
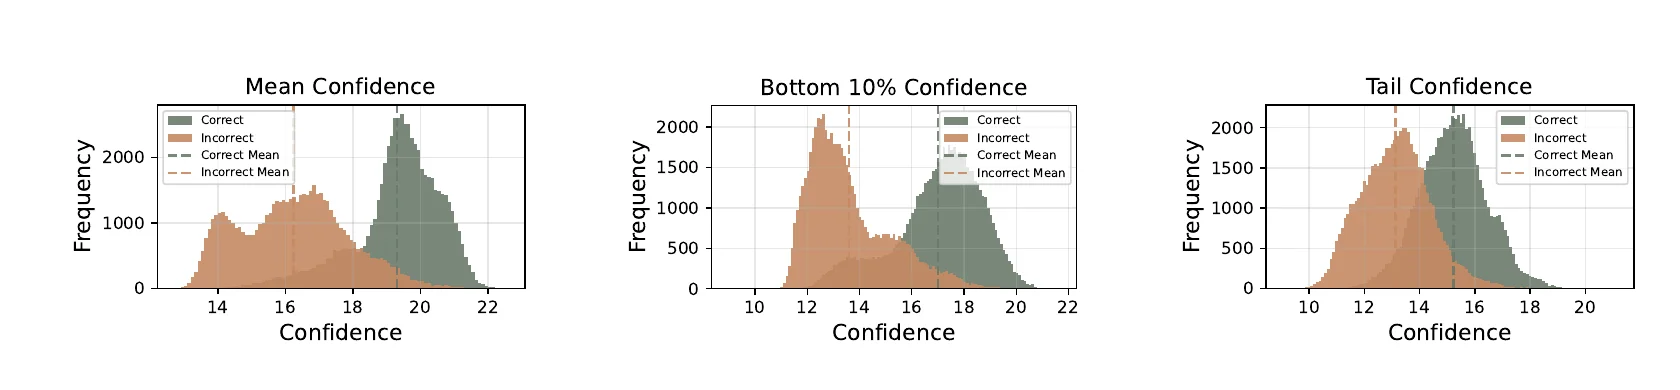
DeepConf는 같은 문제에서 여러 reasoning trace를 생성한 뒤 모두 같은 표로 세지 않고, 모델의 token probability에서 얻은 confidence로 경로를 평가하는 test-time scaling 방법이다. 별도 학습이나 외부 verifier 없이 완성...
DeepConf는 같은 문제에서 여러 reasoning trace를 생성한 뒤 모두 같은 표로 세지 않고, 모델의 token probability에서 얻은 confidence로 경로를 평가하는 test-time scaling 방법이다. 별도 학습이나 외부 verifier 없이 완성...
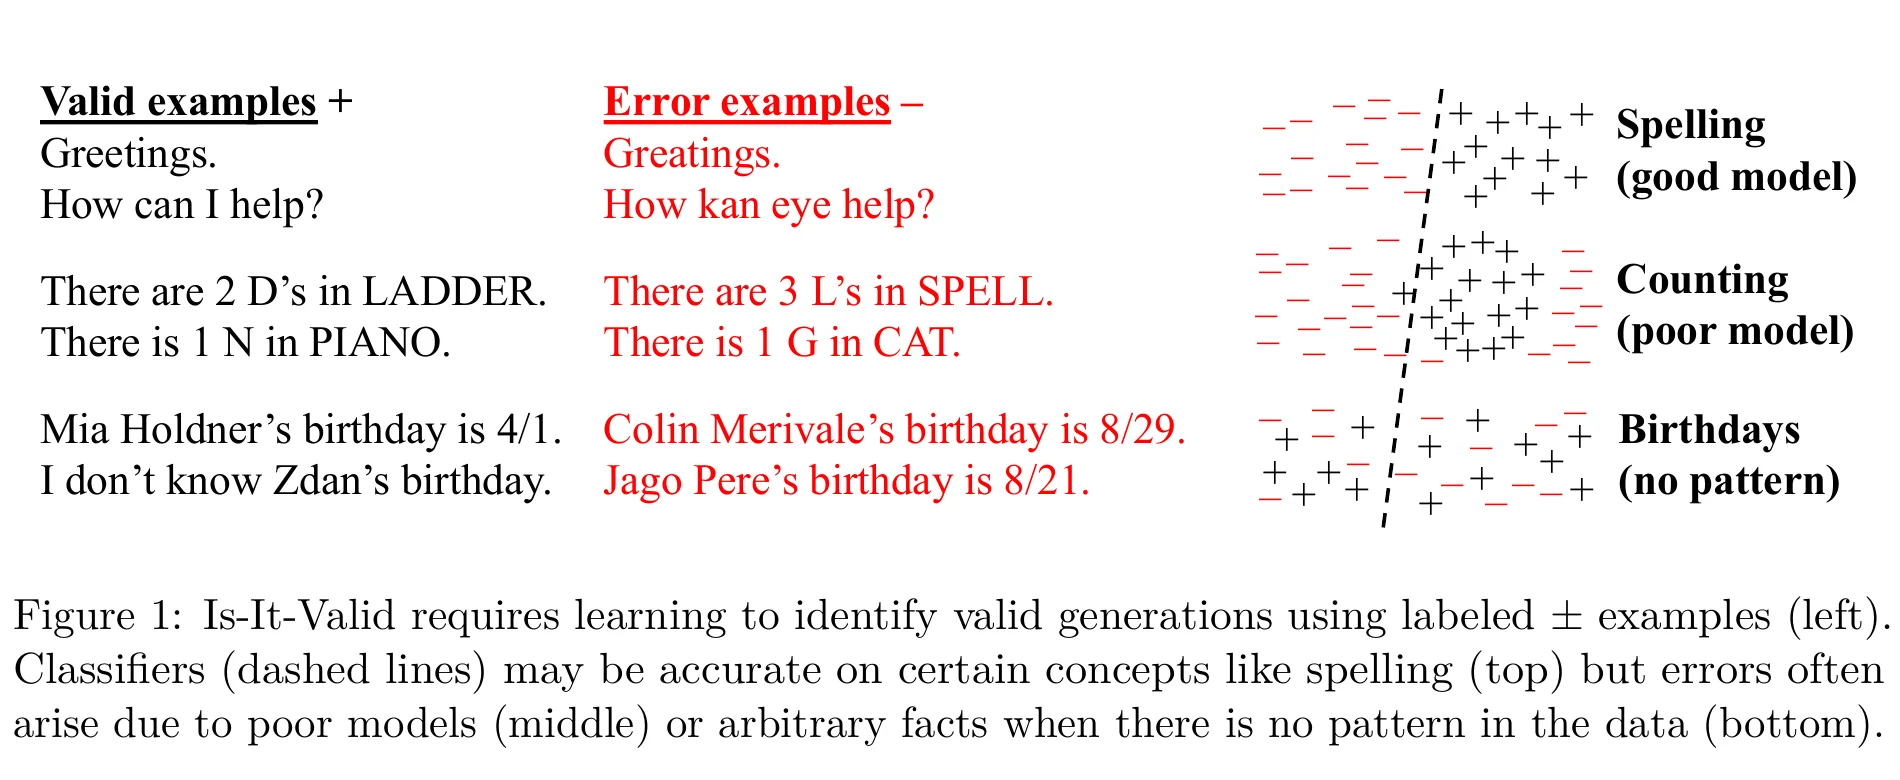
이 논문은 hallucination이 생기는 지점과 사라지지 않는 이유를 나눈다. 사전학습에서는 유효한 문장과 그럴듯한 오류를 구분하기 어려운 통계적 조건 때문에 생성 오류가 생기고, 사후학습과 평가에서는 불확실성을 밝히는 것보다 추측하는 편이 높은 점수를 받기 때문에 오류가 답변...
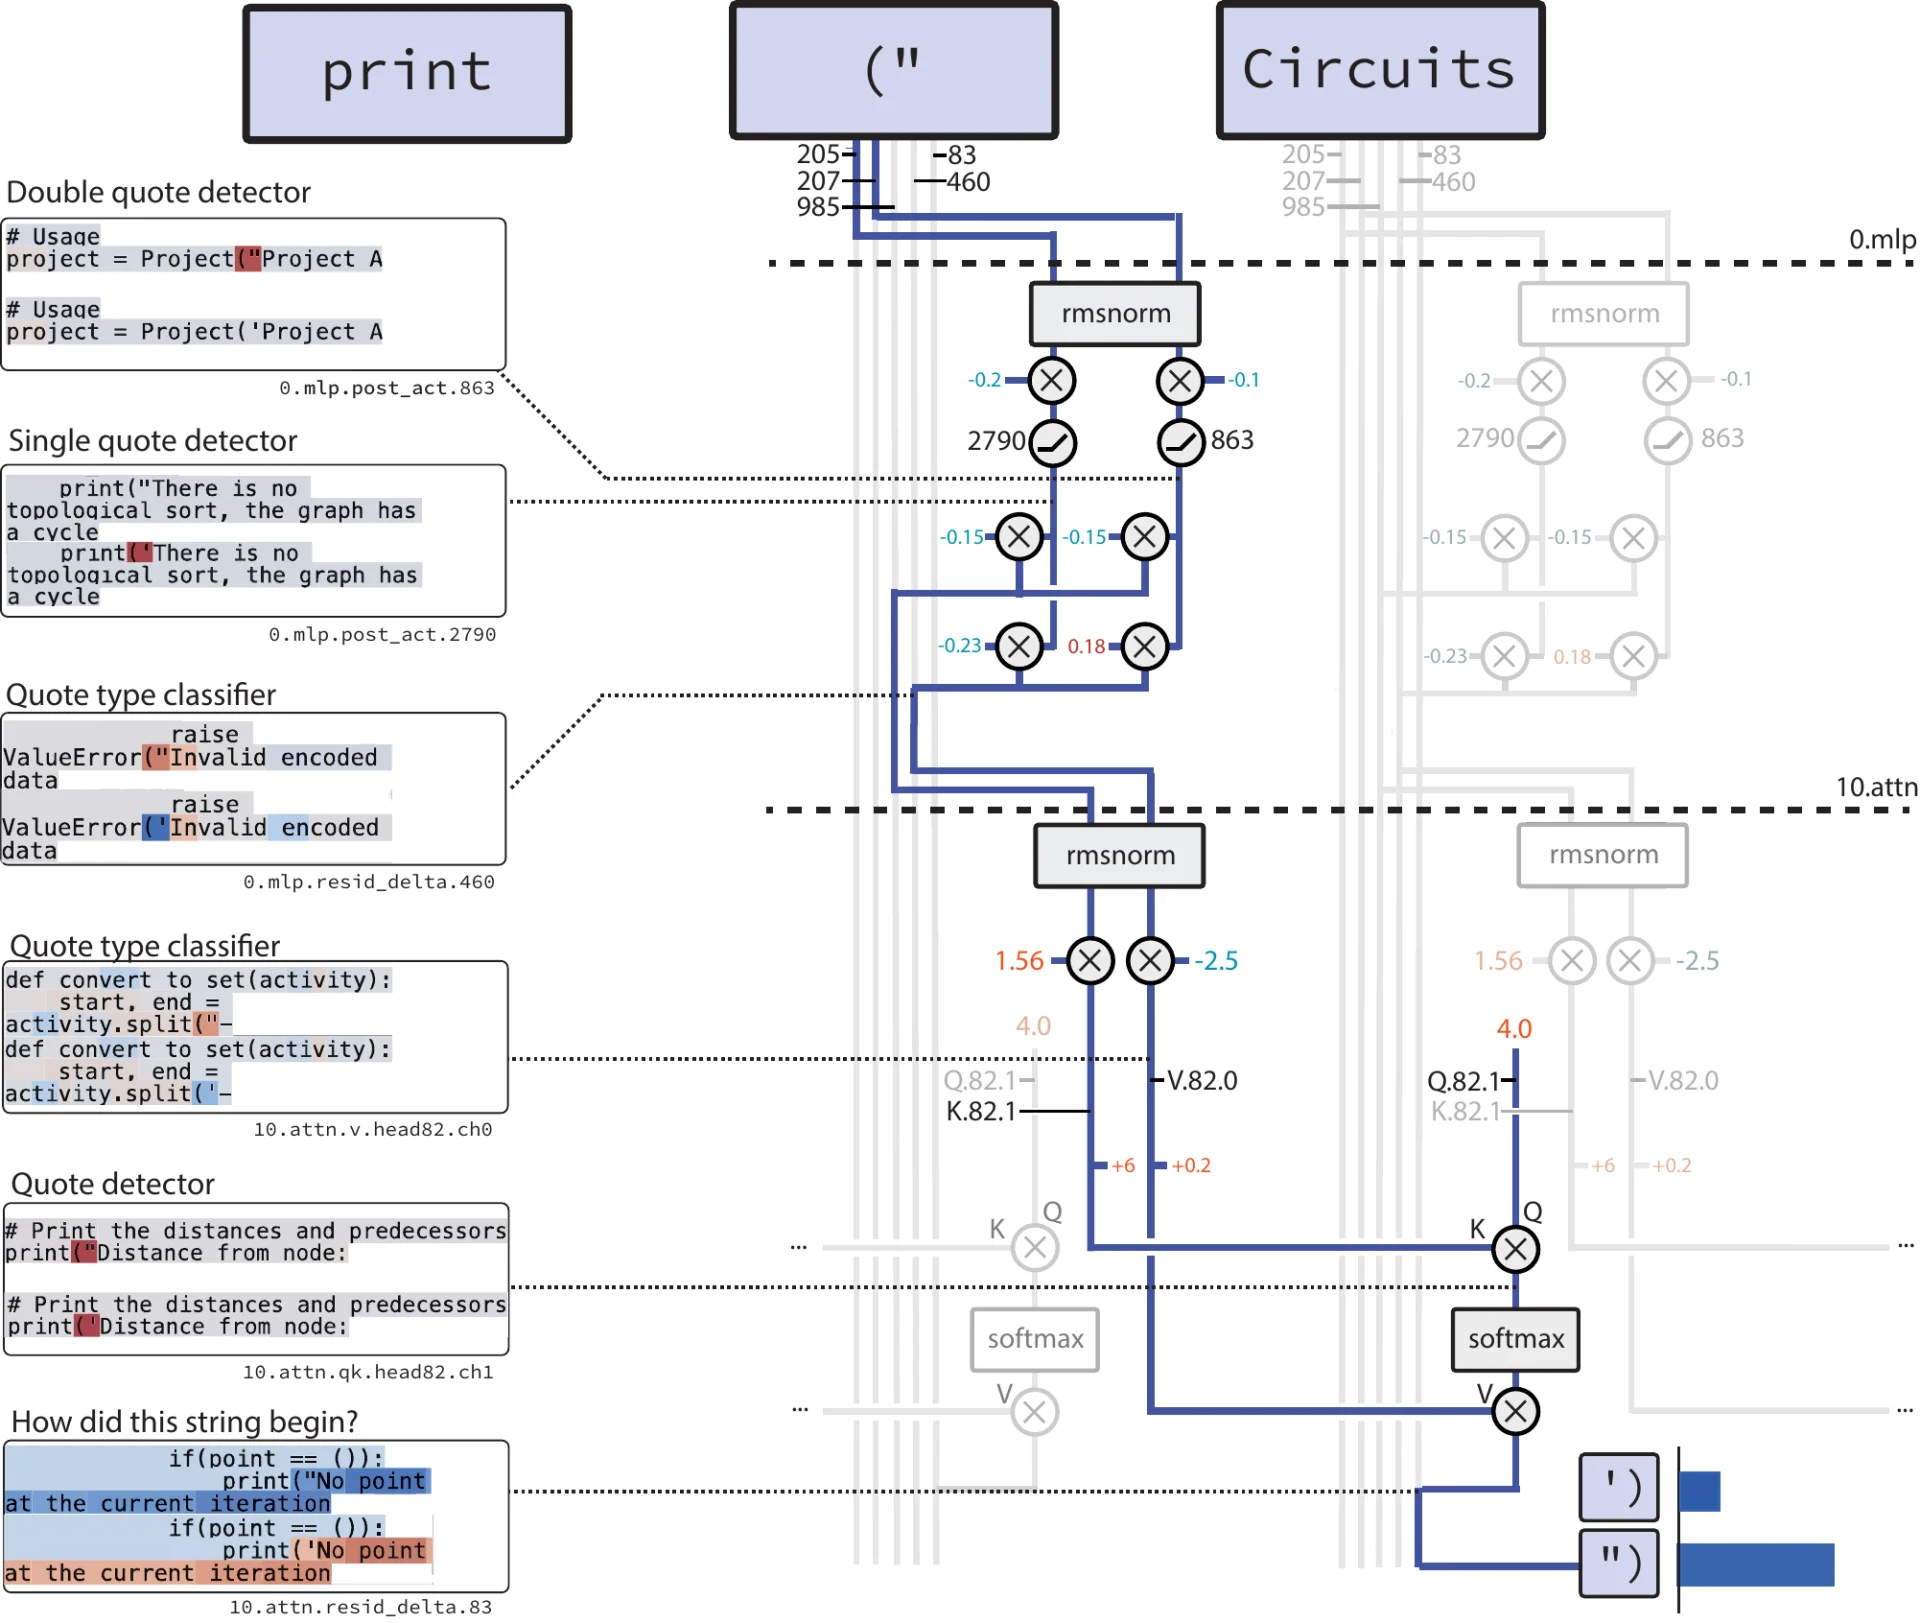
대부분의 weight를 정확히 0으로 둔 Transformer를 처음부터 학습하면, 특정 동작을 담당하는 circuit이 dense model보다 훨씬 작고 분리된 형태로 나타난다. 이 논문은 weight sparsity를 압축 기법이 아니라 해석 가능한 계산 구조를 유도하는 in...
Dragon Hatchling(BDH)은 attention과 working memory를 고차원 tensor 연산으로만 보지 않고, neuron-pair의 국소 상호작용과 synapse 변화로 다시 표현하려는 language model architecture다. 논문의 핵심은 실제...
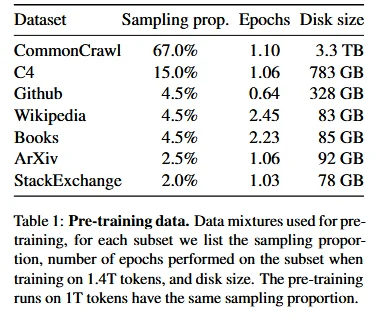
LLaMA는 7B, 13B, 33B, 65B 규모의 decoder-only foundation language model이다. 공개적으로 구할 수 있는 data만 사용하면서 작은 model을 기존의 compute-optimal 기준보다 훨씬 오래 학습해, inference cost...
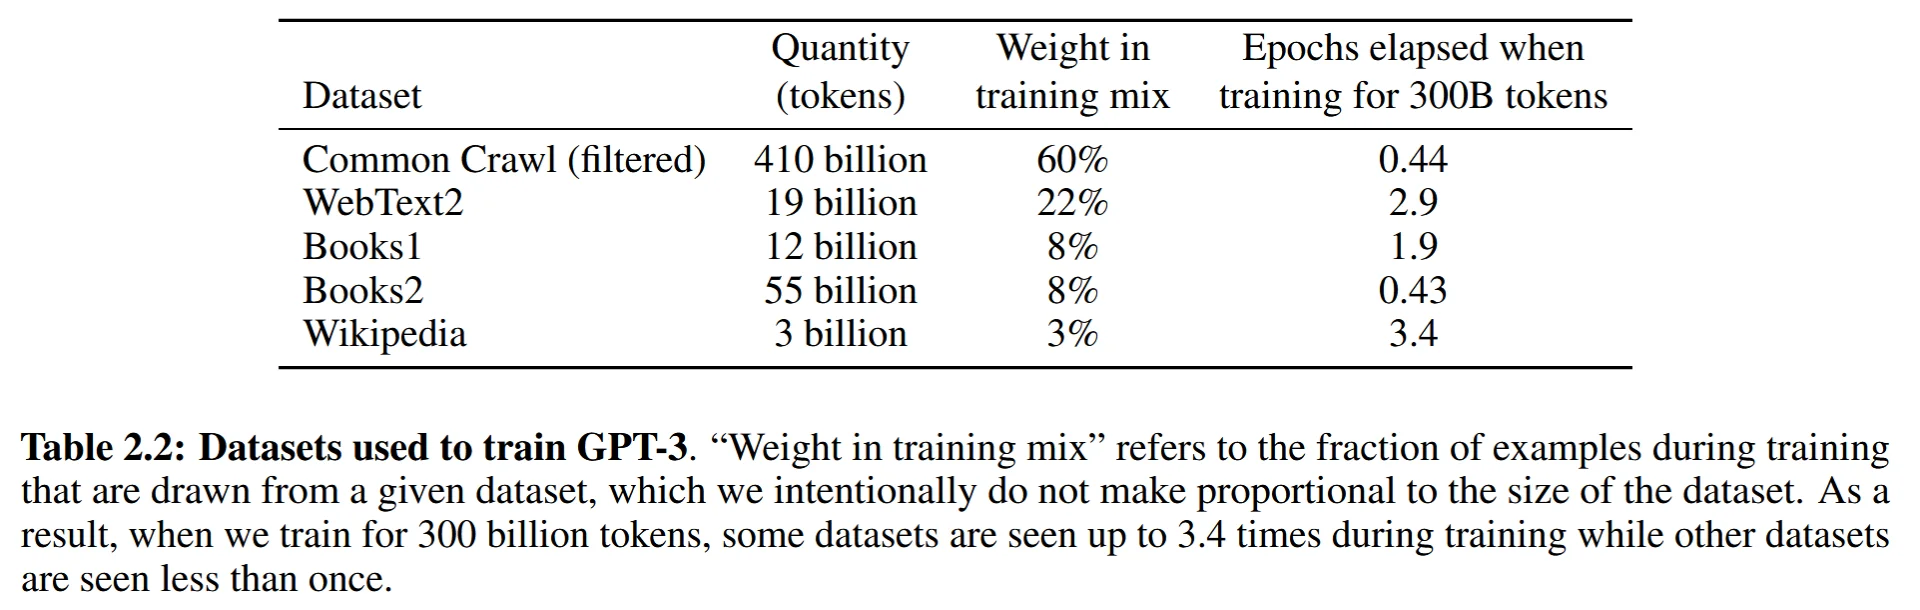
GPT-3는 175B parameter의 autoregressive language model을 task별로 fine-tuning하지 않고, instruction과 example을 context에 넣는 것만으로 여러 task에 적응시킨다. 핵심은 GPT-2보다 약 100배 큰 mo...
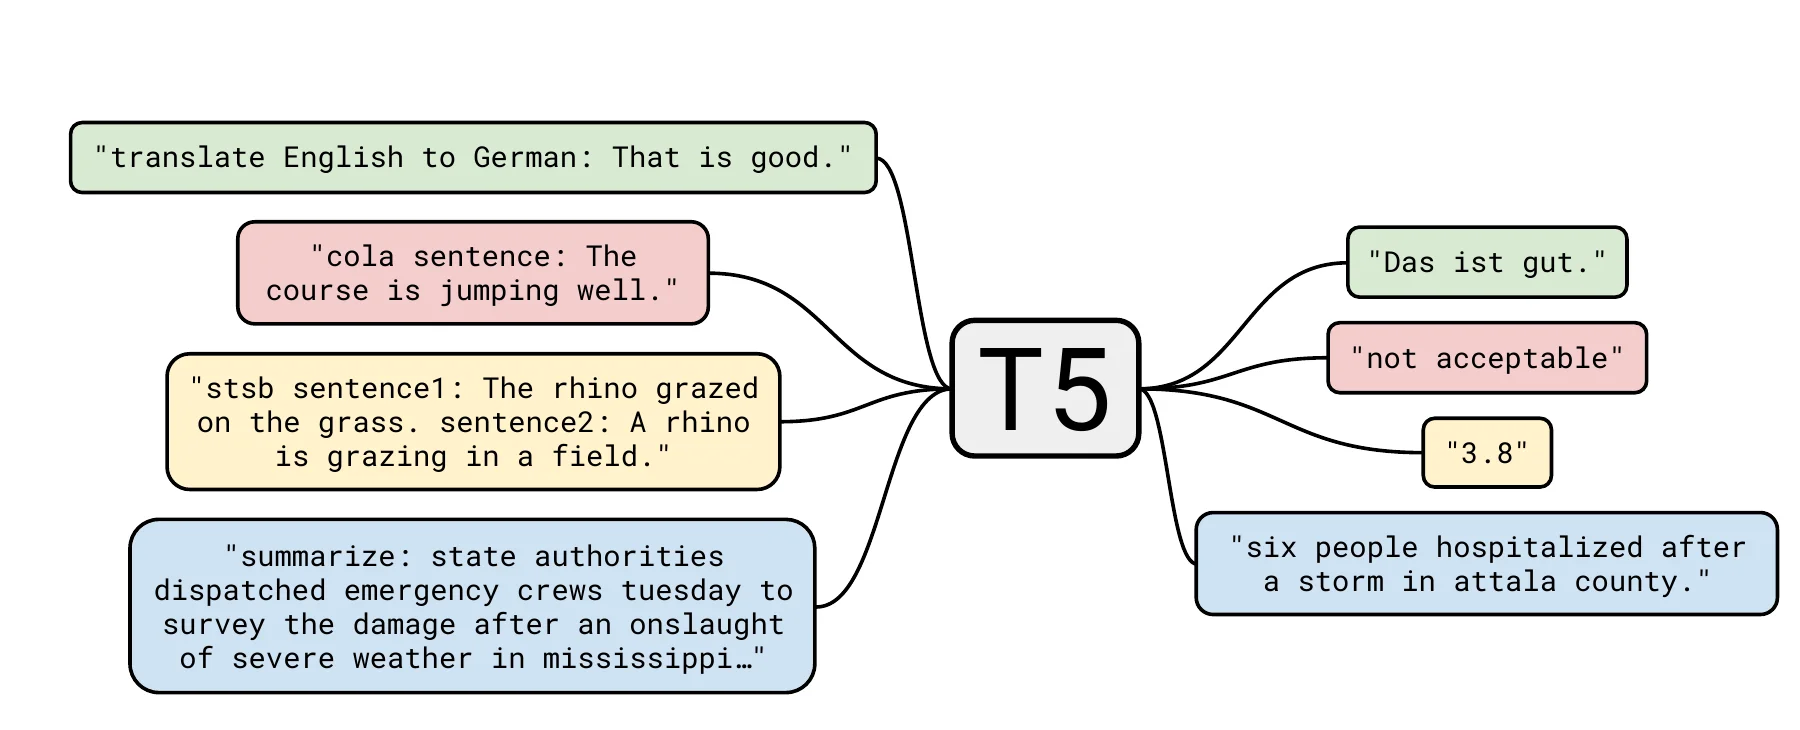
T5(Text-to-Text Transfer Transformer)는 분류, 질의응답, 요약, 번역처럼 입출력 구조가 다른 NLP 과제를 모두 text → text 문제로 바꾼다. 이 논문은 새로운 attention block을 제안하기보다 하나의 학습 interface 안에서 a...
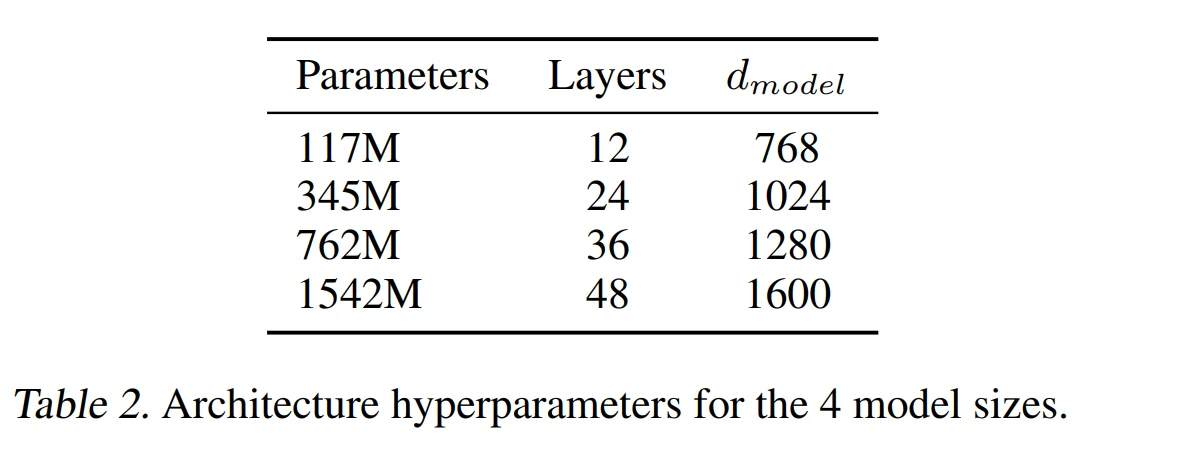
GPT-2는 task별 supervised training 없이, 다양한 web text로 학습한 language model 하나가 여러 NLP task를 수행할 수 있는지 시험했다. GPT-1이 pretrained representation을 task마다 fine-tuning했다...
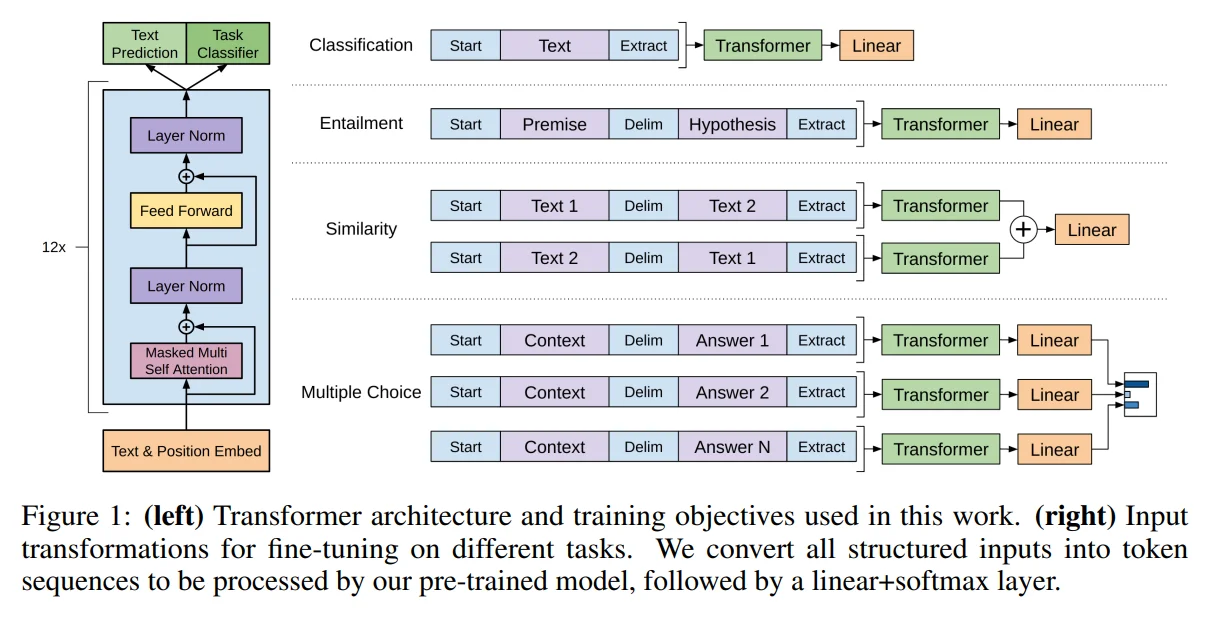
GPT-1은 대규모 unlabeled text로 Transformer language model을 먼저 학습한 뒤, labeled data가 있는 downstream task에 맞게 model 전체를 fine-tuning하는 두 단계 framework를 제시했다. 지금은 익숙한 방...
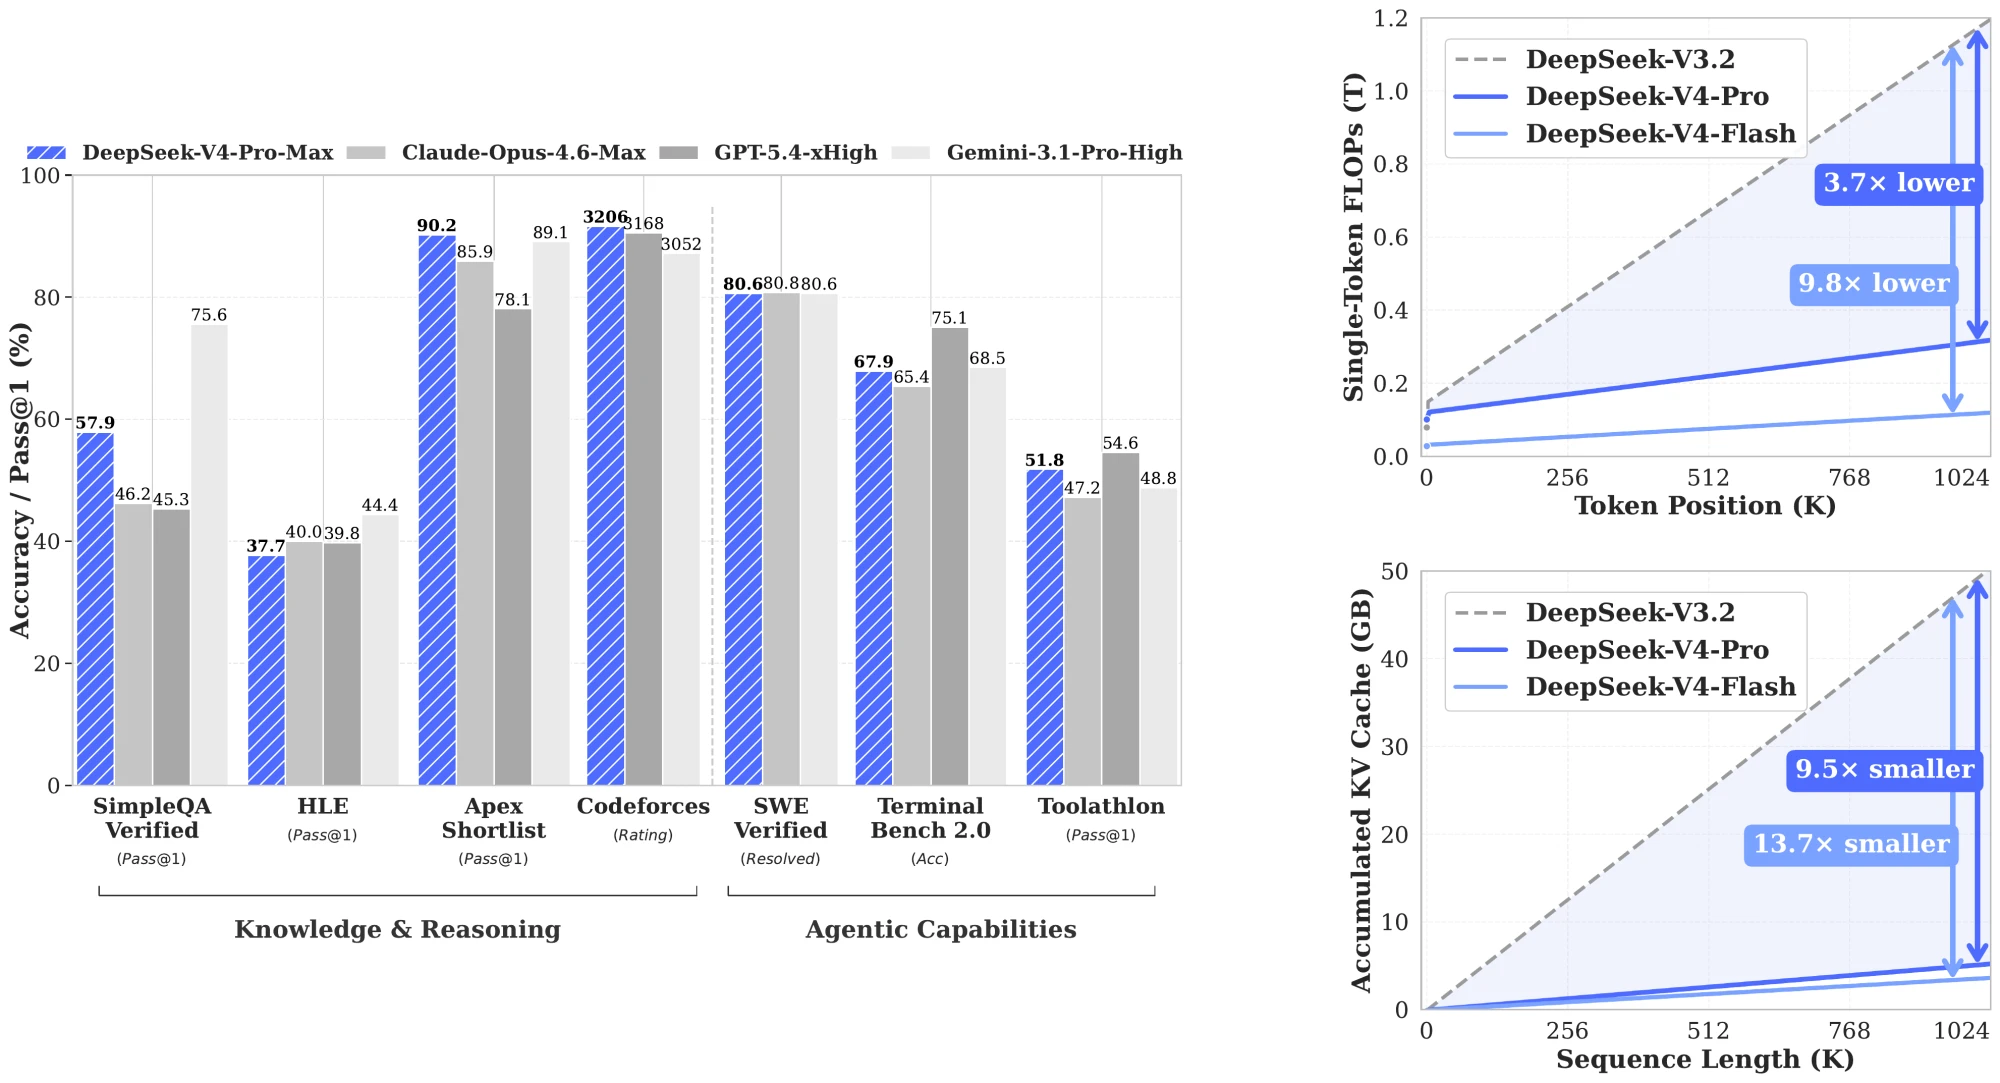
DeepSeek-V4는 100만 토큰 context를 처리하기 위해 attention 하나만 바꾼 모델이 아니다. Residual connection, MoE, optimizer, kernel, KV cache, RL rollout과 post-training을 같은 목표에 맞춰 함...
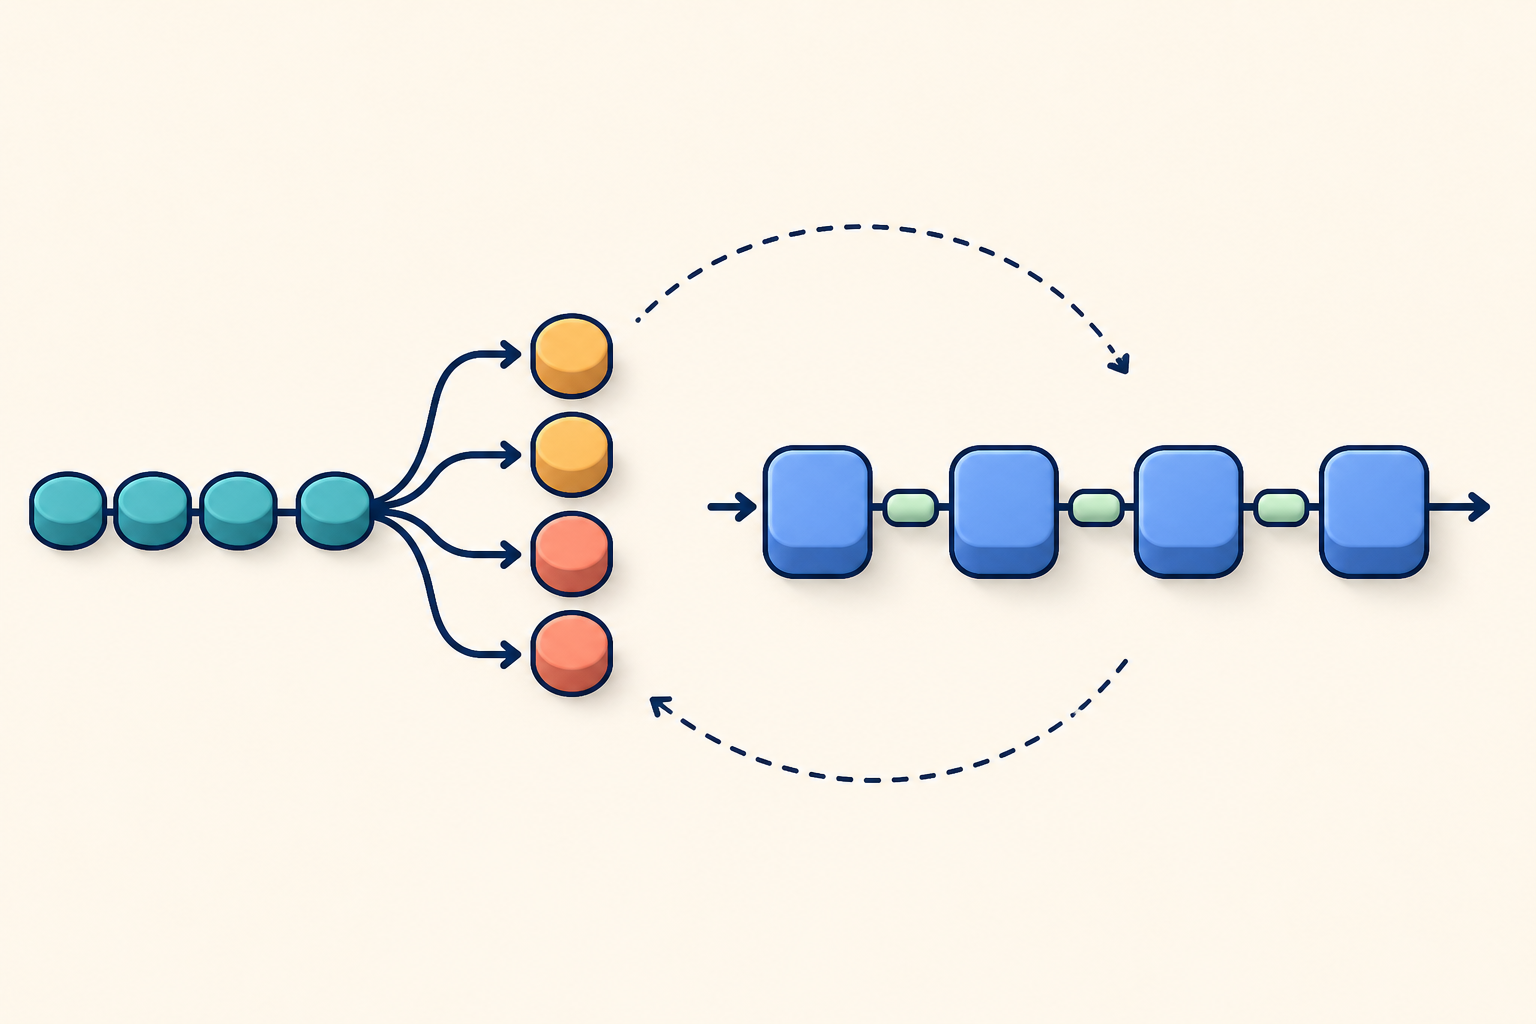
일반적인 언어 모델은 각 위치에서 바로 다음 token 하나를 예측한다. Multi-token Prediction(MTP)은 같은 context representation으로 앞으로 올 여러 token을 함께 맞히도록 학습한다.
Muon은 SGD momentum이 만든 2차원 행렬 update를 Newton–Schulz iteration으로 근사 직교화한 뒤 weight에 적용하는 optimizer다. 이름도 MomentUm Orthogonalized by Newton-Schulz에서 왔다.
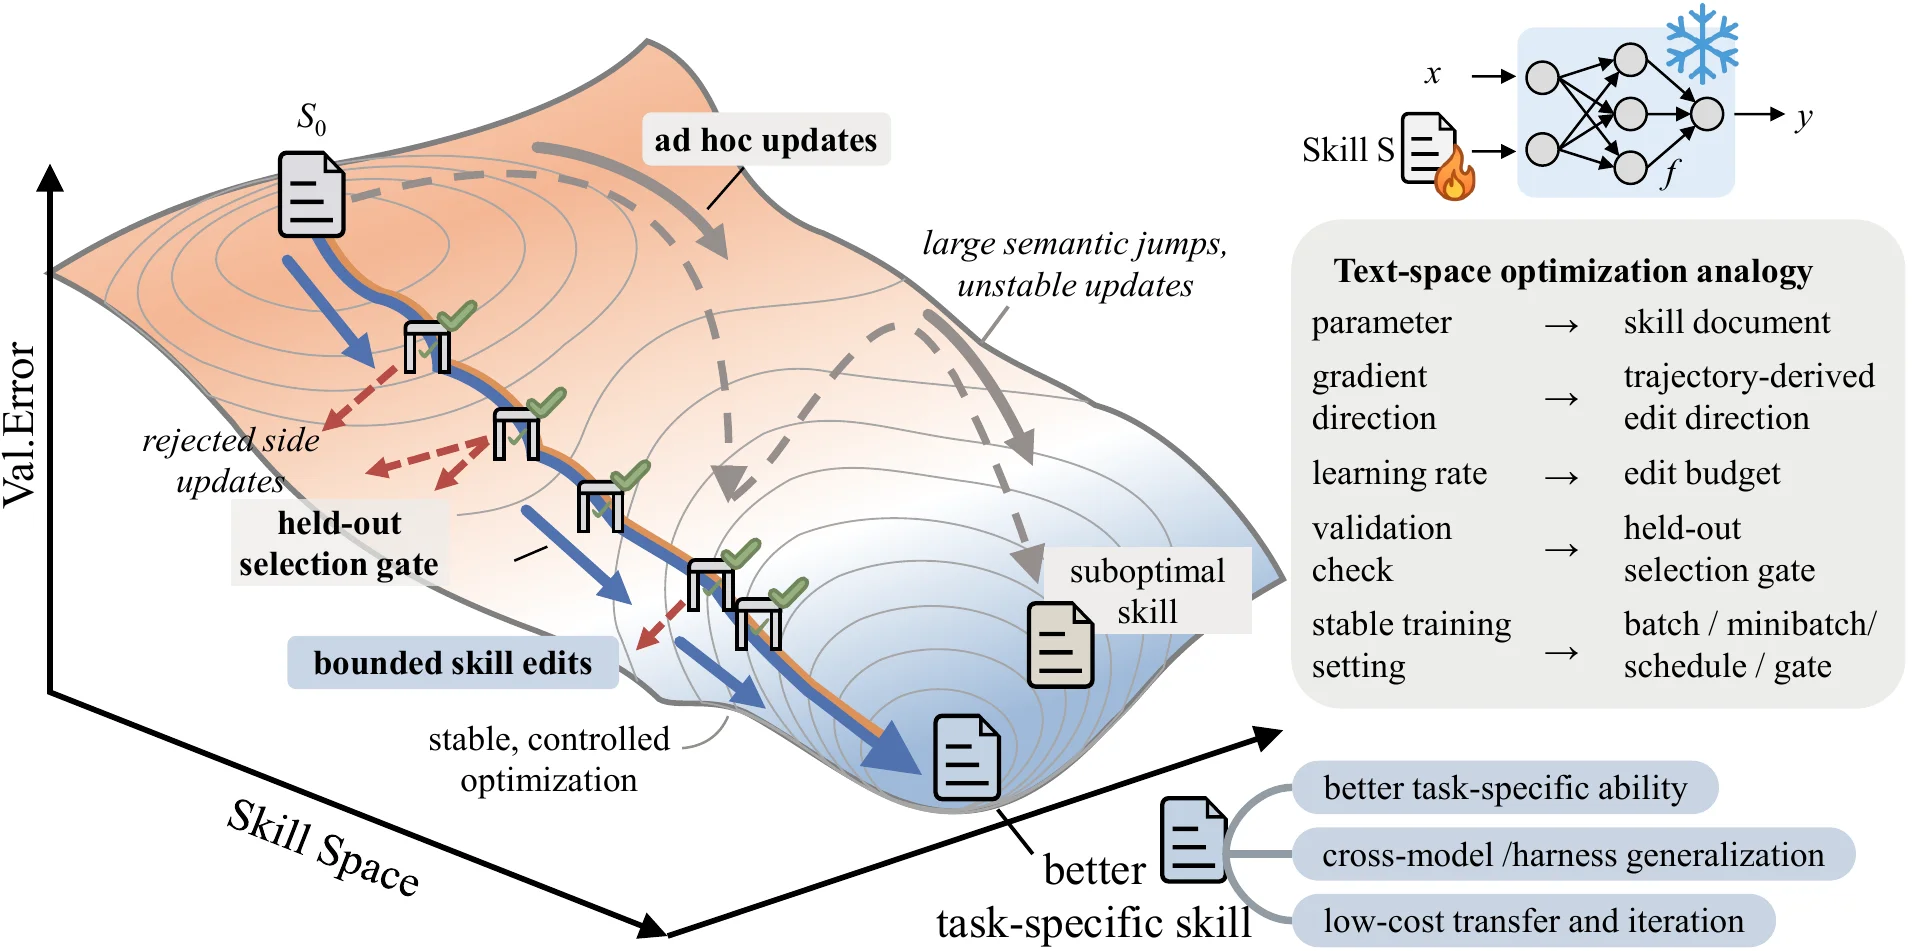
SkillOpt는 모델 가중치를 고정한 채 에이전트의 skill 문서를 최적화한다. 실패한 rollout을 읽고 규칙을 추가·삭제·교체하되, held-out validation 점수가 실제로 올랐을 때만 새 문서를 채택한다.
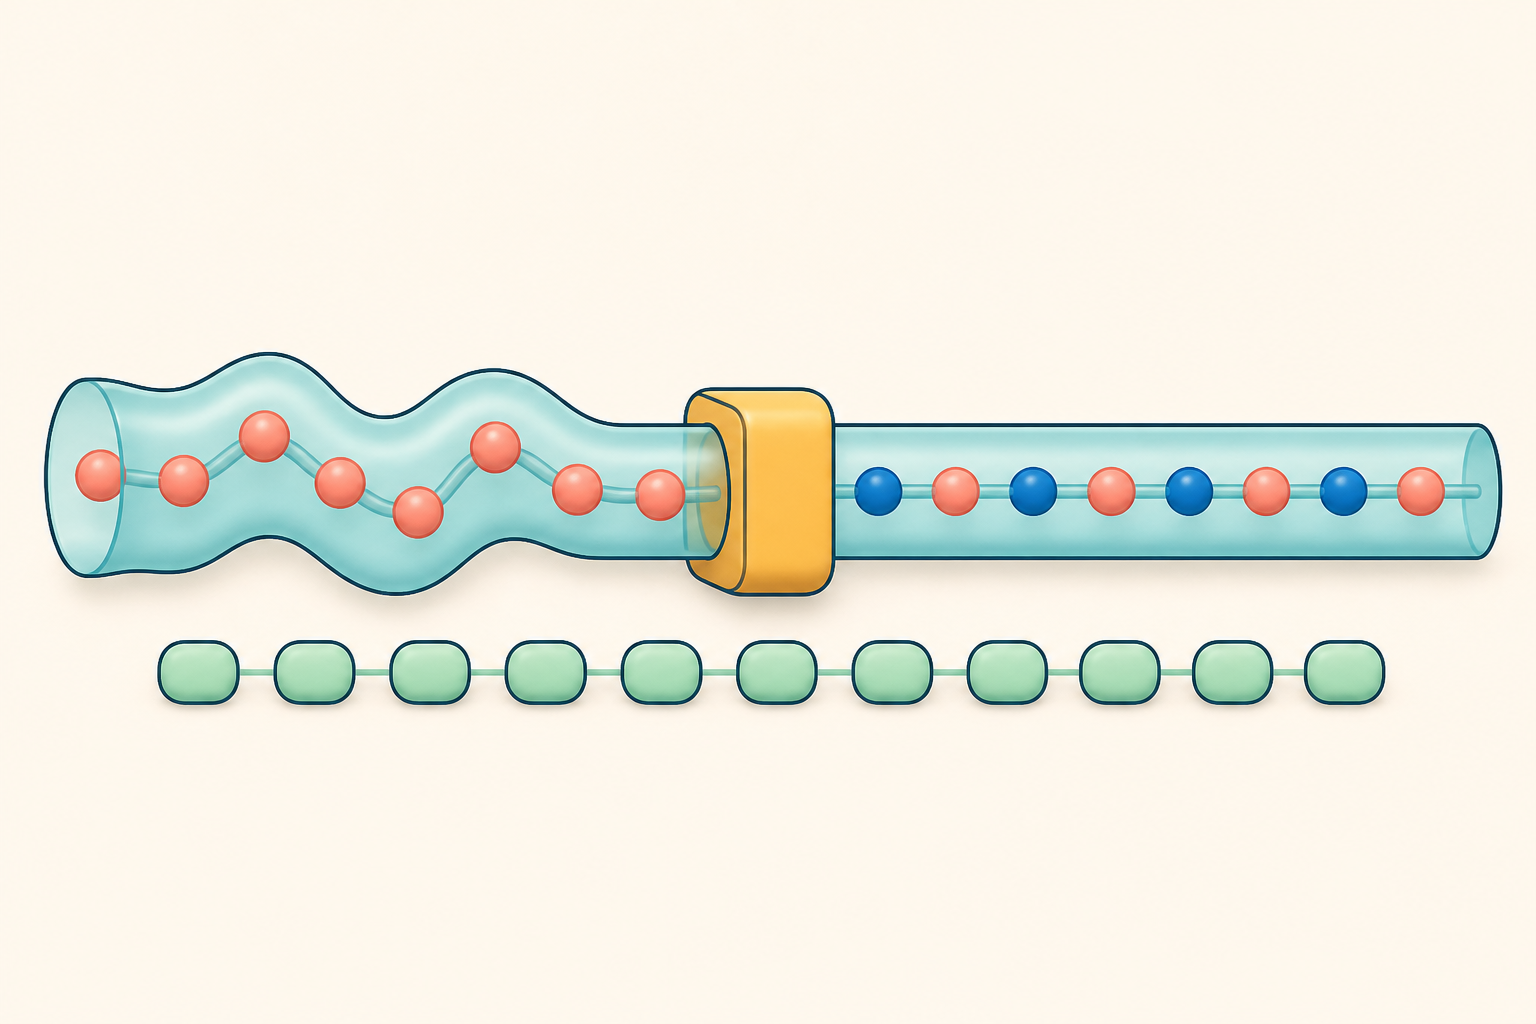
Semantic Tube Prediction(STP)은 한 token sequence 안에서 앞·뒤 hidden-state의 이동 방향을 맞추는 학습법이다. 별도의 target encoder나 두 view 없이 기존 forward의 hidden state를 재사용한다.
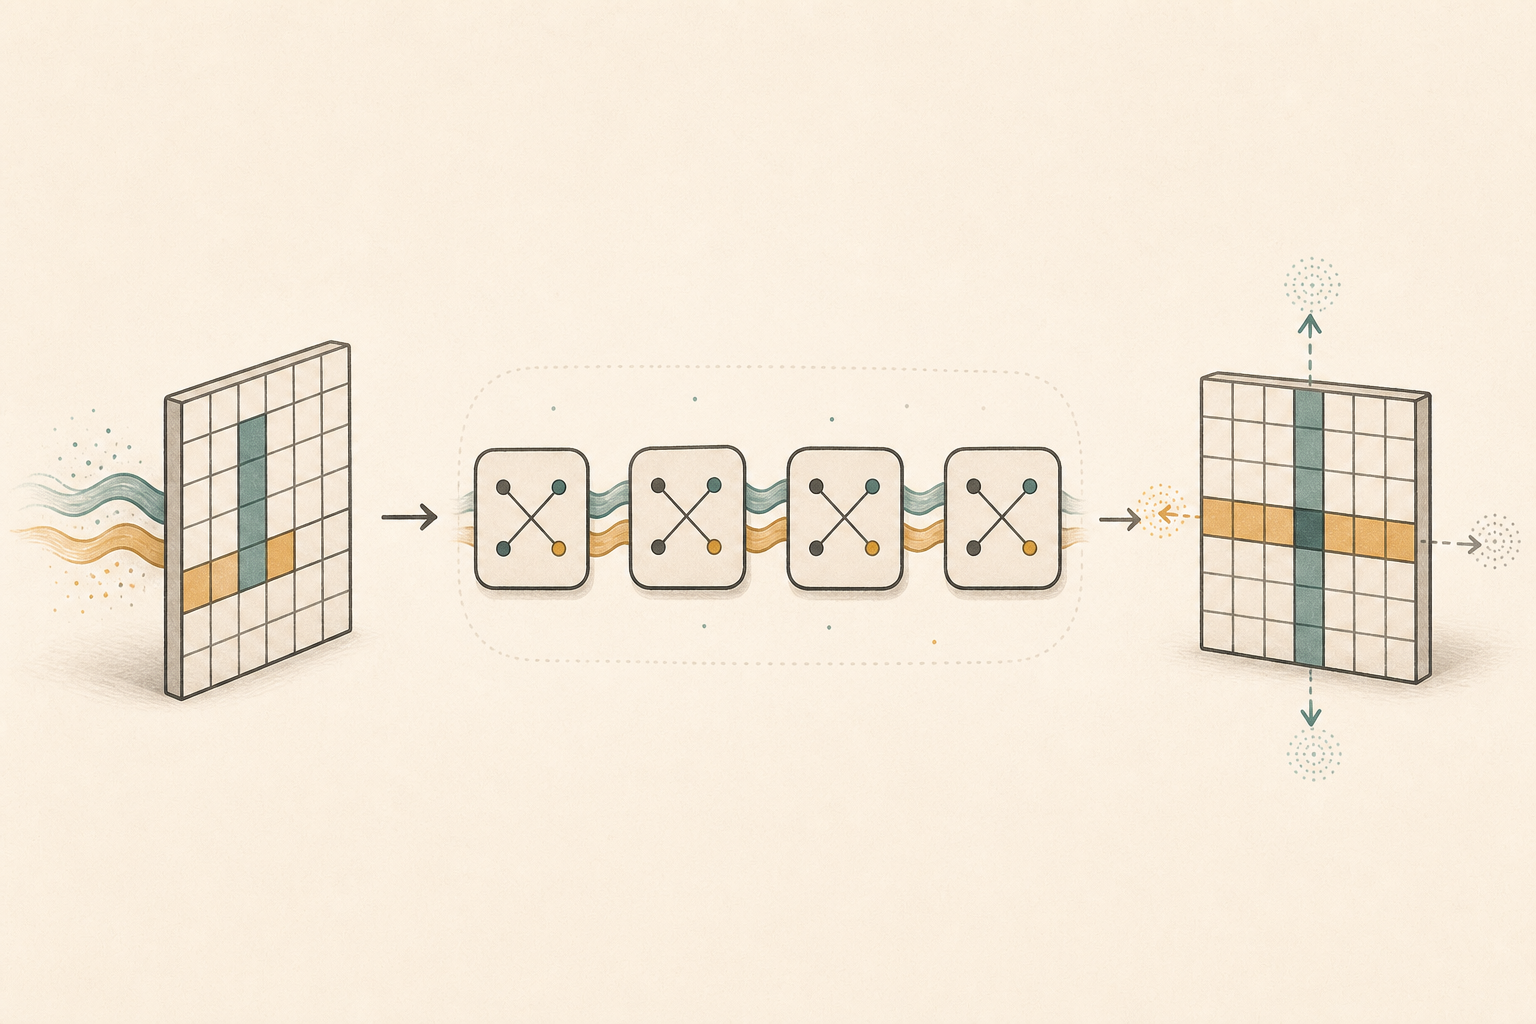
LLM-JEPA는 Transformer를 새로 설계하지 않는다. 기존 Next Token Prediction(NTP)에, 같은 의미를 가진 두 표현의 hidden representation을 맞추는 보조 loss를 더한다.
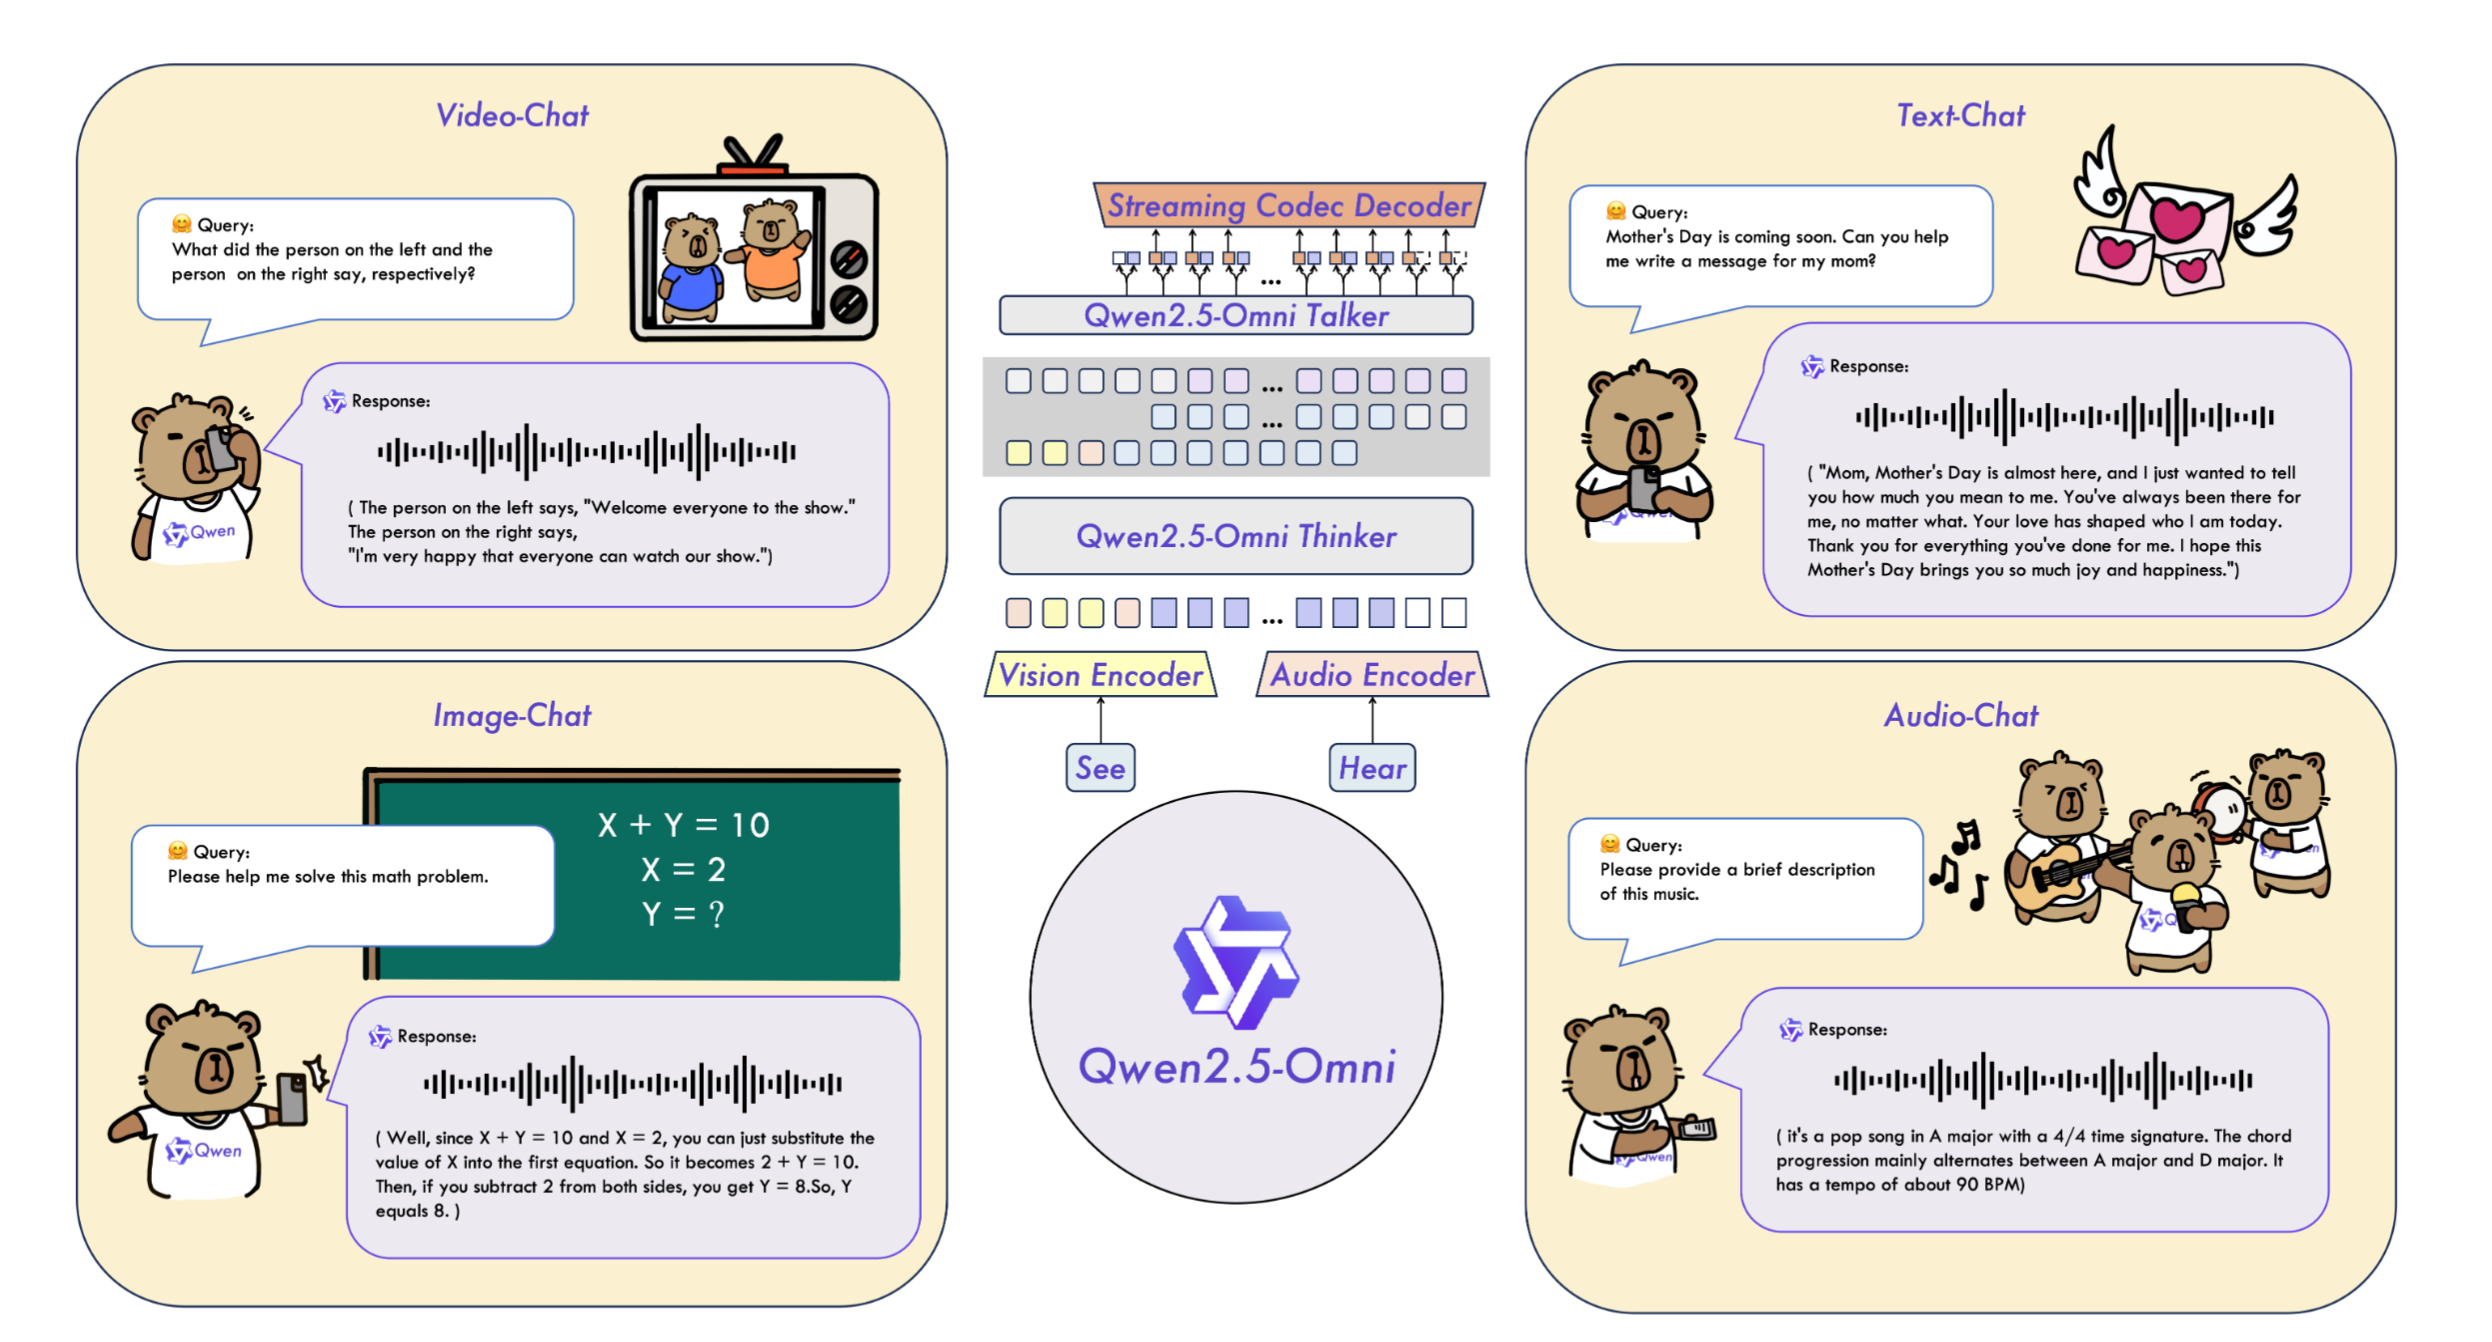
Qwen2.5-VL을 정리한 뒤, 오디오까지 함께 다루는 모델이 어떻게 구성되는지 궁금해서 Qwen2.5-Omni Technical Report를 중심으로 스터디 내용을 정리했다.
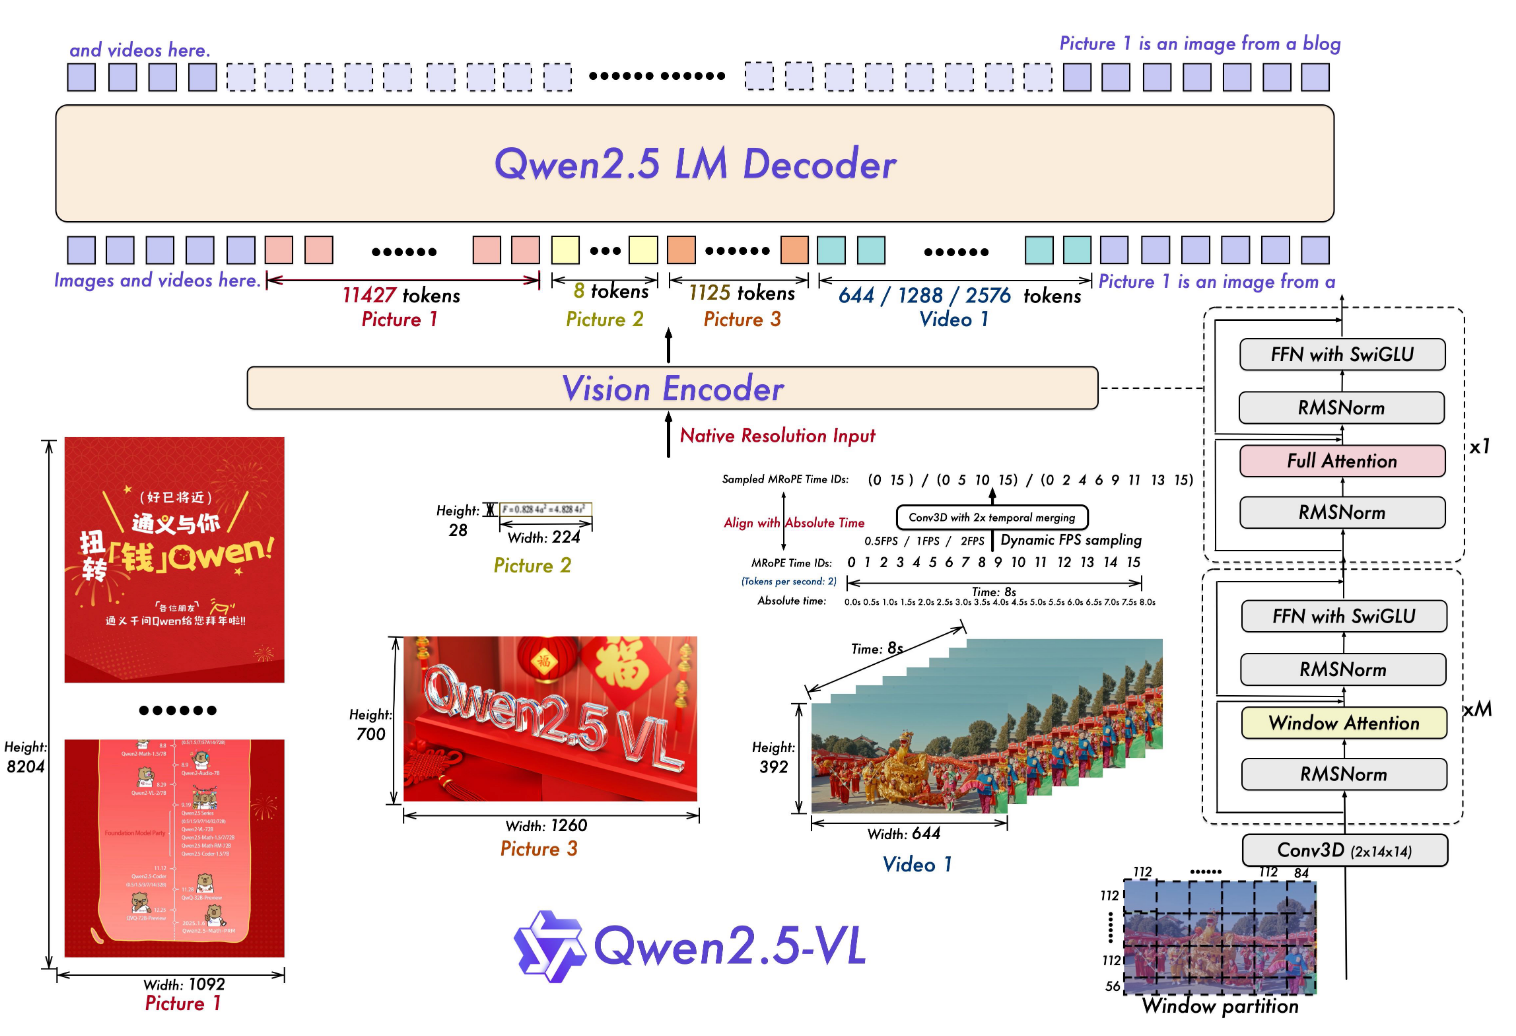
요즘 AI 서비스들은 대부분 이미지 인식 기능을 탑재하고 있다. 과연 이런 멀티모달 VLM은 실제로 어떤 모델 구조를 가지고 있을까?
똑같은 말만 하던 LLM에게 다양한 대답을 얻는 방법이 있다고한다. 훈련 없이, 오직 프롬프트만으로 다양성을 끌어올리는 접근이다.
저번에 소개한 JEPA 계열의 최신 논문, Vision-Language JEPA다. 월드 모델(world model) 관점에서 보았을 때 충분히 경쟁력 있는 비전‑언어 아키텍처로 보인다.
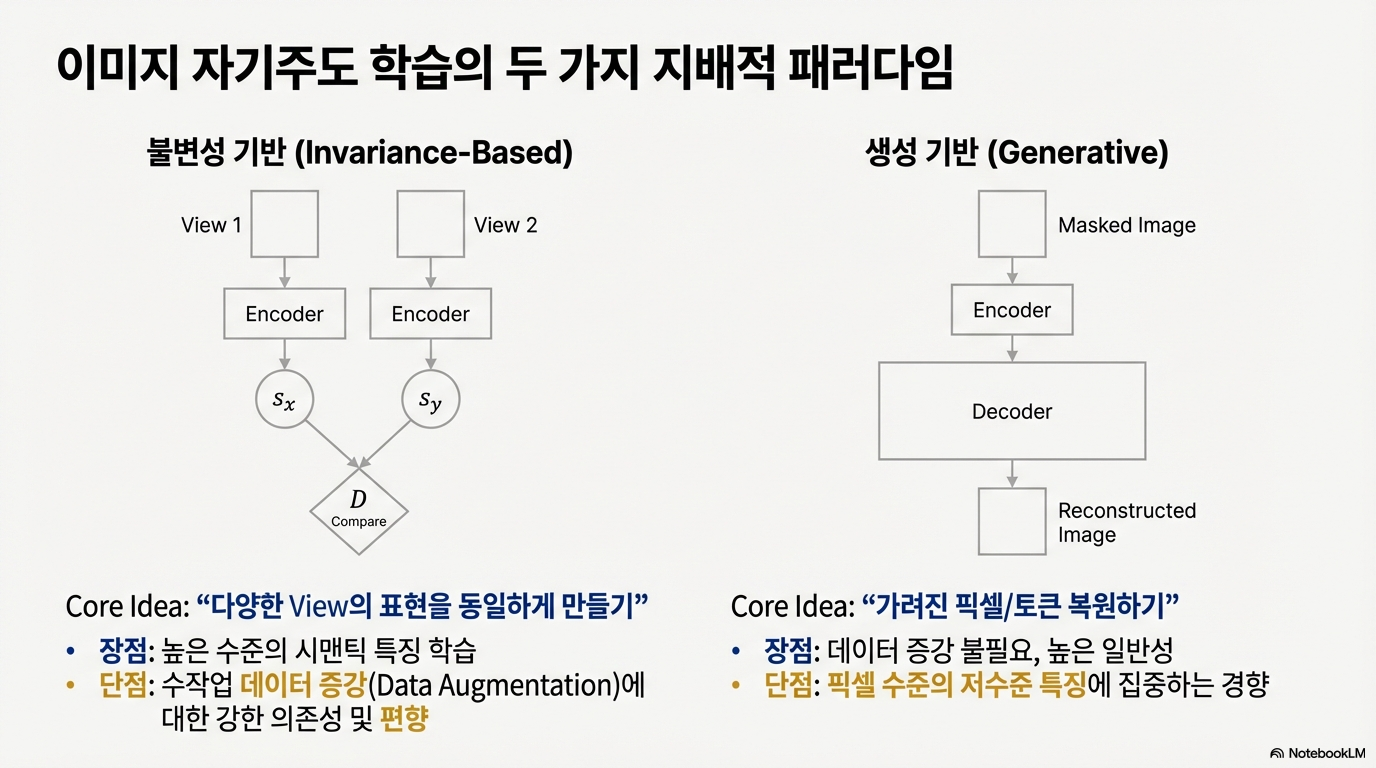
Meta의 얀 르쿤은 LLM(생성형 모델)만으로는 AGI에 도달하기 어렵다고 보고, 생성 중심 패러다임을 넘어 월드 모델을 연구하고 있다. 그 흐름 속에서 VL-JEPA, V-JEPA 등이 등장했고, I-JEPA는 JEPA 시리즈의 시작점이 되는 이미지 자기지도 학습 논문이다.
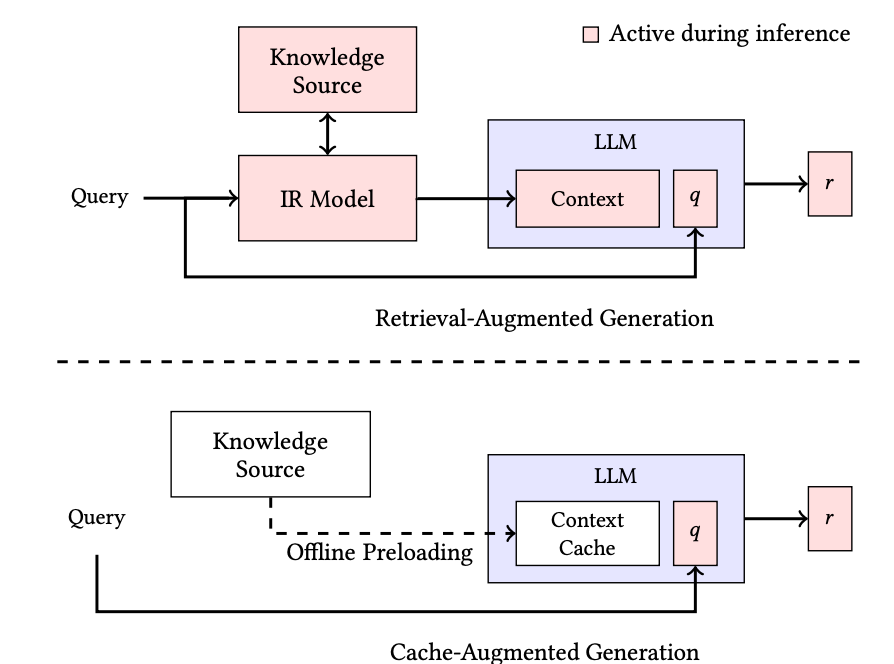
이 논문은 “RAG 대신 CAG를 쓰자”는 주장이다. (Retrieval → Cache) 핵심은 KV Cache 재활용이다.
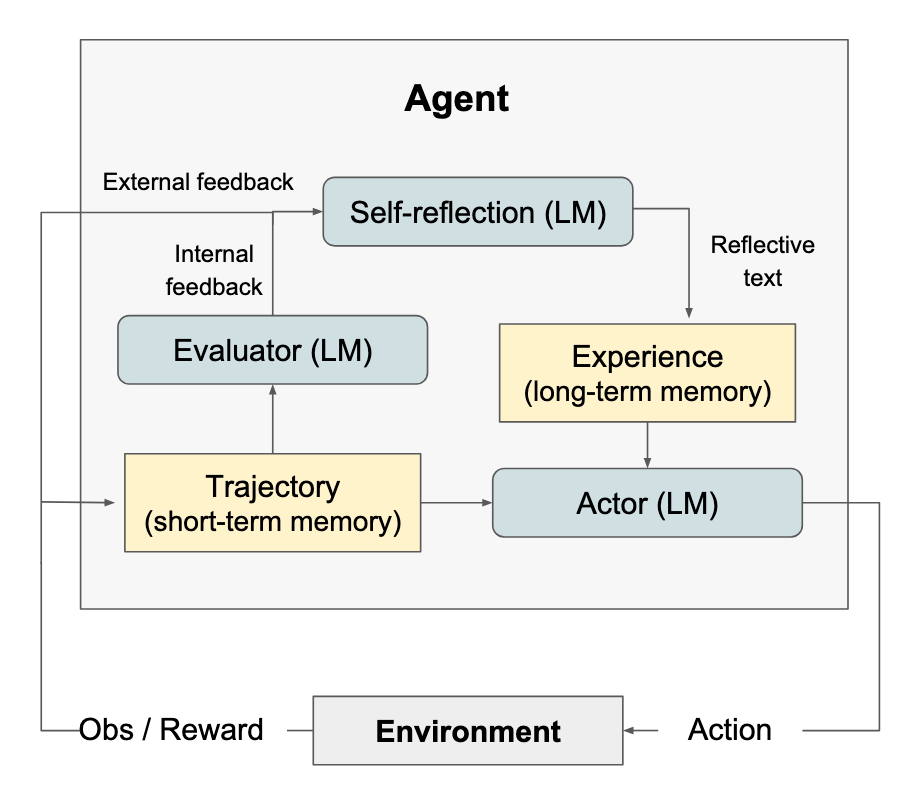
Reflexion은 2023년 10월에 나온 논문으로, LLM이 시행착오로부터 스스로 피드백을 생성하고 개선할 수 있는 프레임워크이다.
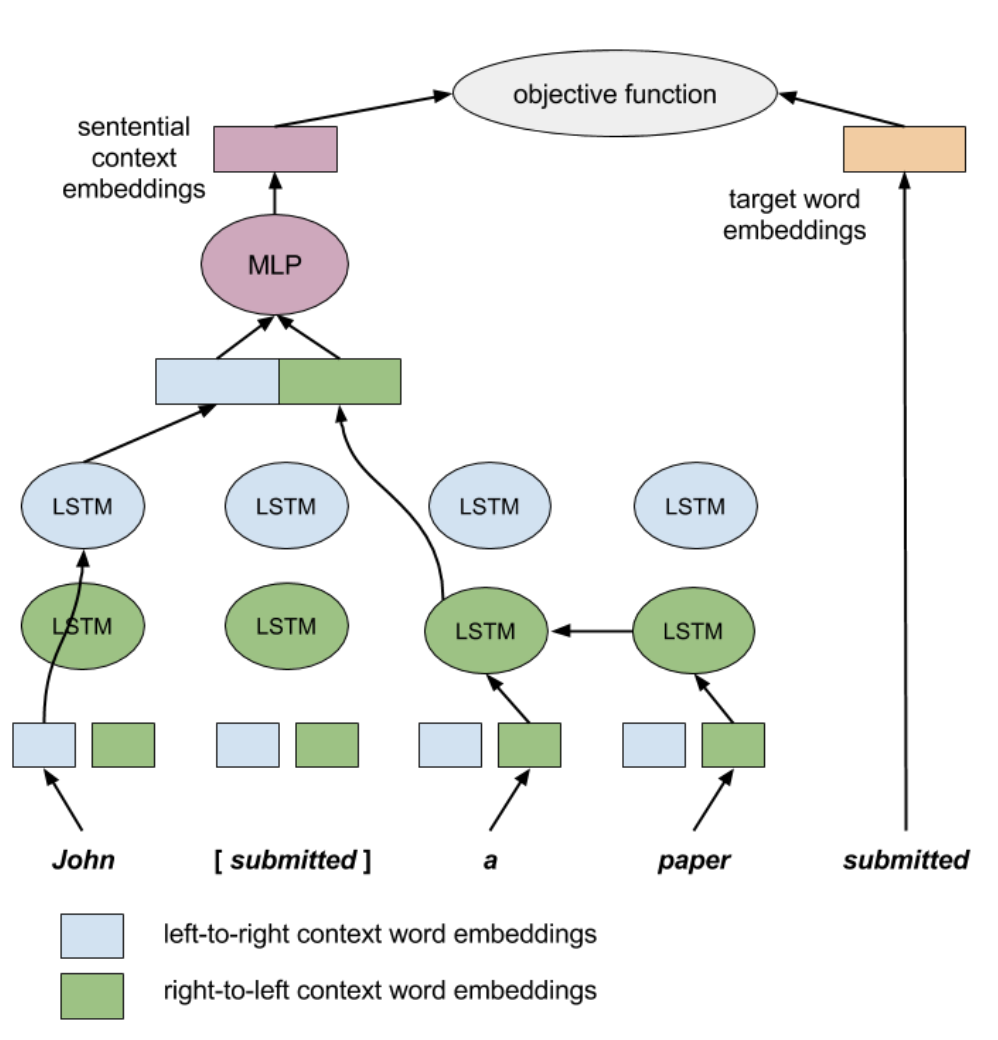
Bidrectional Encoder Representations from Transformers(BERT)는 unlabeled text로부터 좌우 문맥을 포함한 양방향 표현을 사전학습하게 설계된 모델이다. 또한, Question Answering, 언어 추론 같은 광범위한 작업에...
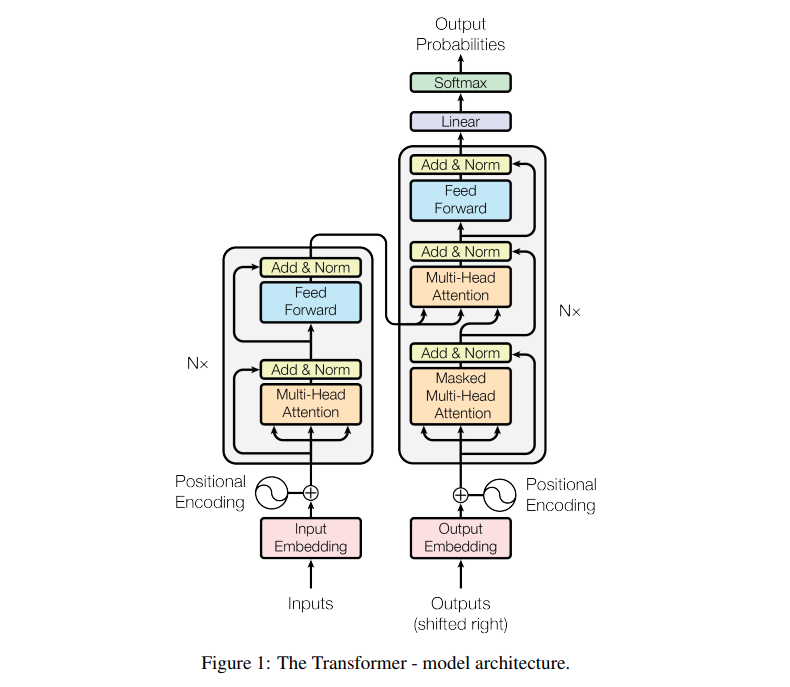
기존 sequence 변환 모델은 RNN 또는 CNN 기반의 인코더-디코더 구조를 바탕으로 한다. 최고 성능의 모델들은 여기에 attention mechanism 을 사용하고 있는데, 우리는 RNN과 CNN을 배제한 채 attention mechanism 만을 사용하는 새로운 구조...