Google Agent 백서 3편 리뷰 - Agent 구조부터 Session과 Memory까지
세 백서는 agent를 서로 다른 층위에서 다룬다. Agents는 model을 tool과 orchestration으로 감싸 행동 가능한 system으로 만드는 법을, Agents Companion은 그 system을 평가하고 production에서 운영하는 법을, Context Engineering: Sessions & Memory는 여러 요청과 session에 걸쳐 state를 유지하는 법을 설명한다.
Agent의 병목은 model 밖에 있다
세 문서를 이어 읽으며 잡은 중심은 agent가 LLM 하나가 아니라 실행 loop 전체라는 점이다. Model의 추론 능력만으로는 agent가 되지 않는다. 사용할 수 있는 tool, 다음 행동을 고르는 orchestration, 현재 작업의 state, 장기 memory, 권한과 실패 처리가 함께 동작해야 한다.
따라서 agent의 품질도 최종 답변만 보고 판단할 수 없다. 어떤 tool을 왜 골랐는지, 필요한 순서와 범위 안에서 실행했는지, 실패했을 때 복구했는지까지 trajectory로 봐야 한다. Prototype을 production으로 옮긴다는 것은 prompt를 더 길게 쓰는 일이 아니라 이 실행 경로를 관찰·평가·통제할 수 있게 만드는 일이다.
Memory 역시 대화 전문을 저장하거나 vector database에 넣는 것과 다르다. 앞으로 다시 쓸 정보만 추출하고, 기존 기억과 중복·충돌을 조정하며, 근거가 된 source와 최신성을 추적하고, 필요 없어지면 잊는 능동적인 data lifecycle이다. 성공한 작업 절차를 playbook으로 남기는 procedural memory까지 포함하면 memory는 개인화뿐 아니라 agent가 일하는 방식 자체를 개선하는 기반이 된다.
1. Agents: model을 행동 가능한 system으로 묶기
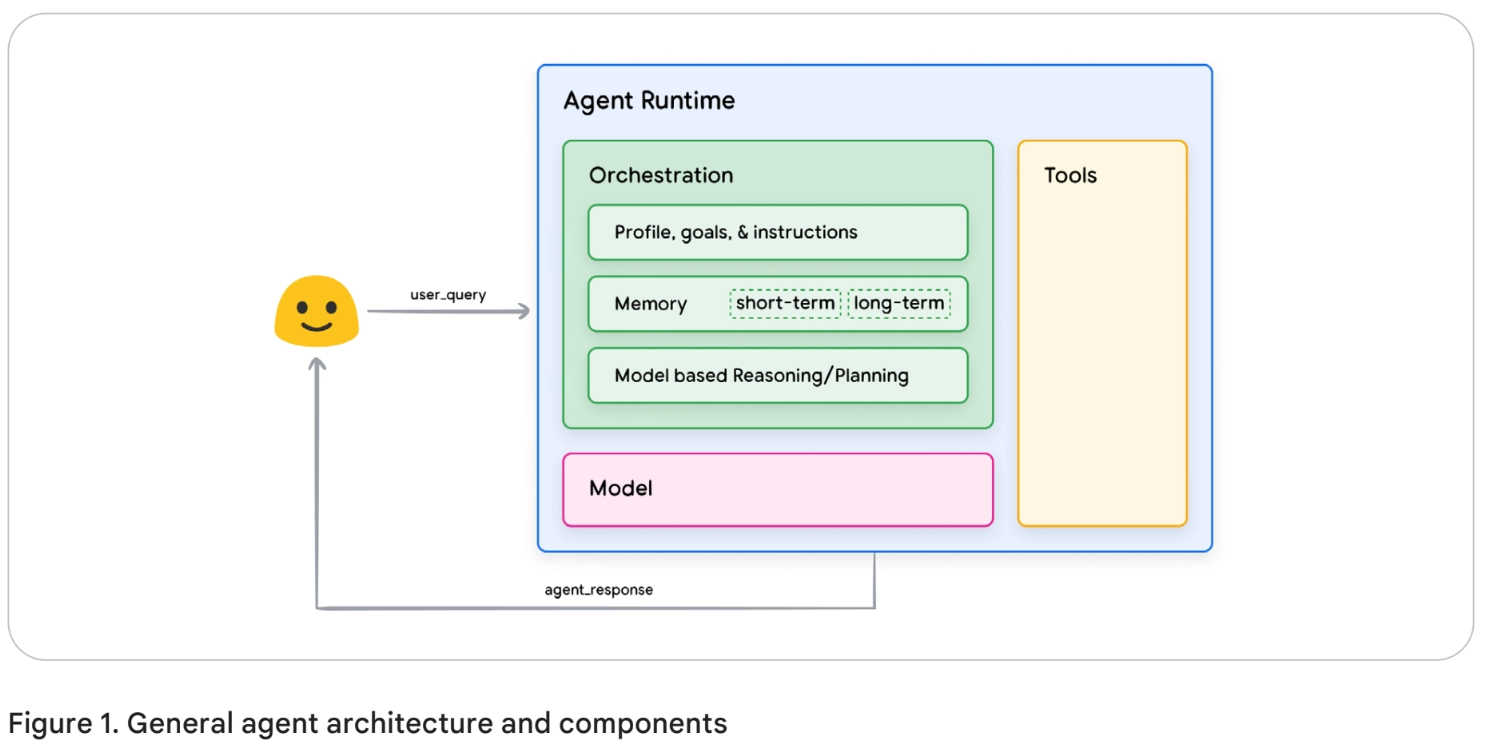
Agent는 주어진 목표를 위해 환경을 관찰하고 다음 행동을 선택하며 tool로 외부 세계에 작용하는 application이다. 백서의 세 구성요소는 다음과 같다.
- Model: 입력을 해석하고 reasoning·planning을 수행하며 다음 action을 고른다.
- Tools: 검색, database 조회, API 호출처럼 model의 학습 data 밖에 있는 정보를 얻거나 실제 상태를 바꾼다.
- Orchestration: 관찰 → 추론 → 행동 → 결과 관찰의 loop를 돌리고, 목표·지침·state·memory와 중단 조건을 관리한다.
ReAct 같은 방식은 이 orchestration loop의 한 구현이다. 중요한 것은 model이 긴 reasoning text를 만든다는 사실이 아니라, reasoning 결과가 tool call로 이어지고 tool output이 다음 판단의 입력으로 돌아오는 feedback loop를 구성한다는 점이다.
Tool 실행 권한의 위치
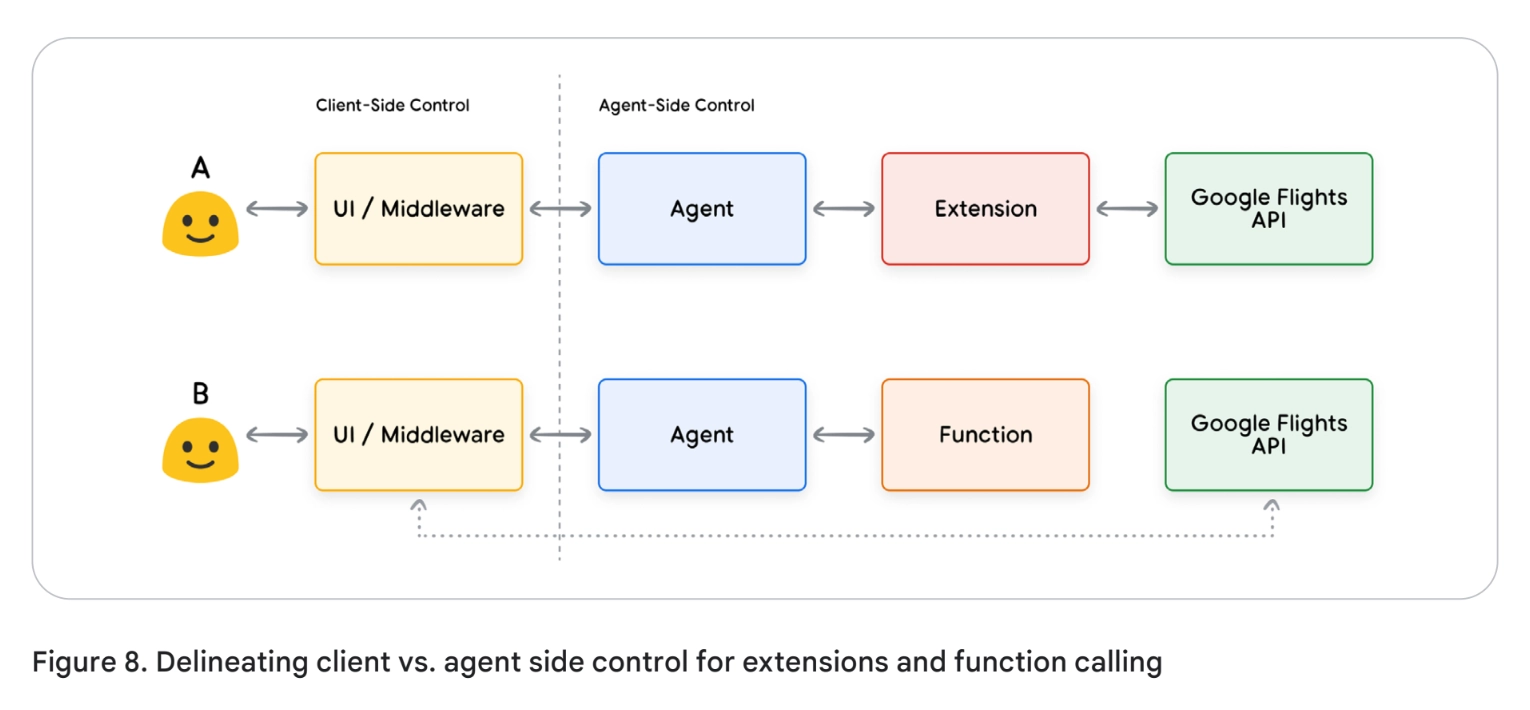
백서가 구분하는 Extensions와 Functions의 차이는 tool의 종류보다 실행 권한이 어디에 있는가에 가깝다.
- Extension은 agent runtime이 외부 API 호출과 결과 수신까지 처리한다.
- Function calling은 model이 함수 이름과 인자를 제안하고, client가 검증·승인·실행한 결과를 다시 돌려준다. Secret을 agent에 넘기지 않거나 결제·전송처럼 마지막 승인이 필요한 작업에 적합하다.
- Data store는 학습하지 않은 외부 지식을 조회하는 통로다. RAG는 이 역할의 대표적인 구현이다.
이 명칭과 경계는 Vertex AI의 분류이므로 다른 framework에서는 다르게 부를 수 있다. 일반화해서 남는 원칙은 model의 선택과 실제 side effect 사이에 권한·검증 경계를 둘 수 있어야 한다는 것이다.
Agent가 새로운 tool과 상황에 적응하는 방법은 prompt의 few-shot example, 현재 상황과 비슷한 example을 retrieval하는 in-context learning, parameter를 바꾸는 fine-tuning으로 나뉜다. 앞의 두 방법은 빠르게 바꿀 수 있지만 context 품질에 의존하고, fine-tuning은 느리지만 반복되는 행동을 model 자체에 학습시킨다.
2. Agents Companion: prototype을 운영 가능한 system으로 만들기
AgentOps는 기존 DevOps와 MLOps를 대체하는 이름이 아니다. Agent가 추가로 가진 goal·instruction, tool, orchestration, memory와 task decomposition을 versioning·testing·logging·security·metric의 대상으로 확장하는 운영 영역이다. API authentication, secret 관리, quota, exception handling과 scalability 같은 기존 software 원칙은 그대로 필요하다.
최종 답변과 trajectory를 따로 평가하기
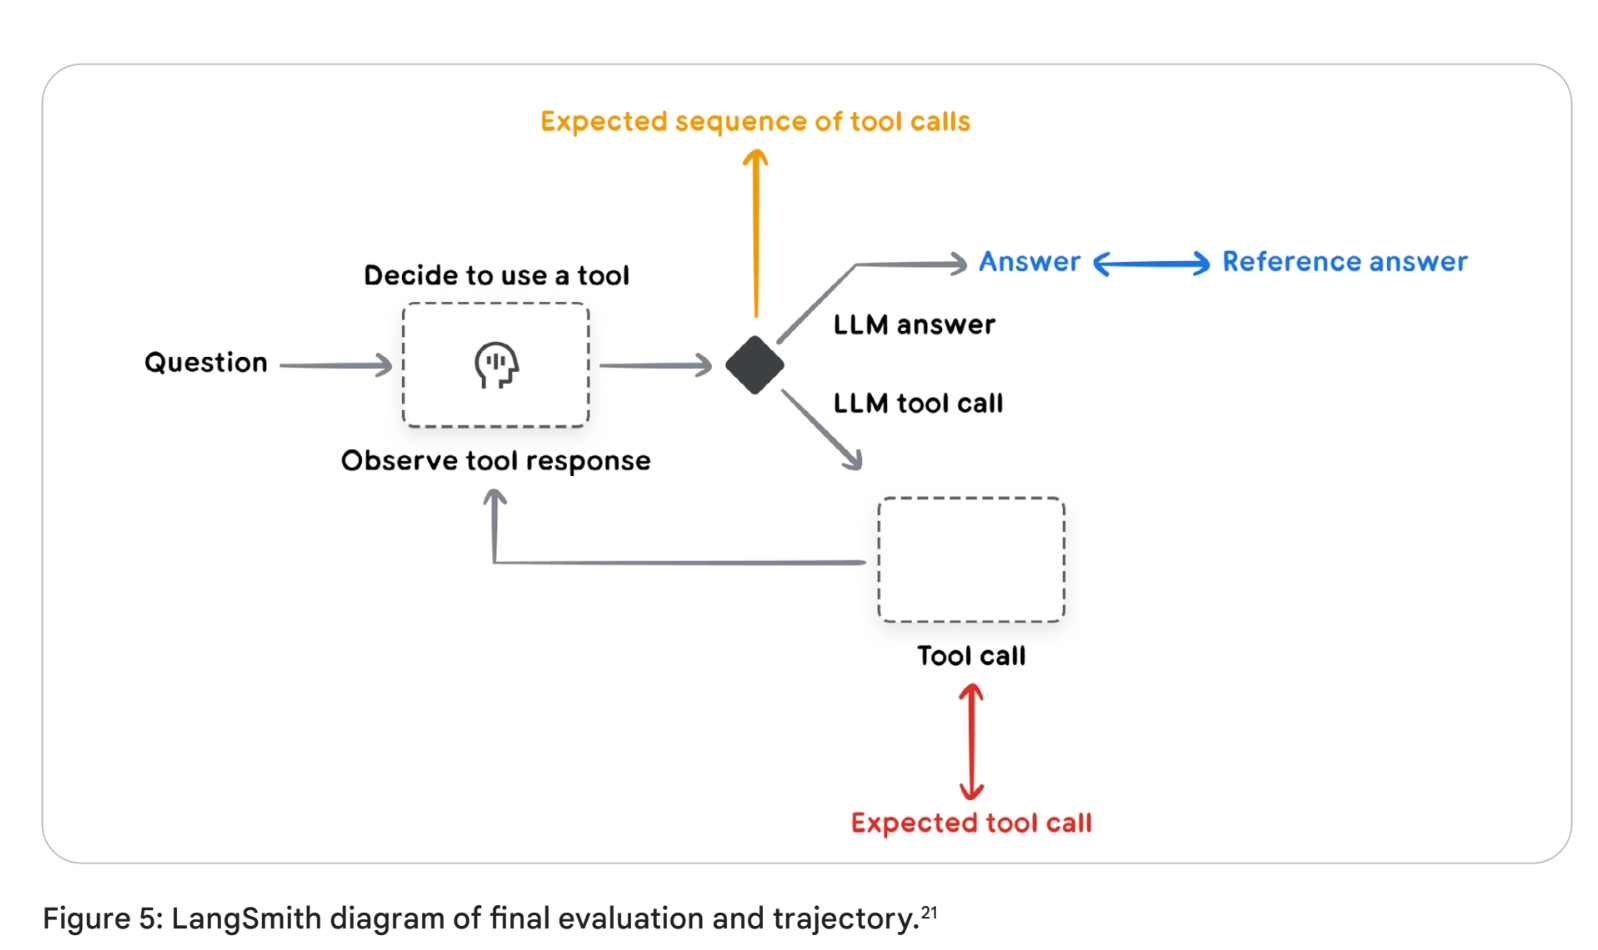
백서는 평가 대상을 세 층으로 나눈다.
- Capability: instruction 이해, reasoning, planning과 tool calling 자체의 능력
- Trajectory와 tool use: 선택한 tool, 실행 순서, 불필요한 action과 효율
- Final response: 최종 결과의 correctness, relevance와 품질
Reference trajectory가 있는 경우에는 요구 강도에 따라 다른 metric을 쓸 수 있다.
- Exact match는 action과 순서가 모두 같아야 한다.
- In-order match는 필요한 action의 순서를 지키면 추가 action을 허용한다.
- Any-order match는 순서와 추가 action을 허용하고 필수 action 포함 여부만 본다.
- Precision은 실제 call 중 필요했던 call의 비율, recall은 필요했던 call 중 실제로 수행한 비율이다.
- Single-tool use는 특정 tool이나 action이 경로에 포함됐는지 확인한다.
정답 경로가 여러 개인 과제에 exact match를 쓰면 올바른 대안을 오답으로 만들 수 있다. 반대로 최종 답만 평가하면 불필요한 API 호출, 우연히 맞은 결과와 위험한 우회 경로를 놓친다. 평가 metric은 과제에서 허용할 자유도에 맞춰 골라야 한다.
Agentic RAG
기존 RAG가 정해진 query로 한 번 검색하고 결과를 model에 넣는 pipeline이라면, agentic RAG는 retrieval을 tool로 취급한다. Agent가 검색 필요 여부와 data source를 고르고, query를 분해·확장하며, 결과가 부족하면 다시 검색하고 상충하는 내용을 검토한다.
여기서 agent를 추가하기 전에 먼저 확인할 것은 기본 search recall이다. 문서 parsing과 semantic chunking, metadata, embedding 또는 search adapter, reranking이 약하면 agent가 여러 번 검색해도 낮은 품질의 후보만 반복해서 받는다. Agentic loop는 retrieval 기반을 대신하지 않는다.
Agent를 contractor로 다루기
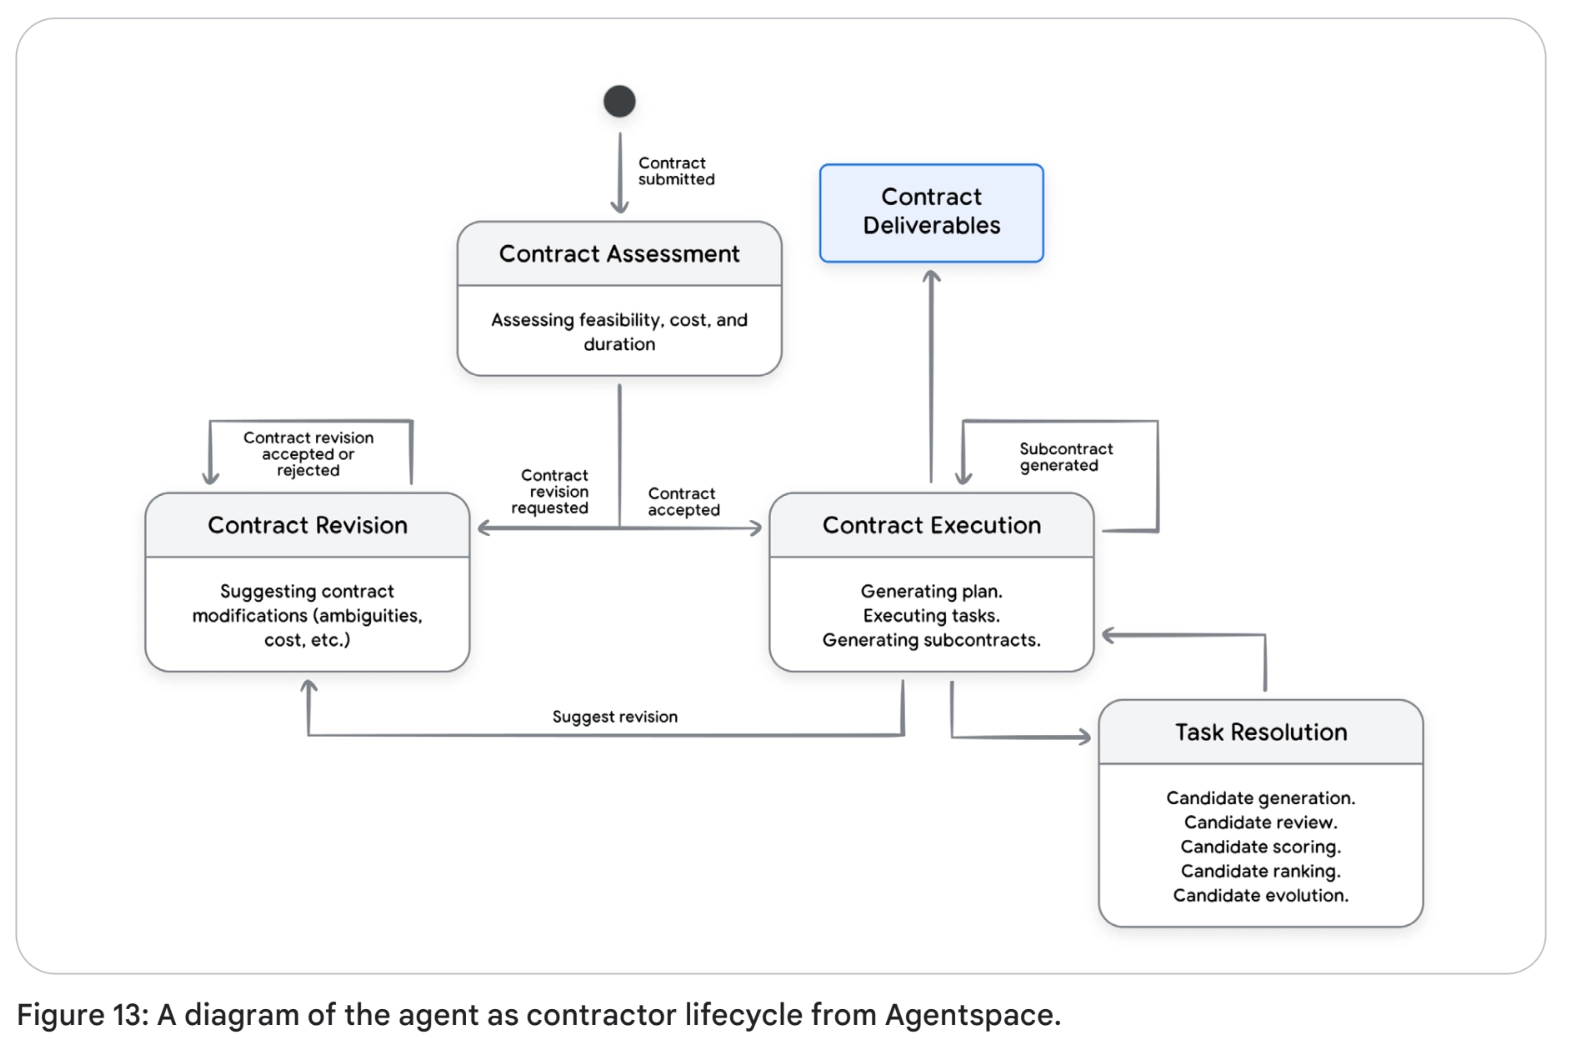
AI Contractor는 “목표와 tool을 주고 알아서 하라”는 느슨한 agent interface를 계약 형태로 구체화하자는 제안이다. Contract에는 task 설명뿐 아니라 다음 항목이 들어간다.
- 검증 가능한 deliverable과 acceptance criteria
- 수행 범위와 제외 범위
- 예상 cost와 duration
- 사용할 수 있는 input source
- 진행 보고와 feedback 방식
- 모호성, 위험, 추가 input과 비용을 다시 협상하는 절차
이 개념의 가치는 anthropomorphic한 “AI 직원” 표현보다, agent 작업을 검증 가능한 실행 사양으로 바꾸는 데 있다. 복잡한 일은 subcontract로 나눌 수 있지만, 각 하위 작업에도 범위·결과물·검증 기준이 이어져야 한다. 아직 널리 확립된 표준이라기보다 백서가 제시한 설계 방향이다.
Multi-agent topology
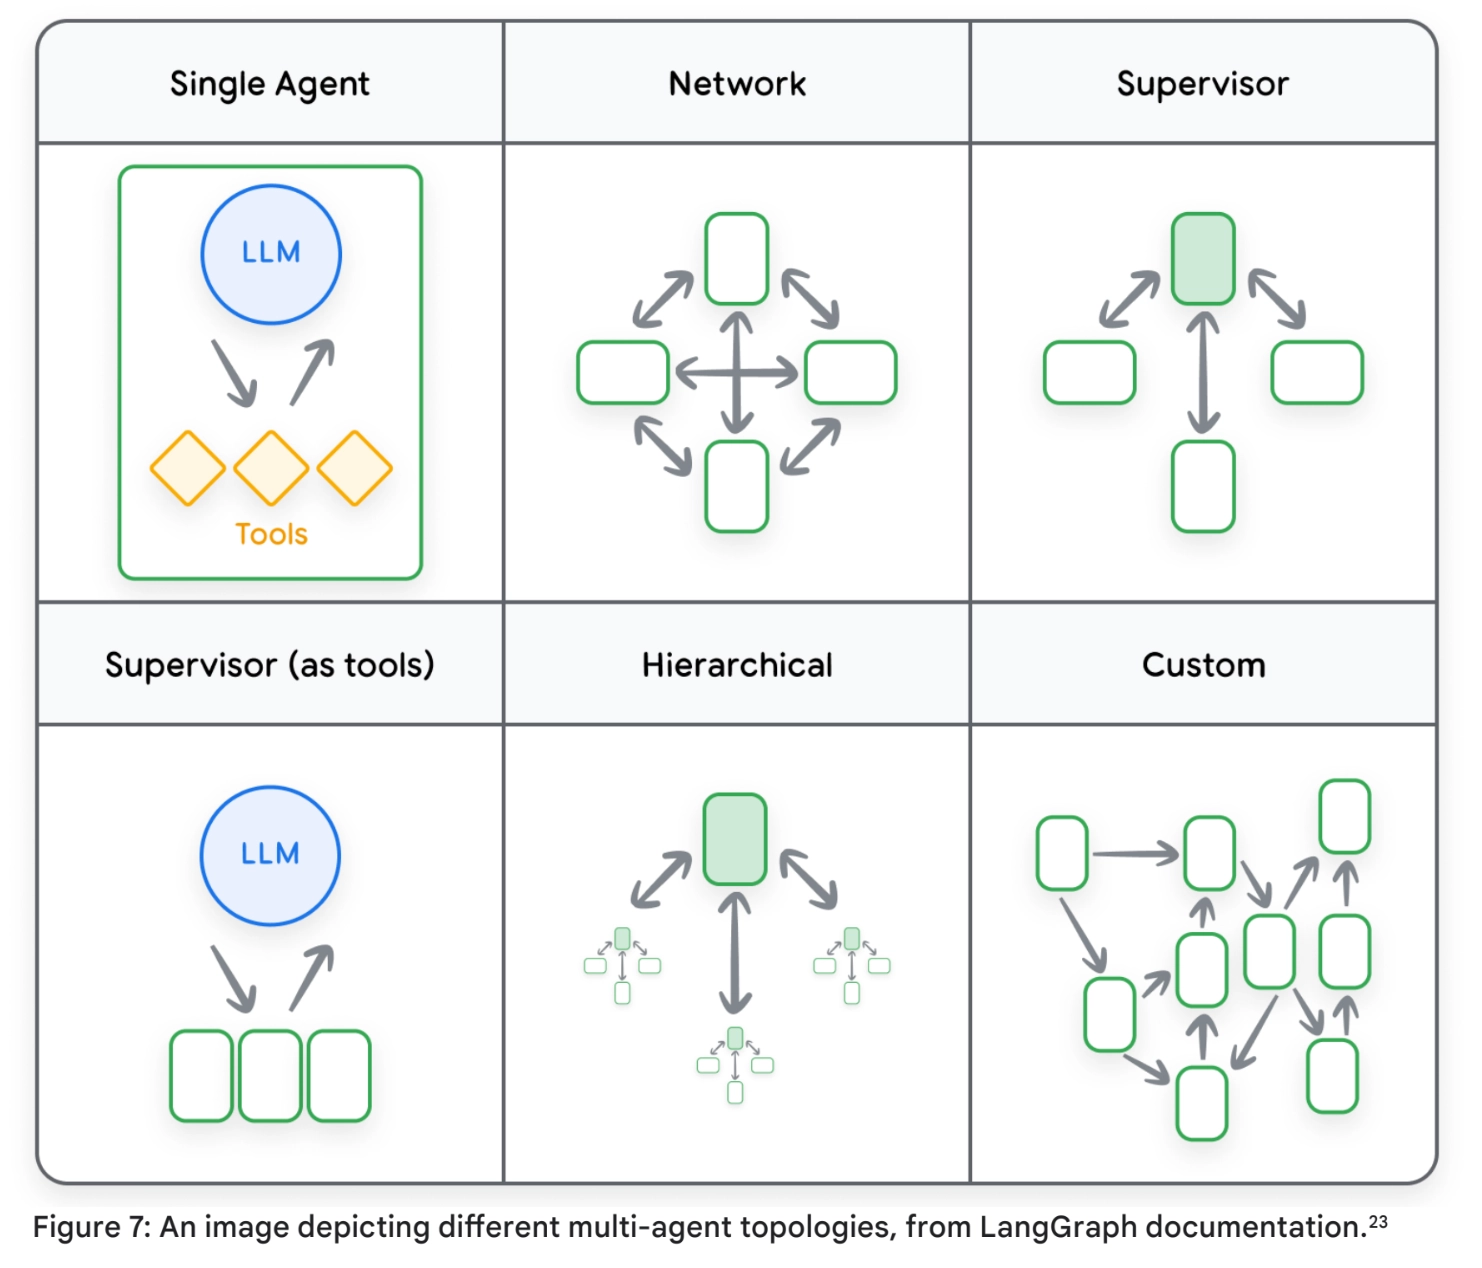
Hierarchical pattern은 중앙 orchestrator가 전문 agent로 routing한다. Diamond pattern은 전문 agent의 결과를 rephraser나 moderator가 다시 가공한다. Peer-to-peer handoff는 잘못 배정된 agent가 자신의 domain 밖임을 감지해 다른 agent로 넘기고, collaborative pattern은 여러 전문 응답을 response mixer가 합친다.
Agent 수를 늘리는 것 자체가 capability 향상을 보장하지 않는다. Routing 오류, 중복 call, context 전달 손실, latency와 평가 표면도 함께 늘어난다. 한 agent와 tool로 풀 수 있는 문제인지 먼저 보고, 실제로 역할·권한·context가 분리되어야 할 때 topology를 추가하는 편이 낫다.
3. Context Engineering: session과 memory를 설계하기
Context engineering은 system prompt를 잘 쓰는 것보다 넓다. 매 API call마다 instruction, tool definition, few-shot example, conversation history, state, long-term memory, RAG 문서, tool·sub-agent output과 artifact 중 무엇을 넣을지 선택하고 배치하는 일이다. 목표는 context를 많이 넣는 것이 아니라 현재 판단에 필요한 정보만 넣는 것이다.
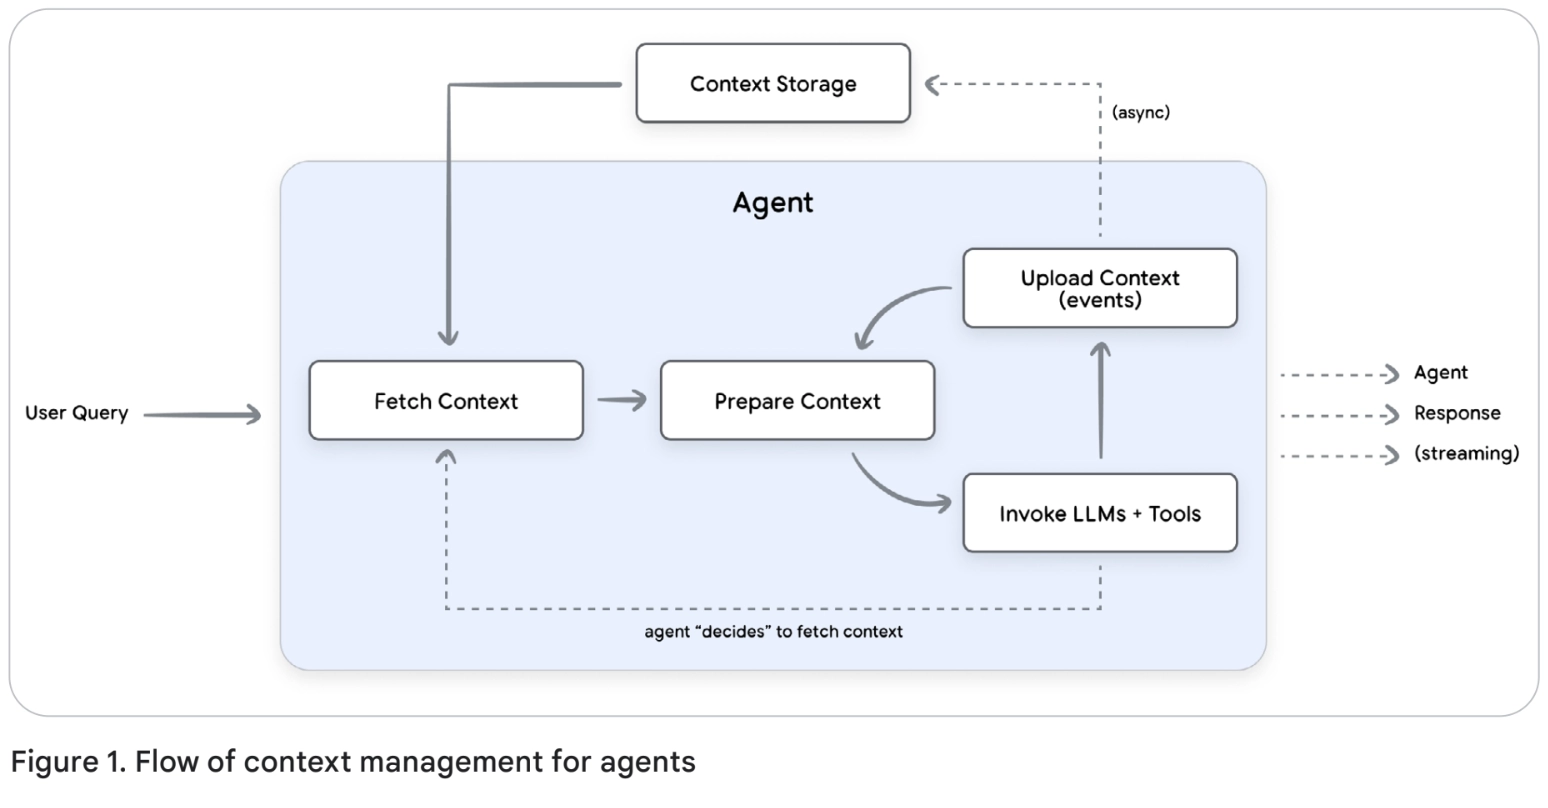
이 cycle은 네 단계로 볼 수 있다.
- Fetch: 현재 query와 metadata에 맞는 session event, memory와 외부 지식을 가져온다.
- Prepare: model call에 들어갈 context를 선택·정렬·압축한다. 응답 전에 끝나야 하는 hot path다.
- Invoke: LLM과 tool을 반복 호출하고 결과를 현재 context에 추가한다.
- Upload: 새 event와 memory 후보를 저장한다. Extraction과 consolidation처럼 비싼 작업은 비동기로 수행할 수 있다.
Session과 memory의 경계
| 구분 | Session | Memory |
|---|---|---|
| 시간 범위 | 하나의 연속된 대화나 작업 | 여러 session을 넘어 유지 |
| 내용 | 시간순 event와 현재 state·scratchpad | 추출·정제된 사실, 요약, 절차 |
| data 성격 | Framework에 가까운 raw log | Framework와 분리된 canonical data |
| 주요 경로 | 매 turn 읽고 쓰는 hot path | 비동기 생성 후 필요할 때 retrieval |
| 핵심 문제 | Context 길이, latency, 순서와 격리 | 중복, 충돌, stale data, provenance와 poisoning |
Session은 user message, agent response, tool call과 tool output을 event로 보관하고, 장바구니나 현재 sub-goal 같은 구조화 state를 함께 가진다. Production runtime이 stateless하다면 이 기록은 외부 session store에 저장해야 하며 사용자별 access control과 event 순서를 보장해야 한다.
대화가 길어질 때는 최근 N turn만 유지하는 sliding window, token budget 안에서 오래된 message를 자르는 truncation, 이전 대화를 요약으로 바꾸는 recursive summarization을 쓸 수 있다. 요약은 정보 손실과 추가 비용이 있으므로 token·turn 수, idle time, task 완료 같은 trigger에 맞춰 실행하고 결과를 저장해 반복 계산을 피한다.
Memory는 능동적인 ETL pipeline이다
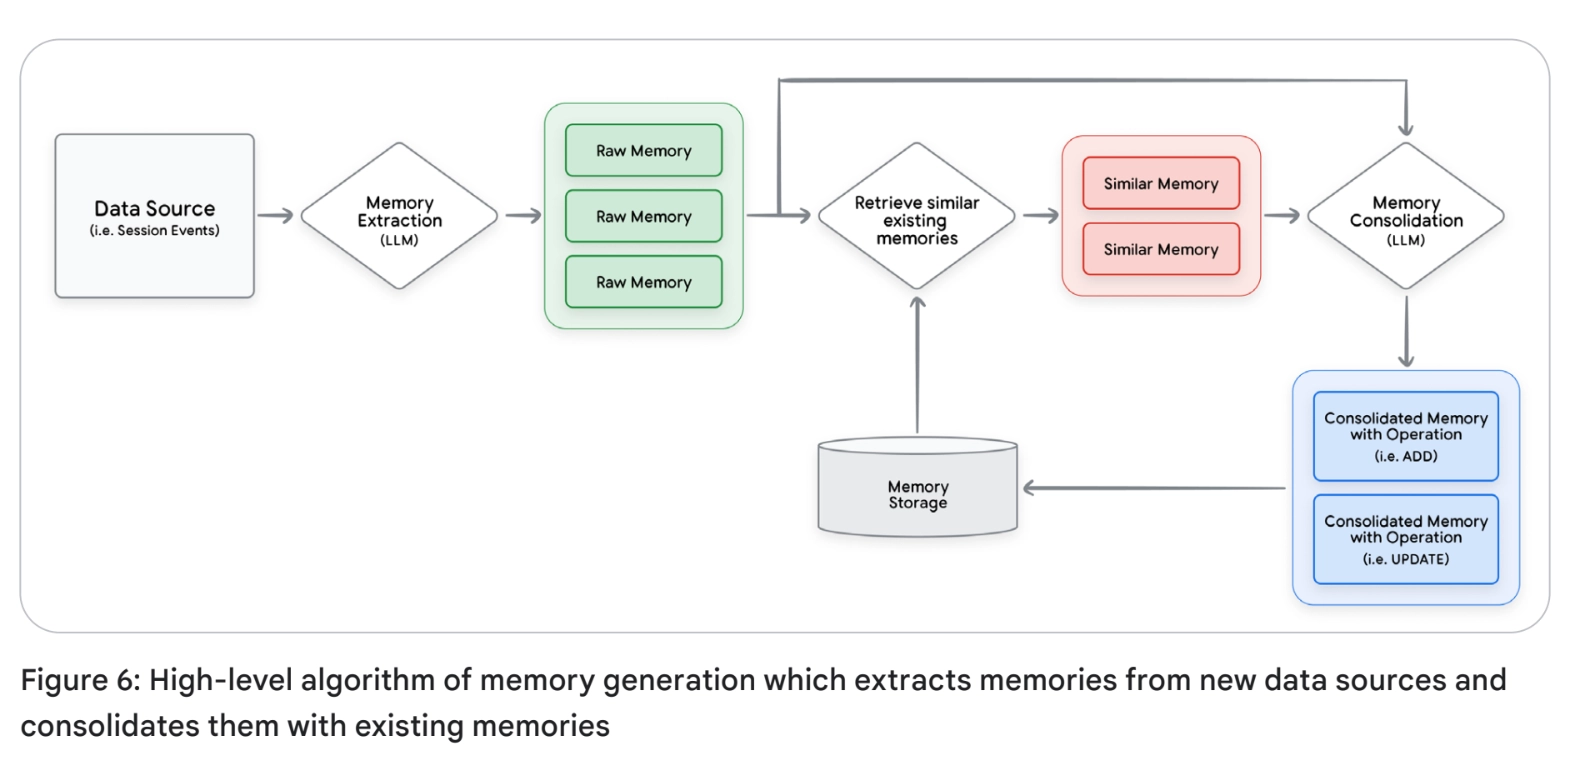
Memory manager는 passive vector database가 아니다. 일반적인 lifecycle은 다음과 같다.
- Ingestion: conversation이나 다른 data source를 받는다.
- Extraction과 filtering: agent의 목적에 맞는 topic만 골라 memory 후보로 만든다. 잡담을 전부 저장하지 않는다.
- Consolidation: 기존 memory와 비교해
CREATE,UPDATE,DELETE/INVALIDATE를 결정하고 중복·충돌·변화를 정리한다. - Retrieval: 현재 query와 user에 필요한 memory만 context에 넣거나 tool로 조회한다.
RAG와 memory는 모두 retrieval을 쓰지만 목적이 다르다. RAG는 주로 공유되는 외부 사실을 읽어 agent를 주제의 전문가로 만들고, memory는 대화에서 생긴 동적·개인별 정보를 갱신해 agent를 사용자와 진행 중인 일의 전문가로 만든다. 그래서 memory는 강한 user isolation과 write policy가 필요하다.
Provenance와 망각
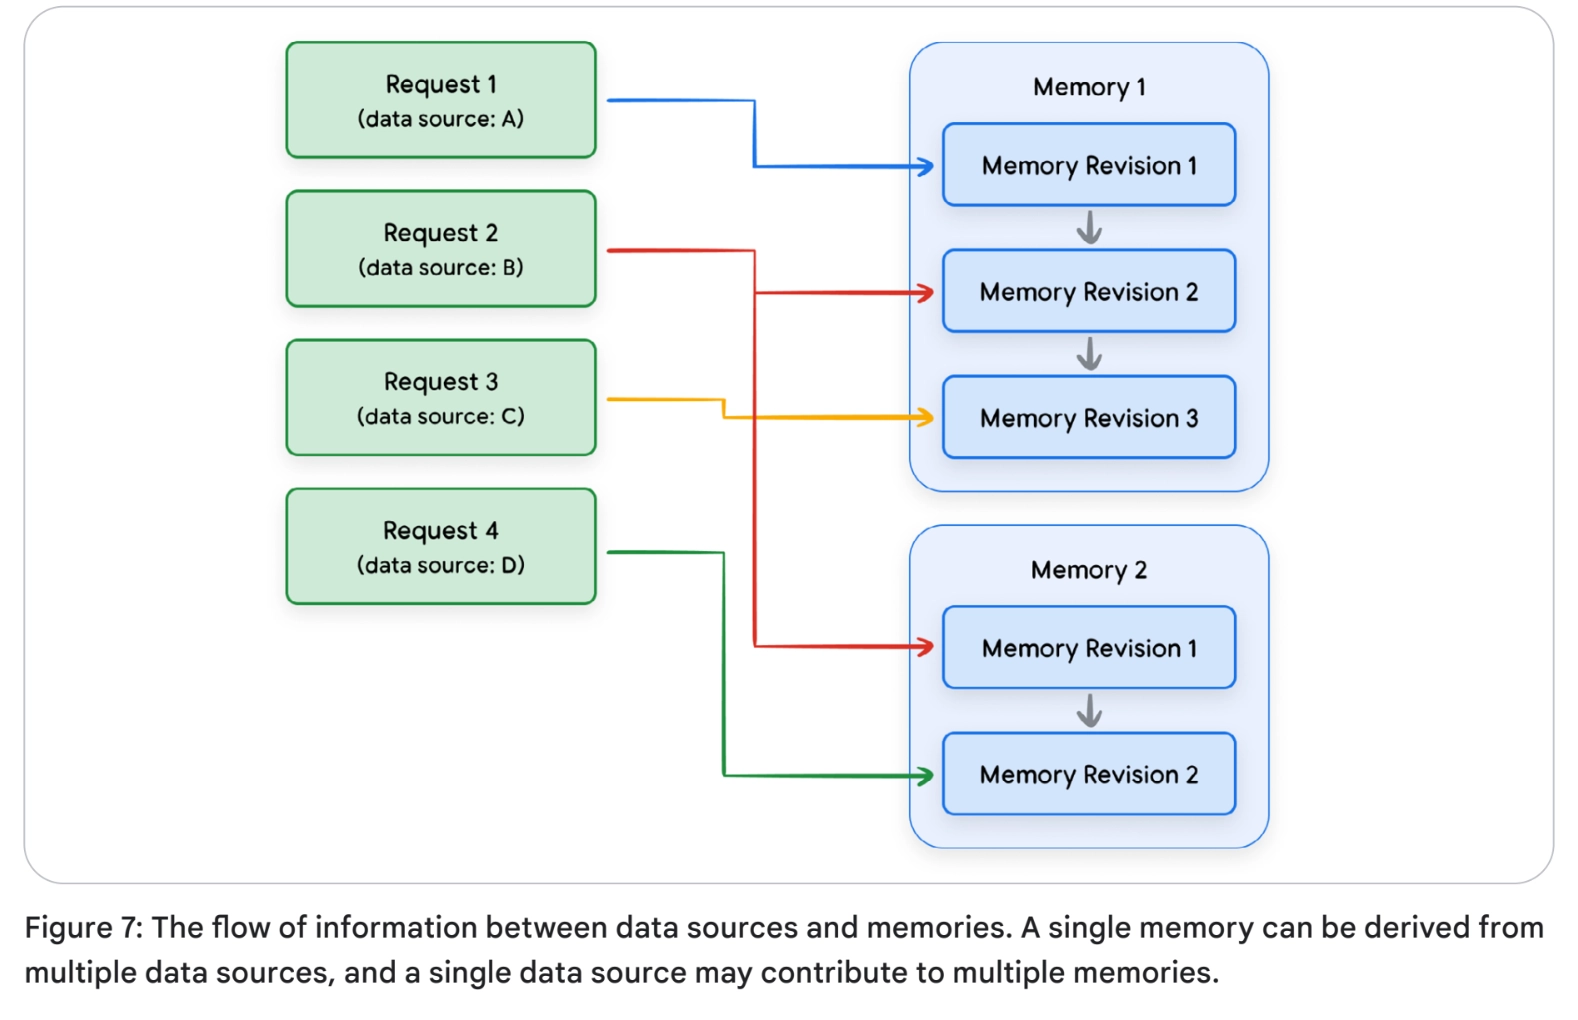
Memory마다 source type과 freshness를 추적해야 한다. 내부 system에서 넣은 bootstrapped data, 사용자가 명시적으로 제공한 정보, 대화에서 model이 추론한 정보, tool output은 신뢰도와 수명이 다르다. 특히 tool output은 바뀌기 쉬워 장기 memory보다 단기 cache나 재조회가 적합할 수 있다.
새 정보가 기존 기억과 충돌하면 더 신뢰할 수 있는 source, 최신성, 여러 source의 corroboration을 함께 본다. Source 접근 권한이 철회되면 그 source에서 파생된 memory도 찾아 제거하거나, 남은 source만으로 다시 생성해야 한다. 오래되거나 신뢰도가 낮고 더 이상 목표와 관계없는 memory는 decay·pruning으로 잊어야 한다.
Declarative memory와 procedural memory
Declarative memory는 이름·선호·사건처럼 “무엇을 아는가”를 저장한다. Procedural memory는 어떤 순서로 tool을 쓰고 실패를 어떻게 복구하는지처럼 “어떻게 하는가”를 저장한다.
Procedural memory는 성공한 interaction에서 재사용 가능한 strategy나 playbook을 추출하고, 기존 절차의 잘못된 step을 고치거나 낡은 방법을 버린 뒤, 다음 유사 과제에서 실행 계획으로 불러온다. Model weight를 바꾸는 fine-tuning보다 빠르게 갱신할 수 있지만, 잘못된 성공 사례를 일반화하지 않도록 실행 결과와 검증 기준을 함께 보존해야 한다. 오늘날의 agent skill과 자기개선 workflow는 이 procedural memory를 파일과 실행 규칙으로 외부화한 형태로 볼 수 있다.
세 문서가 옮긴 초점
첫 백서는 function calling과 ReAct로 대표되는 tool-use loop를 하나의 agent runtime으로 묶는다. 두 번째 백서는 그 비결정적 runtime에도 software engineering의 testing·observability·권한 관리가 필요하며, 평가 단위가 output에서 trajectory로 넓어진다고 본다. 세 번째 백서는 agent 품질의 병목을 prompt 문구에서 매 turn 조립되는 data와 state architecture로 옮긴다.
이 흐름에서 agent engineering은 “더 똑똑한 model을 고르는 일”에서 “model이 어떤 정보와 권한을 가지고 어떤 경로로 행동하는지 설계하는 일”로 확장된다. Memory도 저장 용량의 문제가 아니라 무엇을 믿고, 어떻게 갱신하고, 언제 잊을지를 정하는 지식 관리 문제가 된다.
읽을 때 주의할 점
- 세 문서는 연구 논문보다 개발자용 architecture guide에 가깝다. 제시된 pattern과 기대 효과를 통제 실험의 결론처럼 읽으면 안 된다.
- Extensions, Agent Engine, Memory Bank 같은 이름은 Google 제품 문맥에 속한다. Tool 권한 경계, session과 memory의 분리, extraction·consolidation 같은 일반 원칙과 구분해야 한다.
- Reference trajectory 평가는 정답 경로를 미리 정의할 수 있을 때 강하다. 탐색적 과제나 여러 해법이 허용되는 문제에는 느슨한 metric과 결과 평가가 함께 필요하다.
- Multi-agent는 역할 분리가 실제로 필요한 경우에만 이득이 있다. 통신과 routing이 늘수록 failure mode와 비용도 늘어난다.
- Memory는 personalization을 높이는 동시에 개인정보 유출, 잘못된 추론의 고착, stale data와 memory poisoning을 만든다. 저장 전 filtering, user isolation, 삭제 권한과 provenance가 기능 자체보다 먼저 설계되어야 한다.
참고 자료
공유하기
X LinkedIn'AI' 카테고리의 다른 글

댓글남기기